Context Engineering:系统化设计模型输入的工程方法论
Context Engineering:系统化设计模型输入的工程方法论
Asaakii本文是「Agent 基础与工程」系列专栏的第 13 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在早期的大模型应用中,开发者习惯将大量精力投入在“如何写出一段完美的 Prompt”上。但在复杂、长周期的 Agent 系统中,静态提示词能解决的问题非常有限。同一个大模型,在面对同一道业务指令时,表现可能天差地别:
- 输入 A:仅输入单条用户问题
帮我分析这几个微服务的性能瓶颈,模型往往给出宽泛泛化的教科书套话; - 输入 B:在上下文组装期注入当前集群环境元数据、最近 5 分钟的 CPU 异常采样指标、拓扑依赖图、历史成功排障经验,以及当前可用的只读工具 Schema,模型能一针见血地锁定故障根因。
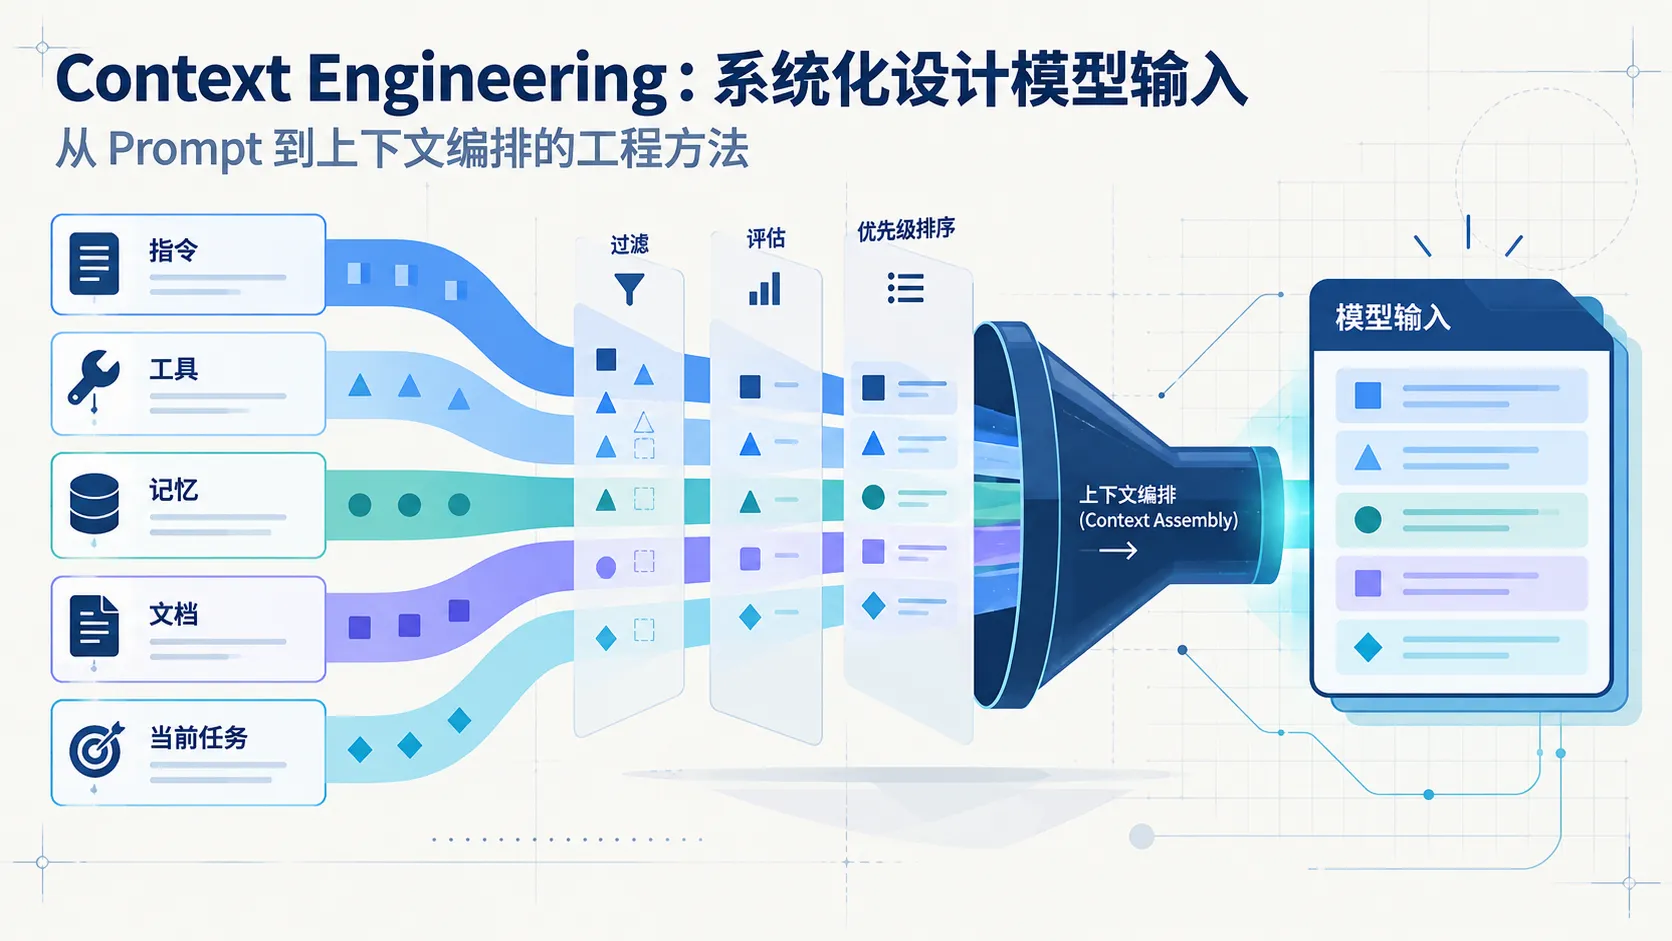
这种差异不是基座模型参数的差异,而是上下文供给质量的差异。Context Engineering(上下文工程)是将大模型的单次推理输入作为动态信息供给链,系统化设计信息的过滤、装配、排序与生命周期流转的工程方法论。
概念升维:从 Prompt 到 Context
Prompt Engineering 与 Context Engineering 处于不同的架构抽象层级:
| 维度 | Prompt Engineering(提示词工程) | Context Engineering(上下文工程) |
|---|---|---|
| 关注范畴 | 单次调用的自然语言文本(措辞、语气、Few-shot 样例) | 支撑整个决策生命周期的动态数据流水线 |
| 数据属性 | 静态居多,通常在代码中硬编码或配置于模板中心 | 高度动态,根据当前运行期状态、外部环境与权限实时计算装配 |
| 信息来源 | 开发者编写的指令 | 静态规则 + 运行时元数据 + 状态机进度 + 向量检索切片 + 渐进式技能文档 |
| 核心挑战 | 词不达意、模型不听指令 | 注意力稀释(Attention Dilution)、Token 预算超限、信息信噪比失衡 |
静态 Prompt 只是 Context 装配流水线的一个初始片段。Context Engineering 负责调度全局信息流。
生产级上下文的五层黄金结构
为了使大语言模型在多步推理中始终维持高度清醒的决策状态,上下文应遵循清晰的分层布局:
  flowchart TD
    subgraph ContextAssembly ["动态上下文装配流 (Top-Down Assembly)"]
        L1["Layer 1: 核心身份与安全基线 (Core Persona & Safety Anchors)<br/>【固定在最顶部,永远不被裁剪】"]
        L2["Layer 2: 运行时环境状态栏 (Runtime Environment Metadata)<br/>【时间戳、操作系统、工作区路径、步数预算消耗】"]
        L3["Layer 3: 渐进式技能文档 (Progressive Skills)<br/>【根据当前任务按需动态挂载的领域 SOP】"]
        L4["Layer 4: 结构化状态机与已确认事实 (Active State & Facts)<br/>【当前子目标、已完成步骤、全局变量表】"]
        L5["Layer 5: 近期工作轨迹与观测数据 (Working Trace & Observations)<br/>【经过清洗修剪的工具调用返回日志】"]
    end
    L1 --> L2 --> L3 --> L4 --> L5
1. 运行时状态栏(Status Line)的注入技巧
大模型不具备对真实物理世界时间的感知能力,也无法原生获知外部系统的资源开销。在 Layer 2 注入一段紧凑的环境元数据,能够极大降低模型的无序探索:
1 | <runtime_environment> |
当模型在每轮输入中明确感知到 step_used: 8 / 10 时,它会主动收敛发散的探索行为,倾向于尽快聚合已有信息交付结论。
渐进式披露:Skills 体系的按需挂载
传统设计中,开发者常将几十个业务工具的长篇说明与数百条规章制度全量写入 System Prompt,这会导致两项严重后果:
- Prompt Cache 频繁失效:体积庞大且经常变动的 System Prompt 破坏了 KV Cache 的命中率,显著抬高推理成本与 TTFT;
- 上下文污染(Context Pollution):大量与当前任务无关的规章切片冲淡了模型的注意力焦点。
工程解法:渐进式披露(Progressive Disclosure)。
  sequenceDiagram
    participant H as Agent Harness
    participant M as LLM
    participant FS as Skills 存储库

    Note over H,M: 阶段 1: 极简注册 (仅暴露名称与简述)
    H->>M: 仅下发技能索引清单: ["git-workflow: 分支管理规章", "sql-optimizer: 慢查询调优"]
    M->>H: 我需要执行复杂的分支合并,申请挂载技能: "git-workflow"

    Note over H,M: 阶段 2: 按需动态展开 (Deep Hydration)
    H->>FS: 读取 git-workflow/SKILL.md
    FS-->>H: 返回 2000 字的详细 SOP 与专属规范
    H->>M: 将 SKILL.md 动态注入 Layer 3 工作区
    M->>H: 严格按详细 SOP 执行后续操作
系统在初始状态下仅暴露低成本的技能“目录索引”;只有当模型通过意图推断明确需要某一领域的专门能力时,才触发二级工具加载详细规范文档,实现工作集的按需最小化。
U 型注意力曲线治理(Attention Mitigation)
多项学术研究与工程实践均证实,现代 Transformer 模型在处理超长上下文时存在显著的“中间迷失(Lost in the Middle)”效应:模型对**头部(Prompt 起始位置)和尾部(最新输入位置)**的注意力权重极高,而位于上下文躯干中段的信息极易被忽略或检索遗漏。
针对这一特性的工程编排原则包括:
- 硬性约束头部化:不可违背的安全铁律、禁止调用的高危命令必须牢牢锚定在 Layer 1 头部;
- 核心目标与最新指令尾部置底:在发送给模型的
messages最后一项,重新追加一句简明扼要的当前任务强调(例如:请根据上述数据,严格输出格式化 JSON 并退出),确保其处于注意力焦点的最强区域; - 中间躯干压缩化:位于中间的历史工具调用输出,超过 3 轮以上的必须做摘要折叠,防止废弃的中间日志占领核心注意区。
生产级 Context Assembler 实现
以下使用 Python 原生实现一个包含分层装配、状态栏元数据注入与长度预算控制的上下文编排器:
1 | import datetime |