
多模态与实时交互 Agent:Voice、Computer Use 与快慢解耦范式
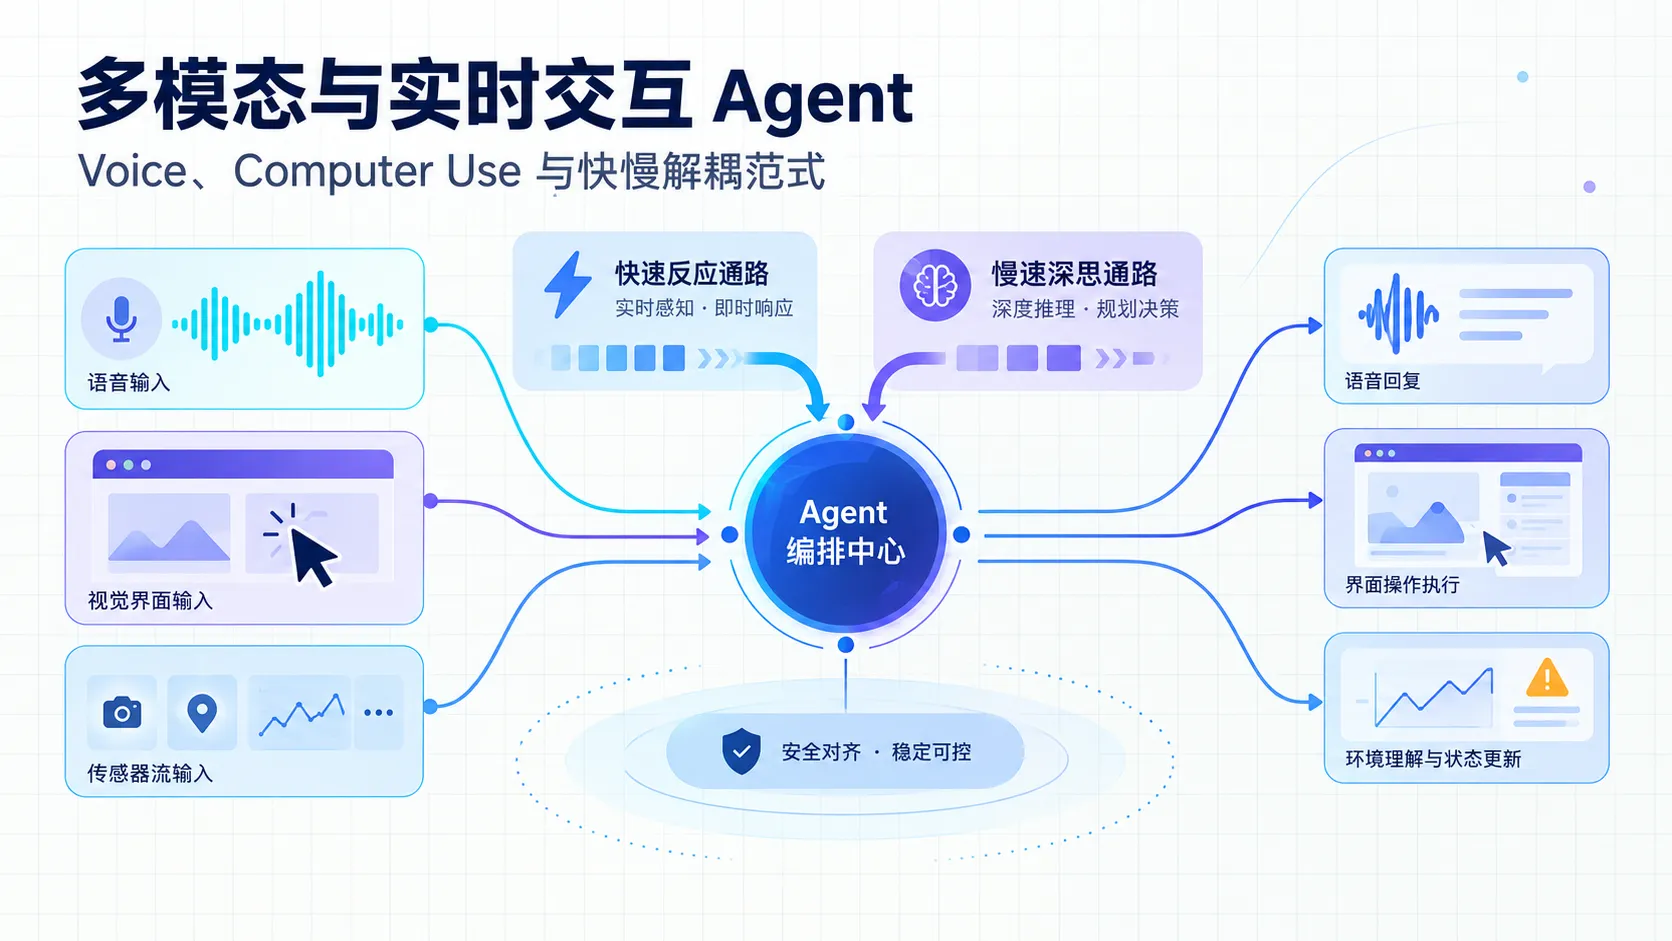
多模态与实时交互 Agent:Voice、Computer Use 与快慢解耦范式
Asaakii本文是「Agent 基础与工程」系列专栏的第 14 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
当 Agent 系统的交互媒介从纯文本扩展至实时语音(Voice)与图形用户界面(Computer Use / GUI)时,底层的工程约束发生了本质变化。
在纯文本场景中,两到三秒的推理等待对用户是完全可接受的;但在实时语音对话中,超过 800 毫秒的端到端延迟就会引发严重的交流停顿感,用户在说话中途的打断(Barge-in)需要系统在百毫秒内做出静音响应。在桌面与网页 GUI 操作中,每一步截取全高清图像不仅消耗大量昂贵的视觉 Token,而且微小的像素坐标漂移就会导致鼠标误触。
多模态 Agent 绝非在文本模型外侧简单封装语音或截图接口,而是需要重新设计低延迟感知、异步打断与快慢系统解耦的控制流。
Voice Agent 的三种架构演进路径
构建面向实时音频的智能体,业界主要存在三种范式:
  flowchart TD
    subgraph P1 ["1. 级联流水线架构 (Cascaded Pipeline)"]
        A1[用户音频] --> VAD1[VAD 声音检测] --> ASR1[ASR 语音转字] --> LLM1[文本模型推理] --> TTS1[TTS 文字转音] --> Out1[输出音频]
    end

    subgraph P2 ["2. 原生端到端架构 (Native Omni)"]
        A2[用户连续音频流] --> Omni[端到端多模态大模型 (Audio-to-Audio)] --> Out2[低延迟音频流]
    end

    subgraph P3 ["3. 全双工快慢解耦 (Full-Duplex Fast-Slow) 【生产推荐】"]
        A3[双工音频流] --> Fast[快系统: VAD + 打断检测 + 实时垫字]
        Fast -->|结构化语义| Slow[慢系统: 深度推理 + 工具调用 + 业务流]
        Slow -->|下发决策| Fast
        Fast --> Out3[自适应音频流]
    end
三种方案的工程权衡矩阵
| 架构形态 | 端到端延迟 | 工具调用与状态控制 | 打断体验 (Barge-in) | 调试与可观测性 |
|---|---|---|---|---|
| 级联型 (Cascaded) | 高( |
极强(与传统文本 Agent 基础设施 100% 兼容) | 依赖外部音频路由器强制停止 TTS 播放 | 极佳(各阶段文本与时间戳清晰可查) |
| 端到端 (Omni) | 极低( |
较弱(复杂业务工具调用的参数准确率不稳定) | 模型原生支持边听边说 | 极难(缺乏中间可读文本,难以定位幻觉) |
| 快慢解耦 (Fast-Slow) | 均衡(感知首字 |
强(慢系统独立跑工具调用与状态机) | 快系统拦截音频并发出物理 Cancel 信号 | 良好(快慢系统通过结构化事件协议通信) |
语音核心挑战:打断机制(Barge-in)工程实现
在真实对话中,人类经常在智能体尚未说完整句话时切入打断。若系统缺少低延迟打断机制,模型会无视用户的打断继续喋喋不休地播报 TTS 音频。
生产级打断处理的控制状态机如下:
  stateDiagram-v2
    [*] --> Listening: 客户端打开麦克风流
    Listening --> UserSpeaking: VAD 检测到有效人声 (>150ms)
    UserSpeaking --> Processing: 用户停顿超过静音阈值 (600ms)
    Processing --> Responding: LLM 生成 Token,TTS 开始推流音频

    Responding --> Interrupted: TTS 播放期间 VAD 再次检测到人声
    Interrupted --> Listening: 立即下发 Cancel 截断 TTS 缓冲区并清空队列
    Responding --> Listening: 音频正常播报完毕
- 防误触阈值(Debounce):用户咳嗽、清嗓子或环境背景杂音不能触发打断。VAD 必须设定连续人声能量持续至少
- 物理截断(Drain & Cancel):一旦确认打断,客户端音频播放器必须在毫秒级将本地声卡缓冲区清空(Drop Audio Buffer),服务端 Harness 同步向正在生成的 LLM 与 TTS 任务发送
AbortSignal,停止后续计费并记录当前对话被截断的历史断点。
Computer Use / GUI Agent 核心范式
让 Agent 直接接管操作系统或浏览器屏幕,主要依赖截屏感知(Perception)与输入模拟(Action Execution)。
1. 目标定位:绝对坐标 vs 标号标记法(Set-of-Marks)
  flowchart LR
    subgraph M1 ["方案 A: 纯视觉绝对像素坐标预测"]
        S1[高分辨率截屏 1920x1080] --> LLM_A[模型直接输出: click(x=452, y=831)]
    end

    subgraph M2 ["方案 B: 标号标记法 (Set-of-Marks, SoM) 【推荐】"]
        S2[截屏] --> OCR[OCR / 目标检测 / DOM 提取]
        OCR --> Overlay[在元素上方绘制带数字的标记框 (Tag 1..N)]
        Overlay --> LLM_B[模型输出: click(element_id=14)]
    end
- 纯绝对坐标预测:直接让多模态模型预测
坐标。该方案对模型视觉空间定位精度要求极高,高分辨率屏幕(如 4K)缩放时容易出现几个像素的微小偏移导致误触; - 标号标记法(Set-of-Marks, SoM):在截屏送入模型前,通过脚本提取当前界面上的所有交互控件,并在控件上叠加数字编号的醒目标签(Bounding Box with ID)。模型只需输出点击
Tag 14,宿主程序根据预先记录的标记字典完成点击。定位准确率显著高于绝对坐标。
2. 视觉 Token 压缩与降维
全分辨率截屏单张图像通常消耗
工程防护措施:
- 动态降分辨率:将原始截图等比压缩至短边
- 视觉历史折叠:仅在当前最新的第
步保留完整的高清截图,历史步骤(Step 已点击坐标 (320, 480),页面完成跳转)。
快慢系统解耦架构实战
在多模态系统中,最稳健的架构是快慢双系统协同:
- System 1(快系统,边缘运行,
):部署轻量模型或专用模块,处理本地音频 VAD、光标移动防抖、即时口语应答垫字(“好的,我正在为您查询订单流水…”); - System 2(慢系统,云端运行,几秒至数十秒):承载大型多模态思考模型,负责多步骤规划、数据分析与数据库交互。
1 | import asyncio |
系列导航与参考
喜欢这篇文章的人也看了
评论
匿名评论隐私政策
✅ 你无需删除空行,直接评论以获取最佳展示效果





