
Workflow 和 Agent 的区别:理清工作流、LLM App 与智能体的工程边界
Workflow 和 Agent 的区别:理清工作流、LLM App 与智能体的工程边界
Asaakii本文是「Agent 基础与工程」系列专栏的第 2 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
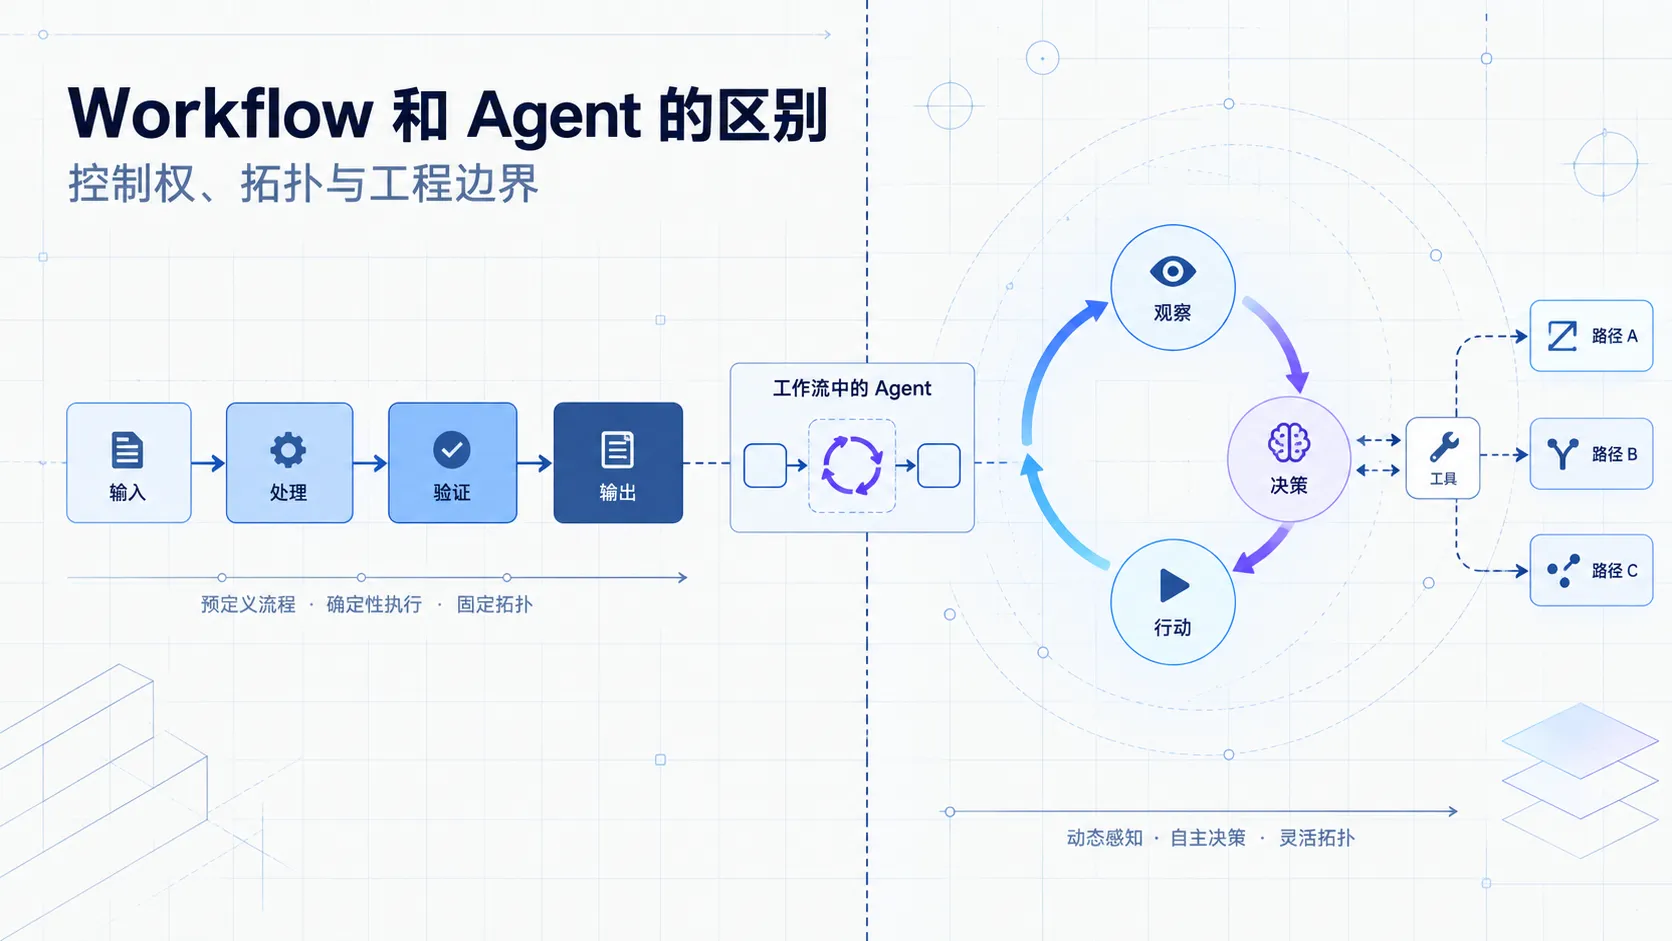
包含多个步骤、调用了模型并使用了工具的系统,常被统一称为 Agent。但在架构设计上,普通 LLM 应用、工作流(Workflow)与智能体(Agent)的控制权拓扑和适用场景有明确的边界。
分清这三者的分工,有助于在技术选型时避免把简单流程复杂化,或在需要动态决策的场景下把路径写死。
拓扑特征与控制权
从控制论与计算图的角度看,这三类系统的执行拓扑与路由控制权存在本质差异:
1. 普通 LLM 应用(开环单次调用)
- 拓扑特征:单次请求,单次生成,无状态流转与环境交互。
- 定位:类似纯函数。适合文本润色、翻译、单次信息提取等单轮任务。
  flowchart LR
    A["输入数据 (Prompt)"] --> B["大模型推理 (LLM)"] --> C["输出结果 (Response)"]
2. 工作流 Workflow(确定性有向无环图 DAG)
- 拓扑特征:执行路径由代码预先定义的有向无环图(DAG)固定,不存在模型自主发起的未定义分支。
- 控制权归属:归属于代码。步骤流转、条件分支判断和重试策略全部写在代码逻辑里。
- 模型定位:模型充当节点上的数据处理器或单步分类器,无权自行创建新节点或跳出预设图结构。
- 适用场景:发票合规核验、工单分类流转、格式化报表生成等流程明确的流水线业务。
  flowchart TD
    A["输入数据"] --> B["步骤 1: 字段提取"]
    B --> C{"业务规则分支判断"}
    C -->|"命中条件 A"| D["步骤 2A: 摘要提取"]
    C -->|"命中条件 B"| E["步骤 2B: 格式转换"]
    D --> F["步骤 3: 格式化聚合交付"]
    E --> F
3. 自主智能体 Agent(动态状态闭环)
- 拓扑特征:执行路径在运行期动态生成。系统接收目标与可用工具集合,由模型根据工具返回的真实观测数据现场推断下一步动作。
- 控制权归属:路由决策权移交给了模型;宿主代码负责沙箱环境隔离、参数校验、状态维护与循环熔断。
- 适用场景:代码缺陷定位修复、复杂故障排查、开放式技术调研等搜索空间广阔且路径无法预先穷举的探索型任务。
  flowchart TD
    Goal["用户任务目标 (Goal)"] --> Context["装配工作上下文 (Context)"]
    Context --> Decision{"模型决策中枢 (LLM)"}
    Decision -->|"发起外部动作"| Tool["分派工具执行 (Tools)"]
    Tool --> Obs["获取环境观测 (Observation)"]
    Obs --> State["更新状态机 (State)"]
    State --> Context
    Decision -->|"目标完成收敛"| Out["交付最终结论 (Output)"]
代码对照:控制权如何在代码中体现
以“分析代码文件中的并发死锁隐患并给出修复建议”为例,对比两者的实现方式。
方式 1:工作流实现(步骤写死)
1 | def run_code_review_workflow(file_path: str): |
在这段工作流代码中,无论实际情况多复杂,流程严格按照“读文件
方式 2:智能体实现(模型按需决定步骤)
1 | def run_code_review_agent(goal: str): |
在 Agent 模式中,如果模型在当前文件中看到 import lock_utils,它可以主动调用 search_symbol('lock_utils') 进一步排查,并在给出修复前调用 run_tests 执行单元测试。执行了几步、调用了哪些工具,由运行时的探索反馈驱动。
工程对比与权衡
架构选型本质上是在确定性与灵活性之间权衡:
| 维度 | 工作流(Workflow) | 智能体(Agent) |
|---|---|---|
| 执行确定性 | 高。步骤固定,容易做单步异常兜底与重试。 | 波动较大。模型决策存在随机性,需要设置熔断护栏。 |
| 灵活性与容错 | 低。超出预设规则的异常输入通常直接报错。 | 高。遇到非预期报错时,可在循环中换用其他工具尝试自愈。 |
| 成本与延迟 | 稳定可测。调用轮数和 Token 消耗在上线前即可基本估算。 | 波动范围大。探索轮数取决于任务难度与报错情况。 |
| 调试与排查 | 直观。日志中节点流转清晰,复现成本低。 | 相对复杂。依赖完整的会话消息轨迹回放。 |
复合模式:工作流骨架嵌装智能体
实际业务开发中,纯工作流与纯智能体并不是对立的,常见做法是结合两者优势的混合架构:
  flowchart TD
  subgraph WorkflowLayer["外层:确定性业务工作流"]
    A["接收工单"] --> B["鉴权与参数校验"]
    B --> C{"复杂度判断"}
    C -->|"常规标准化任务"| D["固定规则流水线 (0 波动)"]
    C -->|"复杂非标排障"| E["受限 Agent 节点 (自适应排查)"]
    D --> F["统一格式化交付与记录日志"]
    E --> G["后置测试验收"]
    G -->|"测试通过"| F
    G -->|"测试未通过"| E
  end
- 外层由工作流保障基础合规:入口鉴权、参数清洗、流程流转和最终结果持久化全部用确定性代码固定。
- 内层由受限 Agent 负责攻坚:只在需要多步探索的具体子节点(如“定位并修复复杂报错”)中引入 Agent,同时施加单节点轮数与 Token 预算上限。
- 后置物理校验收口:Agent 节点交付结果后,由外部代码强制跑一次测试或语法检查,通过后才放行至后续流程。
选型判断清单
在决定是否使用 Agent 前,可依次评估以下问题:
- 任务步骤能否在开发期穷举?
- 能穷举:优先采用 Workflow(稳定、低延迟、好调试)。
- 不能穷举:进入下一步。
- 系统是否需要根据工具执行的不可预测返回值来决定下一动向?
- 不需要(如固定前置检索后再生成):采用普通 RAG 或单步骤链。
- 需要(如根据报错日志决定看哪个文件):适合采用 Agent。
- 业务对错误和延迟波动的容忍度如何?
- 容忍度极低(如金融转账校验、账单核算):采用带人工审批的工作流。
- 容忍度中等且需要自动化探索(如开发辅助、数据分析探索):适合引入 Agent,并配置沙箱与熔断机制。
小结
- 区别的核心不在于是否调用大模型,而在于执行路径由代码预先写死(Workflow),还是由模型在运行期动态探索(Agent)。
- 能用规则或工作流解决的稳定场景,不要强行上 Agent;Agent 专用于探索路径不可预知的动态交互任务。
- 工业界实践常采用混合架构:外层用工作流控制业务流程与安全,局部节点用受控 Agent 解决高复杂度探索。
确定了使用 Agent 之后,要把一套动态系统在生产环境中搭稳,需要拆解出哪些关键子系统?
下一篇将逐一拆解这些核心模块:《一个 Agent 系统的核心组成:从系统视角拆解关键模块》。
系列导航与参考
喜欢这篇文章的人也看了
评论
匿名评论隐私政策
✅ 你无需删除空行,直接评论以获取最佳展示效果





