一个 Agent 系统的核心组成:从系统视角拆解关键模块
一个 Agent 系统的核心组成:从系统视角拆解关键模块
Asaakii本文是「Agent 基础与工程」系列专栏的第 3 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
很多开源框架用高度封装的几行 API 掩盖了底层的复杂性。这种封装在写 Demo 时很方便,但当系统需要支持任务断点恢复、细粒度权限控制、耗时调试或多步骤追踪时,如果对内部模块缺乏清晰的职责拆解,代码维护成本会迅速攀升。
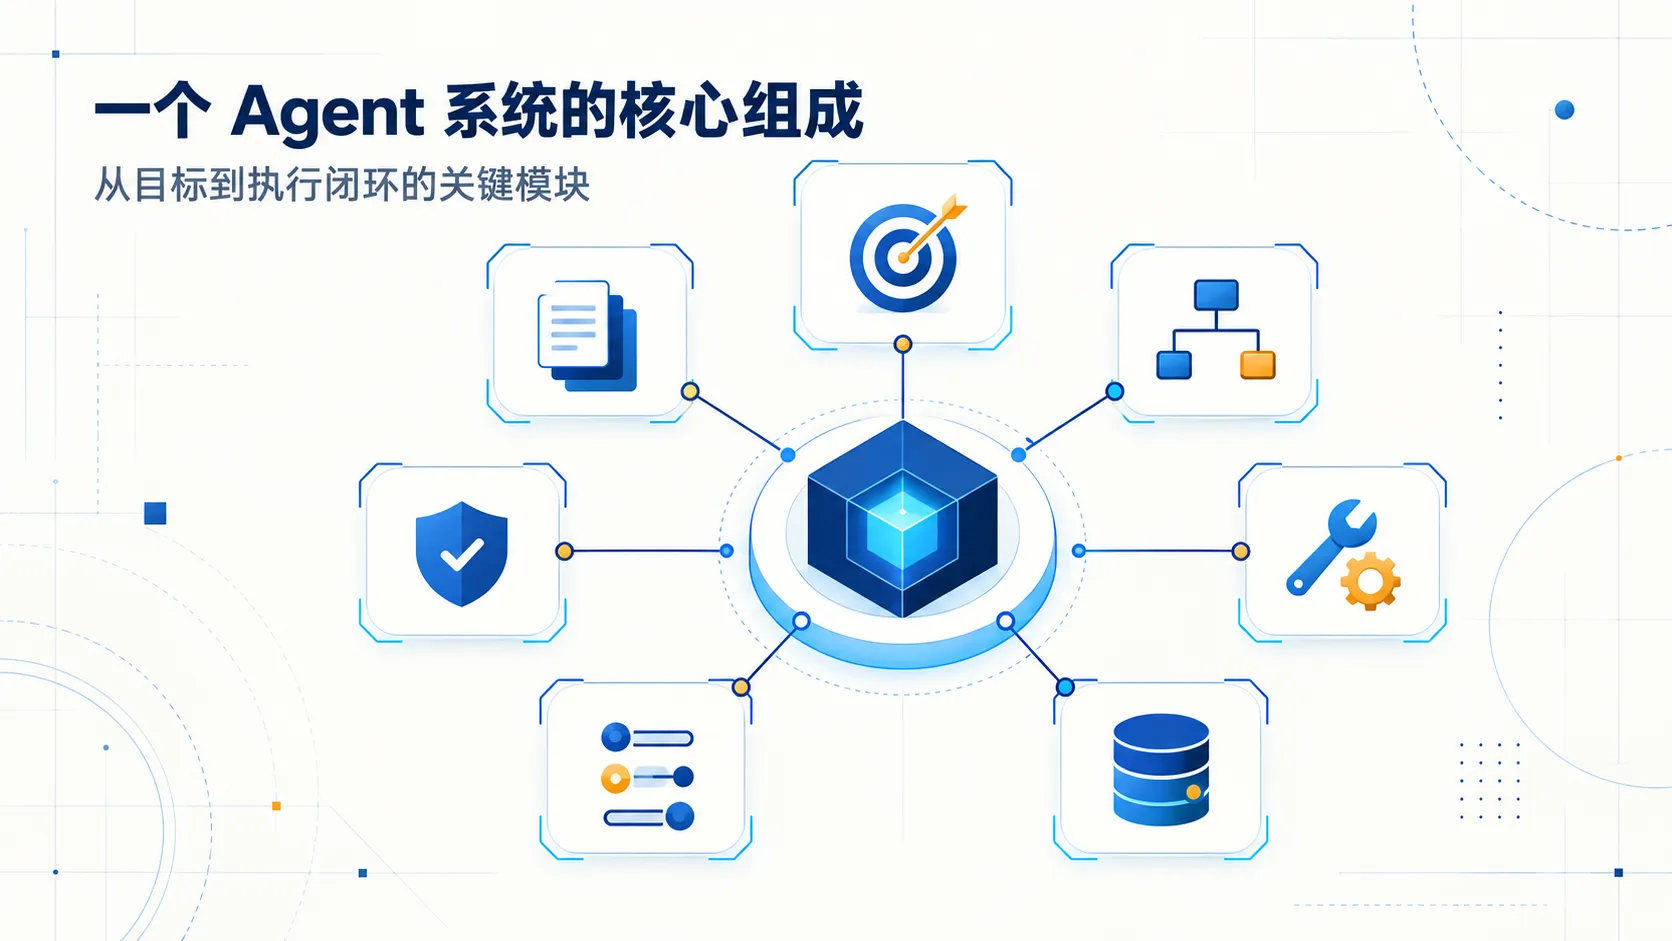
脱离具体的第三方库,一个可维护的生产级 Agent 系统通常由以下七个核心模块协作构成。
系统模块结构
  flowchart TD
  subgraph InputLayer["1. 目标与规范层 (Goal & Spec)"]
    Goal["用户任务输入"] --> Spec["验收条件 (DoD) + 资源预算限制"]
  end

  subgraph CoreRuntime["Agent 核心运行时 (Harness)"]
    direction TB
    State["2. 状态机 (State Machine)<br/>待办图 · 历史轨迹 · 变量空间"]

    subgraph Cognitive["认知与推理"]
      Planner["6. 规划策略 (Planner)<br/>ReAct / 分步规划 / 自省检查"]
      Model["3. 推理中枢 (Model)<br/>Prompt 拼装与模型响应解析"]
      Memory["5. 分层记忆 (Memory)<br/>会话上下文 · 长期语义库"]
    end

    subgraph Execution["工具与安全"]
      Guard["7. 护栏调度 (Guardrails)<br/>权限拦截 · 熔断控制 · 人工审批"]
      Tools["4. 工具管线 (Tool Pipeline)<br/>参数校验 · 沙箱隔离 · 输出降噪"]
    end
  end

  Spec --> State
  State <--> Cognitive
  Cognitive --> Guard
  Guard --> Tools
  Tools -->|"执行结果与观测"| State
七大模块的核心职责
1. Goal & Specification(目标与完成规范)
在 Agent 系统中,目标通常以非结构化的自然语言给出。为了让系统可落地,目标需要包含三项明确约束:
- 目标定义(Objective):明确系统最终产出的交付物(如修复特定 Bug 并生成 Patch,或输出指定格式的对比表格)。
- 完成判据(Definition of Done, DoD):系统依据什么判断任务完成。优先使用客观外部反馈(如自动化测试全部通过、特定文件已写入并经校验),而非仅依赖模型的主观文本生成。
- 资源上限(Resource Budget):最大执行步数限制、Token 消耗上限与单次工具超时阈值。
2. State(状态机与执行上下文)
大模型 API 本身是无状态的,跨步骤的记忆与进度追踪必须在外部由代码显式维护。
一个结构良好、支持序列化落盘的状态设计,能让系统在中途异常中断后具备恢复能力(Resume)。在工程实现中,状态通常可以建模为如下的数据结构:
1 | from typing import List, Dict, Any, Optional |
把 todo_list 和 active_files 作为独立字段显式维护,比让模型在漫长对话中纯靠文字自述更可控,能有效减少在已排查过的死路上重复尝试。
3. Model(推理与意图解析)
模型负责语义理解与单步推断。系统与模型的交互需要做好分层:
- Prompt 组装:动态拼接系统指令、当前状态和近期工具观测。
- 结构化输出契约:采用原生 Function Call 协议输出带类型的参数,而不是让模型输出非标准文本再去用正则表达式匹配。
- 差异化模型路由:简单的分类和初筛交由轻量模型处理,核心逻辑推理与复杂代码修改调用高推理能力模型。
4. Tools(工具与执行环境)
工具是 Agent 与外部环境交互的接口。生产级工具管线需包含以下四道处理机制:
- Schema 校验:使用 JSON Schema 或 Pydantic 严格限定入参格式与默认值。
- 环境隔离:涉及命令执行或写磁盘的工具,运行在独立容器或非特权子进程中,避免影响宿主机运行环境。
- 输出体积控制:避免直接把数万行的原始日志打入上下文,工具层需做行数截断或提取关键异常片段。
- 状态幂等与回退:对有副作用的写操作提供备份或取消机制。
5. Memory(分层记忆系统)
根据生命周期和访问方式,记忆通常划分为四层:
| 记忆类型 | 存储位置 | 生命周期 | 访问方式 | 适用内容 |
|---|---|---|---|---|
| 工作记忆 (Working Memory) | 内存中的当前消息列表 | 当前会话 | 随请求全量携带 | 本轮任务的目标、前几步的操作结果 |
| 情景记忆 (Episodic Memory) | 磁盘日志(如 JSONL 文件) | 永久 | 按 Session ID 调取 | 历史任务完整运行轨迹,便于排查回溯 |
| 语义记忆 (Semantic Memory) | 向量数据库 / 全文索引 | 跨任务长期保存 | Embedding 相似度检索 / BM25 检索 | 团队规范、设计文档、业务专有词汇 |
| 程序记忆 (Procedural Memory) | 预设代码脚本 / Skill 文件 | 跨任务长期保存 | 按工具名匹配加载 | 固化的操作流程、特定接口调用范例 |
6. Planner / Policy(规划与决策模式)
规划层决定了 Agent 是如何组织思考步骤的:
- ReAct:思考与行动交替进行。每执行一步工具,观察返回结果后再决定下一步,适合信息未知、需要边查边推进的任务。
- 分步规划(Plan-and-Solve):任务开始时先生成多步计划清单,按清单顺序依次执行;只有当某一步失败时才触发重新规划。
- 执行前自检(Critique / Reflection):在提交高风险变更前,启动一轮核对逻辑(如运行测试用例或静态语法检查),依据客观结果判断是否通过。
7. Guardrails & Harness(护栏与运行时管控)
模型是概率生成的,系统运行的确定性必须由外层代码兜底:
- 轮数与成本硬限制:当任务超过预设步数或 Token 阈值时强制停止。
- 敏感命令拦截:通过正则匹配与静态语法分析,阻断高危系统命令。
- 人工确认门禁(Human-in-the-loop):对于发送邮件、推送到远程仓库或删除线上资源等高风险操作,暂停循环等待人类审批确认。
轮次交互时序
将各模块拼装起来后,一个完整执行轮次的时序如下:
  sequenceDiagram
  autonumber
  participant State as 状态机 (State)
  participant Mem as 记忆检索 (Memory)
  participant Model as 模型中枢 (Model)
  participant Guard as 护栏调度 (Guardrails)
  participant Tool as 工具管线 (Tools)

  State->>Mem: 按当前目标检索长期经验或规范
  Mem-->>State: 返回关联片段
  State->>Model: 提交组装好的 Prompt 与消息轨迹
  Model-->>State: 输出决策:请求调用指定工具与参数
  State->>Guard: 发起工具执行请求
  alt 触发安全策略拦截
    Guard-->>State: 拦截并返回“该操作无权执行”
  else 审核通过
    Guard->>Tool: 在沙箱环境中执行工具
    Tool-->>State: 返回过滤后的执行观测结果
  end
  State->>State: 更新待办状态、累加资源用量、检查终止条件
常见架构缺陷
- 依赖自然语言提示词维护状态:把整个待办清单和已读文件全写在 Prompt 字符串里让模型“记住”。长上下文下,模型极易产生幻觉或漏看。应当用独立数据结构管理状态,并在每轮组装时显式注入。
- 工具返回值未加过滤:直接把爬虫抓取的整个原始 HTML 或几千行编译日志塞入消息历史,迅速消耗上下文窗口。
- 缺乏客观物理事实源:以模型的自然语言断言作为任务成功的依据,而不是依靠实际的命令退出码、测试结果或文件变更做确认。
小结
- 生产级 Agent 由 Goal、State、Model、Tools、Memory、Planner 和 Guardrails 七个子系统配合运作。
- 显式、可序列化的状态机是支持任务恢复、避免循环打转的基础。
- 护栏与调度逻辑位于模型之外,负责对执行轮数、工具权限与异常退出提供确定性保障。
理清了系统的组成架构后,下一个核心问题是:许多系统在本地 Demo 中表现正常,一进入真实环境却容易出现卡死、死循环或逻辑混乱,这背后的工程断层到底在哪里?
下一篇将分析导致系统不稳定的具体原因:《为什么很多 Agent Demo 一落地就不稳定:从工程视角看原型到生产的断层》。