Context、State 与 Memory:从消息轨迹理清上下文、状态与长期记忆
Context、State 与 Memory:从消息轨迹理清上下文、状态与长期记忆
Asaakii本文是「Agent 基础与工程」系列专栏的第 6 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在很多关于智能体的讨论中,“上下文”、“状态”、“短期记忆”、“长期记忆”与“知识检索”常被混为一谈。不少开发者将模型的单次推理输入直接等同于“记忆”,或者在系统多轮运行后,仅靠简单截断消息历史来应对 Token 限制。
这种混淆在原型开发期尚可勉强运行,但在生产环境中会迅速引发几类典型故障:历史消息裁剪破坏了工具调用与返回结果的因果配对,导致 API 返回 HTTP 400 校验失败;原始目标在历史轮次滚动中被移出窗口,导致智能体目标漂移;长对话累积大量低价值工具日志,消耗巨额 Token 成本的同时降低了模型的推理注意力。
理清这五个概念的系统职责与数据流向,是构建长生命周期 Agent 系统的基本功。
核心概念解耦:五层数据形态
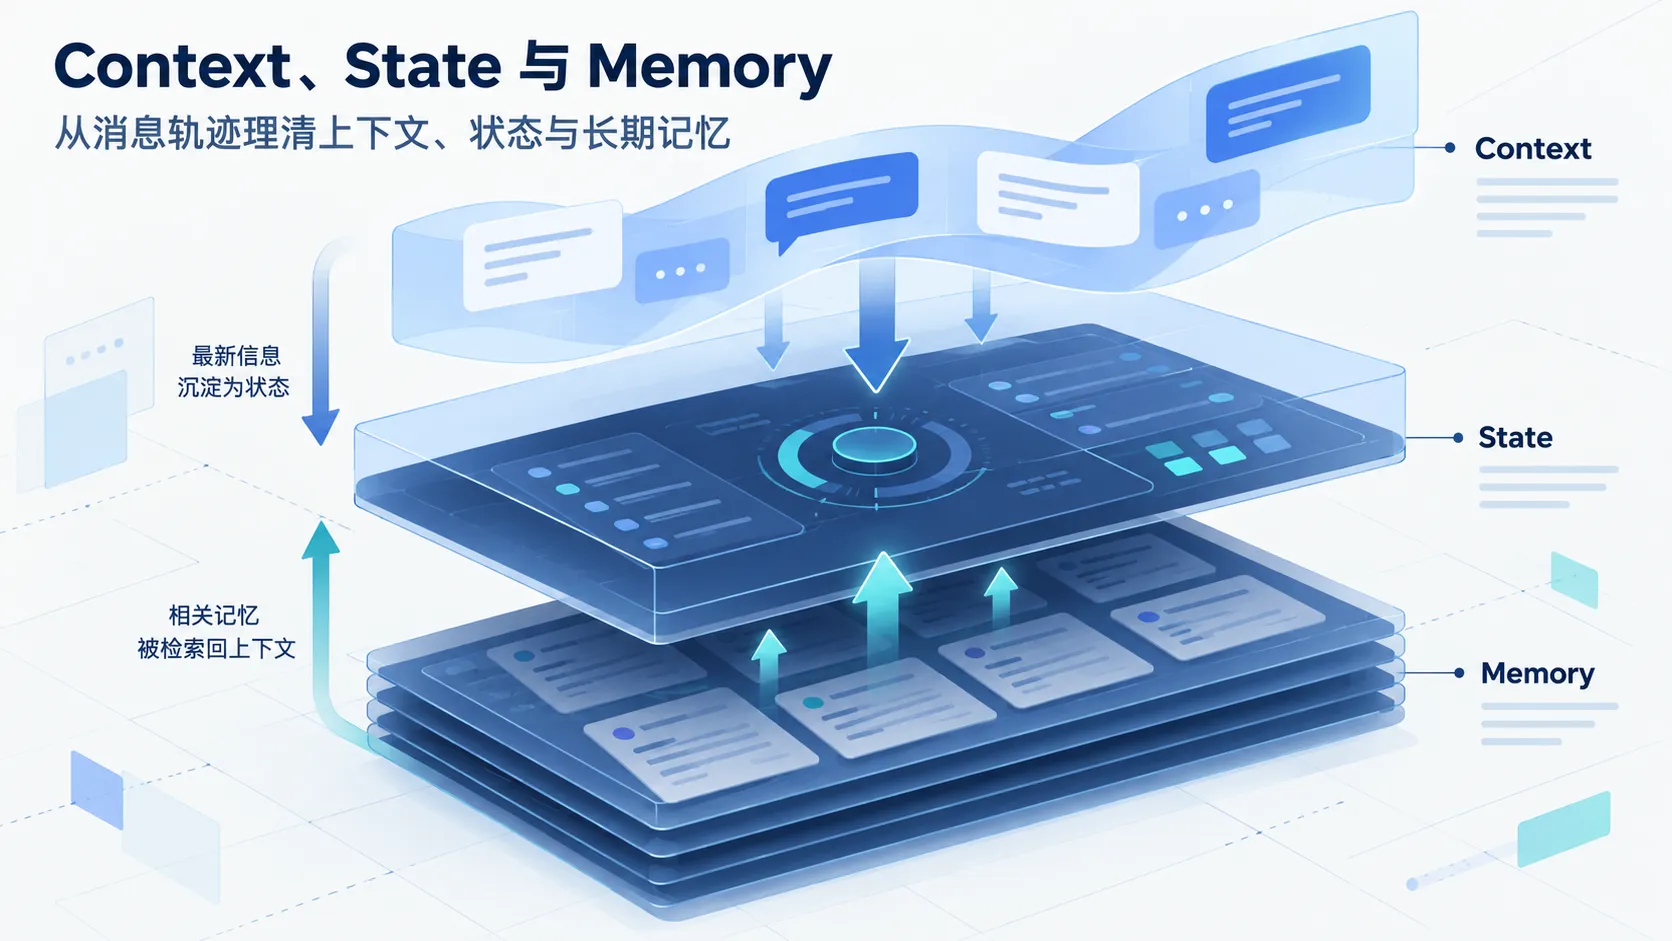
在 Agent 系统中,数据并不是铁板一块,而是按照作用域、生命周期与持久化介质划分成五个独立层级:
  flowchart TD
    subgraph Storage ["持久化存储介质 (Persistent Tier)"]
        D1[(向量数据库 / 知识库)] -->|只读召回| RAG[RAG 知识检索]
        D2[(图数据库 / KV 存储)] <-->|沉淀与更新| Mem[Long-term Memory 长期记忆]
        D3[(关系型数据库 / Redis)] <-->|步进读写| St[State 结构化系统状态]
    end

    subgraph MemoryEngine ["上下文引擎 (Context Engine)"]
        RAG --> Ctx[Context 工作集]
        Mem --> Ctx
        St --> Ctx
        Hist[Session Messages 历史消息] -->|滑动与压缩| Ctx
    end

    subgraph LLM ["推理层 (Inference Tier)"]
        Ctx -->|单次 HTTP POST 请求| Model[大语言模型]
        Model -->|生成文本或工具声明| Harness[Agent Harness]
        Harness --> St
        Harness --> Hist
    end
各项概念的工程定义与边界对比如下:
| 概念 | 存在形态 | 生命周期 | 核心职责 | 存储位置 |
|---|---|---|---|---|
| Messages(消息数组) | 遵守厂商协议的字典列表(role + content) |
当前会话 | 记录人类与模型、工具之间的协议级原始交互记录 | 关系型数据库、日志服务 |
| Context(当前上下文) | 单次 API 请求发送给模型的全部 Token 工作集 | 单次模型推理(毫秒级) | 为当前推理提供即时可见的指令、历史、变量和知识 | 模型显存(推理期瞬时工作集) |
| State(系统结构化状态) | 强类型数据模型(如 Pydantic / TypeScript 接口) | 任务生命周期(分钟至天) | 记录任务目标、当前步骤进度、全局变量、子任务清单与重试次数 | Redis、PostgreSQL、文件系统 |
| Memory(系统记忆) | 提炼后的实体画像、偏好设置、历史经验规则 | 跨会话、跨任务(长期持久) | 将过去多次任务中沉淀的经验和用户习惯在后续任务中重用 | 向量数据库、知识图谱、KV 存储 |
| RAG(外部知识检索) | 外部非结构化/半结构化文档切片与索引 | 外部业务生命周期 | 为系统补充未曾在预训练权重中包含的私有或实时业务知识 | 向量检索引擎、全文检索系统 |
Messages 与 Context 的区别:工作集编排
初学者常把会话历史数组直接发给模型:client.chat.completions.create(messages=history)。在多轮复杂任务中,这会导致系统迅速失控。
Context 是为本次推理目标定向装配的计算工作集:
上下文装配结构拆解
- 锚定前缀(Anchor Prefix):包含角色设定、全局安全约束、输出 Schema。此部分属于硬性前置规则,任何修剪算法都不能修改或丢弃。
- 状态快照(State Snapshot):从持久化数据库中拉取的结构化业务状态。例如:
当前已完成步骤: [1, 2];当前阻塞点: 缺少用户授权;重试计数: 1/3。 - 外部召回(Injected Knowledge):根据用户最新输入从 RAG 检索到的前 3 条高相关性切片,或者从长期记忆中提取的用户偏好规则。
- 近期交互轨迹(Working Trace):经过清洗和裁剪的近几轮对话与工具调用日志。
- 工具清单(Tool Schemas):经过动态过滤后的可用工具列表。
为什么朴素滑动窗口会破坏系统
当对话轮次增加,Token 数量逼近模型上限或预算阈值时,最直观的想法是对 messages 做简单的 FIFO 截断,例如只取最后 10 条消息:messages = messages[-10:]。这种做法在包含工具调用的生产系统中会引发两类确定性灾难:
1. 因果配对断裂(Broken Causal Chain)
大模型的工具调用协议要求 assistant.tool_calls 与后续的 tool 结果消息保持一一配对。如果切片位置恰好落在一对工具调用中间:
1 | [已截断丢失] assistant: tool_calls=[id=call_001, name="check_order"] |
当这段消息发送给 OpenAI API 时,服务端会因为检测到 call_001 没有前置的 tool_calls 声明而直接抛出错误:
1 | HTTP 400: Invalid parameter: 'messages': message with role 'tool' must be preceded by an assistant message with 'tool_calls'. |
2. 原始目标丢失(Goal Drift)
用户的首条消息往往定义了任务的总目标(例如“排查昨日订单对账不平的原因并出具审计报告”)。如果直接截断头部,模型在后续轮次中将失去全局目标锚点,只能根据局部的工具输出被动响应,导致任务发散无法收敛。
上下文预算与安全裁剪算法
为了保证在超长任务下系统的稳定性,必须使用**基于轮次原子性(Turn Atomicity)**的上下文裁剪引擎。
安全裁剪四原则
- 锚定首尾(Anchor First and Last):系统 Prompt 与包含原始目标的初始用户输入永不丢弃;当前轮次的最新消息永不丢弃。
- 原子轮次完整性(Atomic Turn):一个助手工具请求(可能包含多个并行
tool_calls)及其对应的所有tool结果消息,被视为一个不可拆分的原子操作单元。要么整体保留,要么整体压缩。 - 结果折叠(Result Folding):对于已经完成数轮的历史工具调用,将冗长的原始 JSON(可能几千 tokens)原地替换为简要摘要(如
{"status": "success", "summary": "已获取 100 条流水"}),只保留核心状态变化。 - 状态下沉与结构化提炼(State Offloading):当必须丢弃早期消息时,先由总结模块提取“已确认事实”和“已完成事项”并合入
State对象,再安全丢弃对应的消息片段。
安全裁剪算法实现
1 | from typing import List, Dict, Any |
State(状态)的一等公民地位
许多轻量框架将所有状态隐藏在对话历史中。这种“历史即状态”的设计是脆弱的。
生产级 Agent 应将状态独立于模型消息之外进行维护。状态机必须使用强类型的结构体进行建模:
1 | from pydantic import BaseModel, Field |
无论模型上下文被如何裁剪、会话连接因网络抖动中断多久,只要读取数据库里的 AgentState,系统就能精确获知任务目前推进到了哪个阶段,而无需让模型重新从头“脑补”进度。
记忆分层(Memory Hierarchy)设计
长期记忆的核心不是全量留存,而是提炼与召回。常见的三层记忆模型包括:
  flowchart LR
    subgraph S1 ["工作记忆 (Working Memory)"]
        W1[当前正在处理的短上下文]
        W2[单轮输入与最近 3~5 轮操作日志]
    end

    subgraph S2 ["情节记忆 (Episodic Memory)"]
        E1[任务执行经验与复盘日志]
        E2["例如:上次排查该故障发现配置在 A 路径下"]
    end

    subgraph S3 ["语义记忆 (Semantic Memory)"]
        M1[用户偏好与业务实体知识]
        M2["例如:当前用户偏好使用 Python 编写脚本"]
    end

    W1 -->|任务收敛后触发提炼| E1
    W1 -->|用户特征被识别后提炼| M1
    E1 -.->|相似任务特征检索召回| W1
    M1 -.->|相关场景前置注入| W1
1. 语义记忆(Semantic Memory)
存储相对稳定、跨任务生效的常识、偏好与规则。
- 结构:KV 映射、属性图或结构化元数据(如
user_preferences: {language: "zh-CN", code_style: "type-annotated"})。 - 生命周期:长期持久化,通过明确的用户操作或系统提炼进行增删改查。
2. 情节记忆(Episodic Memory)
存储智能体自身过去的“亲身经历”,包含过去处理某项任务的具体轨迹、走过的弯路以及最终成功的关键参数。
- 触发机制:任务终结时,由后台异步 Worker 运行总结程序,输出一段执行心得(Reflection Summary)。
- 召回机制:在新任务启动时,使用当前任务的目标作为 Query,在向量库中匹配最相似的历史任务经验,作为 Few-shot 注入当前 Prompt。
RAG 与 Memory 的本质分界
| 维度 | RAG(检索增强生成) | Memory(记忆系统) |
|---|---|---|
| 知识源属性 | 外部世界的静态/公用资料(产品手册、API 文档、企业规章) | 内部系统与特定主体产生的交互经验(用户习惯、运行轨迹、复盘心得) |
| 读写频率 | 高频只读,写操作通常由离线批处理或文档同步流水线完成 | 运行时动态读写,随着智能体的每轮操作持续更新 |
| 更新影响 | 通常是无状态的检索增强,不改变系统的控制流程 | 会直接影响智能体后续轮次的规划决策与行为偏好 |
| 失败模式 | 召回了不相干文档(切片噪声冲垮模型注意区) | 沉淀了错误的过时偏好(幻觉固化导致经验误导) |
工程自测与架构排查
在实现自己的 Agent 运行时,对照以下问题检验状态与记忆的设计深度:
- 当你的应用服务发生 OOM 重启时,未完成的 Agent 任务是直接从世界上消失,还是能从持久化存储中反序列化
AgentState并断点续跑? - 在清理上下文时,你是否有算法校验确保没有留下任何一个找不到
tool_calls的孤立tool消息? - 当长任务累积了 50 轮工具输出时,你的系统是持续将数万 Token 丢进 API,还是通过状态提炼将已完成步骤归档,始终将活动上下文控制在安全预算内?