为什么很多 Agent Demo 一落地就不稳定:从工程视角看原型到生产的断层
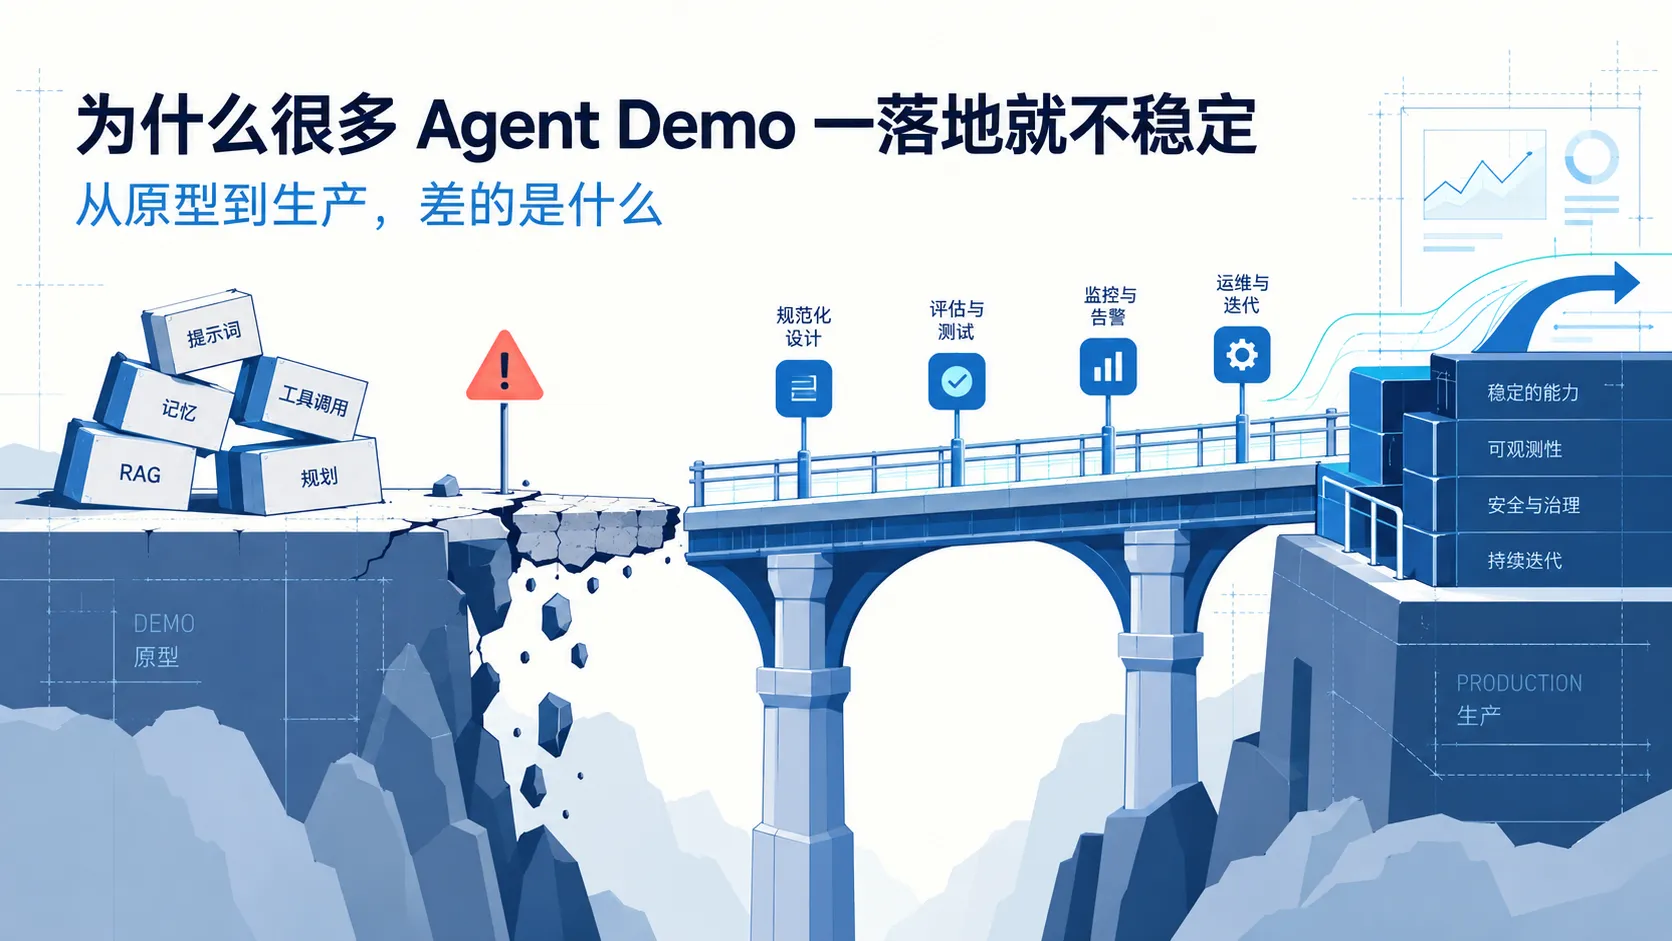
为什么很多 Agent Demo 一落地就不稳定:从工程视角看原型到生产的断层
Asaakii本文是「Agent 基础与工程」系列专栏的第 4 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
很多 Agent 项目在本地简单场景下表现良好,一旦接入实际复杂业务或面对长链路任务,容易出现运行卡死、在相同错误上反复打转、或者在无法完成时假装成功的现象。
这类问题通常不是因为底座模型能力突然下降,而是因为原型演示(POC)与生产环境面临的约束条件完全不同。
原型验证与生产环境的关注点差异
| 维度 | 原型演示(Demo) | 生产系统(Production) |
|---|---|---|
| 测试输入 | 干净、结构明确的样本,极少包含格式畸变或歧义 | 包含错别字、非标参数、缺少上下文的真实输入 |
| 链路长度 | 通常控制在 3~5 轮交互以内 | 复杂任务常达到 15~30 轮以上,累积误差高 |
| 工具状态 | 默认外部 API 永远可用,响应迅速 | 存在网络超时、字段变更、偶发 500 报错与脏数据 |
| 成功判据 | 人工肉眼观察“有合理的文字输出”即算通过 | 要求具备客观验证(如测试退出码为 0、文件比对通过) |
| 成本与耗时 | 偶尔耗时较长或 Token 较多不会被视为问题 | 需控制单任务成本上限与 P95/P99 延迟波动 |
  flowchart LR
  subgraph Demo["原型阶段 (验证可行性)"]
    direction TB
    D1["理想化输入"] --> D2["受控短链路"] --> D3["人工肉眼评测"]
  end

  subgraph Gap["工程断层"]
    direction TB
    G1["非确定性累积"]
    G2["错误级联放大"]
    G3["注意力稀释"]
  end

  subgraph Prod["生产阶段 (保障稳定性)"]
    direction TB
    P1["状态机防重"] --> P2["异常自愈与熔断"] --> P3["自动化回归评测 (Eval)"]
  end

  Demo --> Gap --> Prod
导致系统不稳定的五个关键因素
1. 格式依从度的长链衰减
在单轮提示词中,要求模型输出特定格式的 JSON,遵循率通常能达到 98% 左右。但在多轮循环中,随着上下文历史增加,这个成功率会被复合放大:
如果单步输出完全合规的概率是
- 经过 10 轮调用后,全流程完全不发生格式异常的概率降为:
- 经过 25 轮调用后,概率下降至:
当交互深度增加,模型偶尔会输出非标准代码块或多余解释。如果宿主程序没有做容错解析、自动修复重试或采用强类型 Function Call,系统便会因 JSON 解析异常中断。
2. 错误级联与假设放大
在开环程序中,单步报错可以通过捕获异常并抛出终止。但在 Agent 这一以模型为推理中枢的闭环中,上一步的异常输出会被作为下一步的输入依据。
常见情况:
- Agent 调用查询工具,由于参数带了空格,工具返回
Error: empty result; - 模型没有推测出是参数格式问题,而是假定“该模块尚未初始化”;
- 模型基于该错误假设,开始调用创建工具初始化环境,甚至覆写原有配置;
- 初始的参数小错误被层层推导,最终导致后续步骤完全偏离原本任务。
3. 上下文无序膨胀与注意力分散
很多系统直接把工具的原始标准输出全量追加到历史消息中。
当一个命令执行输出了几千行构建日志或整个 HTML 页面时:
- 有效信息被淹没:大模型在超长上下文下对核心指令的注意力会衰减(Lost in the Middle),容易遗忘系统最开始设定的安全约束与退出规则;
- 重复推理成本倍增:每一次循环都需要将这几万 Token 重新输入模型,显著拉长单轮等待时间并消耗大量 Token 预算。
4. 工具契约脆弱
直接使用人类交互的 CLI 命令或未经裁剪的 REST 接口作为 Agent 工具,容易产生问题:
- 信噪比低:工具返回了大量进度条字符、控制台色彩转义符或空行,干扰模型判断;
- 缺乏幂等性:写操作工具在重试时直接报错冲突,模型无法判断该资源是先前自己创建成功的还是被外部篡改的;
- 未区分成功与异常:有些命令行即使执行失败,输出也混杂在标准输出中,模型无法依靠统一的字段(如
status: error)快速定位问题。
5. 缺乏死循环熔断与客观退出判据
在缺乏外部硬性干预的情况下,Agent 容易出现两种异常终态:
- 动作死循环:使用方案 A 尝试失败后,下一轮继续使用完全相同的参数调用方案 A,反复尝试直到步数耗尽;
- 虚假完成:模型在连续多次遇到错误且无法解决时,直接在文本中声明“任务已完成”,而实际上核心文件并未被修改。这是由于模型生成偏向于提供正面回答,缺乏客观校验机制去推翻其结论。
生产级加固方案
要让 Agent 系统在真实业务中保持稳定,需要在架构上建立针对性的防御机制:
1. 建立客观物理事实源,替代模型主观判断
不以模型生成的自然语言确认任务是否完成。
- 修复代码任务:由外部宿主实际运行
pytest或go test,仅在命令退出码为 0 时判定完成; - 数据提取任务:由代码层校验输出 JSON 的字段完整性与类型约束,校验失败则将具体的缺失字段作为反馈打回重试。
2. 对工具输出执行强制降噪与截断
在工具管线中加入规范化处理:
- 严格限制单次工具返回的最大行数(如只保留匹配行前后 5 行,超过 100 行自动截断);
- 剥离控制台转义字符与无意义空行;
- 返回标准化的结构包装:
{"success": false, "code": "NOT_FOUND", "message": "..."},帮助模型建立明确因果推断。
3. 加入死循环检测(Loop Breaker)
在宿主循环中追踪动作调用历史:
1 | # 记录最近工具调用的指纹 |
4. 实施上下文预算管理(Context Compaction)
当总 Token 达到设定水位线(例如模型上下文窗口的 50%)时,主动对历史进行修剪:
- 将早期的中间工具详细输出压缩为单行说明(如
[已读取 auth.py,定位到第 40 行缺少参数验证]); - 保证系统顶部的基础规范与最底部的最新两轮观测数据完整保留。
5. 建立基于回归测试集(Eval)的评估机制
不再依靠手动在对话框里临时测试。
- 在代码库中维护一组包含 20~50 个典型用例和历史踩坑用例的 Benchmark;
- 每次修改提示词、工具实现或切换模型版本时,自动化跑完全量测试集;
- 统计任务通过率(Pass Rate)与平均调用轮数,有据可依地评估每次改动带来的实际影响。
小结
- 原型演示验证的是功能连通性,而生产环境需要应对长链条衰减、错误累积和工具异常。
- 格式漂移、级联放大、上下文淹没是导致系统不可控的核心技术诱因。
- 解决稳定性问题,重点在于建立客观物理完成判据、工具输出降噪、死循环检测与基于回归测试集的持续评测。
在搞清楚系统稳定性防线之后,我们将进入具体的协议与接口实现:Agent 是如何与大模型底层 API 交互的?参数如何传递?工具调用 ID 如何对齐?流式事件如何处理?
下一篇我们将深入 API 协议细节:《大模型 API 输入输出与 Tool Calling:从协议交互到完整工具调用循环》。