大模型 API 输入输出与 Tool Calling:从协议交互到完整工具调用循环
大模型 API 输入输出与 Tool Calling:从协议交互到完整工具调用循环
Asaakii本文是「Agent 基础与工程」系列专栏的第 5 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
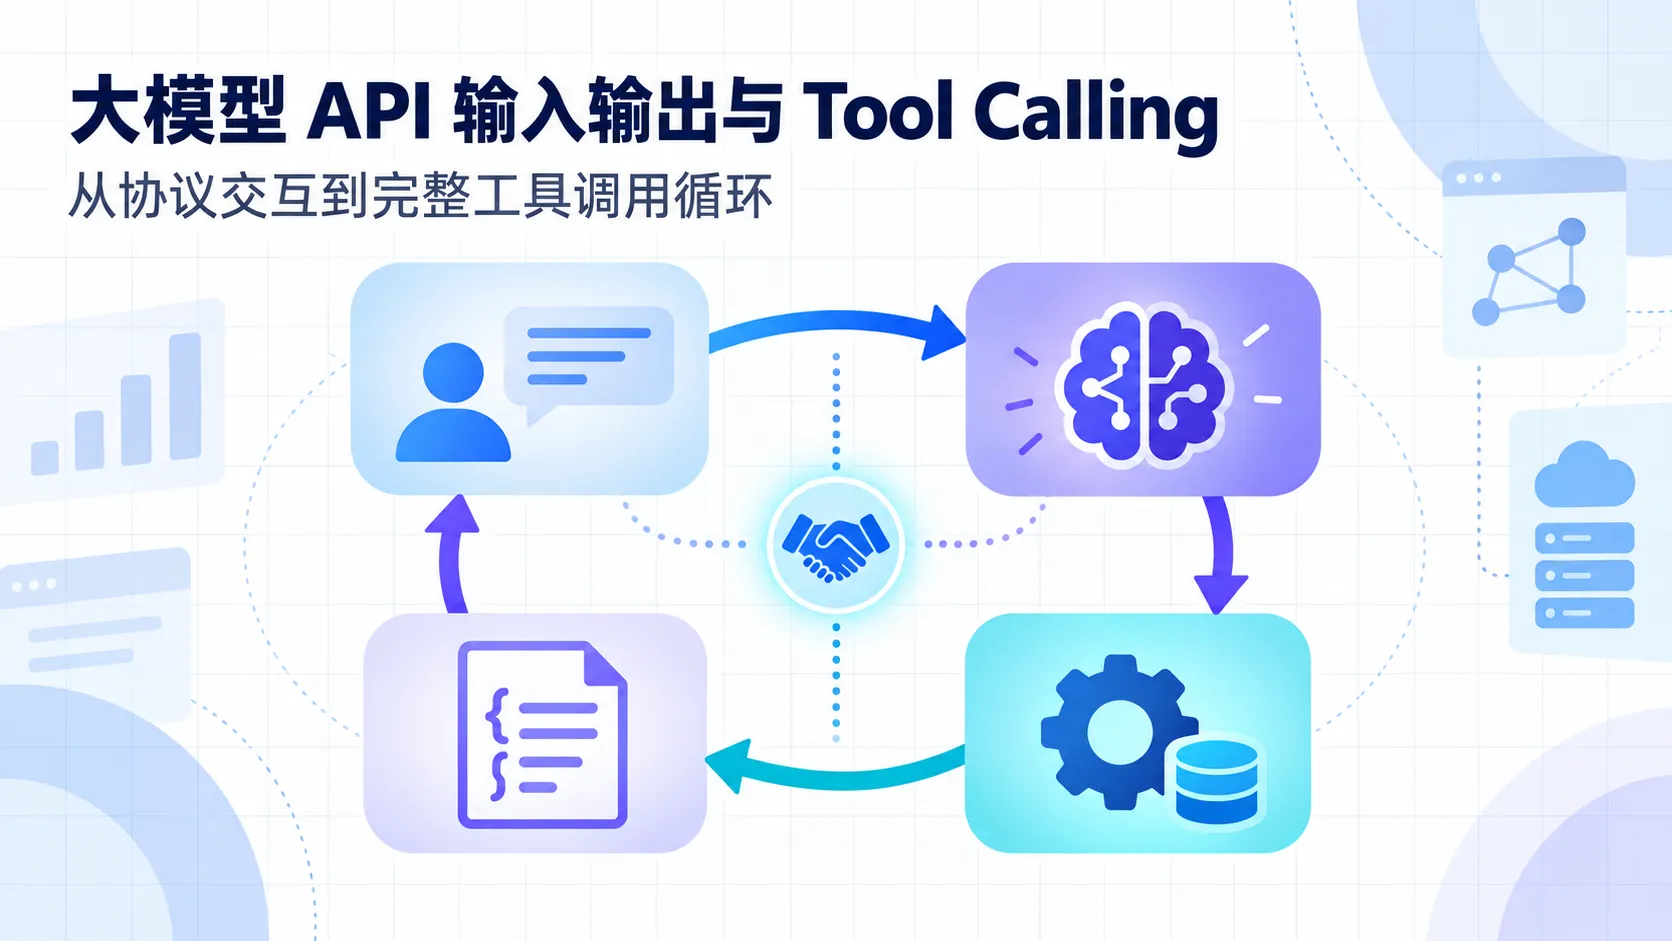
大模型 API 建立在无状态的 HTTP 请求-响应模型之上。单次推理调用结束后,服务端不会维持客户端的会话指针。所谓的 Agent 外部行动能力,并不是大语言模型自己在服务器上执行代码或发送网络请求,而是模型在响应中输出符合特定 Schema 的调用声明(包含工具名称与入参),由外部宿主程序(Agent Harness)负责执行,再把执行结果包装为协议消息重新发给模型。
这一机制通常被称为 Tool Calling(或 Function Calling)。理解 Tool Calling 的工程边界,是编写稳定 Agent 系统的第一道门槛。
交互本质:模型负责决策,程序负责执行
将大模型引入工具调用系统后,控制流由模型决策与程序执行交替推进:
  sequenceDiagram
    autonumber
    participant U as 用户 / 上游系统
    participant H as Agent Harness (宿主程序)
    participant M as 大模型 (LLM API)
    participant T as 外部工具 (DB / API / Shell)

    U->>H: 提交任务目标
    H->>M: POST /chat/completions (系统指令 + 用户消息 + Tools Schema)
    M-->>H: 返回响应 (finish_reason="tool_calls", 包含工具名与参数)
    Note over H: 校验参数有效性与权限
    H->>T: 实际调用外部接口或执行脚本
    T-->>H: 返回执行数据或错误堆栈
    H->>M: POST /chat/completions (回传原调用 + 工具执行结果)
    M-->>H: 返回响应 (finish_reason="stop", 生成最终自然语言结论)
    H-->>U: 返回任务交付结果
两者的职责划分必须在代码中严格隔离:
- 模型负责:解析任务目标,判断当前上下文是否需要调用外部工具;从工具清单中挑选合适工具,并根据上下文补全参数;在拿到工具返回后,综合评估信息充分性,决定输出最终结论还是发起下一轮工具调用。
- 宿主程序(Harness)负责:维护完整的对话与工具执行轨迹;执行参数的 JSON Schema 校验与业务逻辑验证;拦截高危命令与鉴权;处理网络超时、重试与熔断;将工具返回值格式化为协议要求的结构并回传给模型。
模型输出“准备调用某工具”只是文本/标记生成的结果,外部动作尚未发生。系统的安全与一致性底线全部落在 Harness 的拦截和校验机制上。
协议模型:一次 API 请求的结构剖析
不同模型厂商在 SDK 封装和字段命名上存在差异,但底层报文包含的语义层次基本一致:
| 报文层级 | 包含内容 | 是否计入模型上下文 |
|---|---|---|
| 连接与鉴权 | API Key、Endpoint、HTTP Headers、Org ID、Client Timeout | 否,仅网络传输与认证使用 |
| 推理超参 | temperature, top_p, max_tokens, stop 序列 |
否,直接影响解码采样行为 |
| 工具定义 (Tools) | 函数名称、功能描述说明(Description)、JSON Schema 参数定义 | 是,在服务端被序列化并计入 Prompt Tokens |
| 消息数组 (Messages) | system, user, assistant, tool 等历史交互序列 |
是,构成模型本次推理的核心工作上下文 |
| 控制约束 | tool_choice(auto / required / none / 具体工具名)、结构化输出 Schema |
是,部分接口作为额外引导标记注入 |
以标准的 OpenAI 兼容 Chat Completions 请求为例:
1 | { |
工具定义的描述字段(description)并不是装饰性文档,而是模型选择工具与提取参数的核心提示词来源。字段描述如果语焉不详,模型就容易填错格式或误判工具意图。
跨厂商协议映射与因果绑定
业界主要主流大模型厂商(OpenAI、Anthropic、Google Gemini)的协议字段结构存在差异,下表梳理其核心语义映射:
| 语义角色 | OpenAI Chat Completions | OpenAI Responses API | Anthropic Messages API | Google Gemini generateContent |
|---|---|---|---|---|
| 系统规则 | messages[].role = "system" |
instructions |
顶层 system 字段 |
顶层 systemInstruction |
| 用户指令 | messages[].role = "user" |
input_messages / items |
role: "user" |
contents[].role = "user" |
| 助手输出 | messages[].role = "assistant" |
output_messages / items |
role: "assistant" |
contents[].role = "model" |
| 工具调用声明 | assistant.tool_calls[] (id, name, arguments) |
function_call item |
content[].type = "tool_use" (id, name, input) |
parts[].functionCall (name, args) |
| 工具执行结果 | messages[].role = "tool" (tool_call_id, content) |
function_call_output item |
content[].type = "tool_result" (tool_use_id, content) |
parts[].functionResponse (name, response) |
因果绑定的硬性约束(Causal Pairing)
无论哪种协议,工具调用的执行链条必须保持因果配对:
- 唯一标识匹配:在 OpenAI 和 Anthropic 体系中,模型发出的每一次调用声明都带有一个全局唯一 ID(例如
call_9F8aB...或toolu_01...)。Harness 回传执行结果时,必须显式引用该 ID。 - 原子性保全:历史修剪时,不能只保留
tool结果消息而删掉前面的assistant.tool_calls声明,也不能保留了声明却遗漏结果回传。孤儿调用(Orphan Tool Call)或无源结果会导致 API 校验直接报错(如 HTTP 400Invalid parameter: tool_call_id),破坏推理上下文一致性。 - Gemini 类型的按序隐式匹配:部分接口(如部分旧版 Gemini API)没有分配显式的调用 ID,而是依赖消息数组内部的
functionCall与functionResponse按工具名称和上下文先后顺序进行拓扑配对。在这种协议下,调用的顺序绝不能随意重排。
典型工具调用全生命周期(Two-Turn Loop)
以一个排障任务为例,跟踪网络报文的实际进出细节。
阶段一:初始请求与调用声明生成
客户端发送初始请求:
1 | { |
服务端返回工具调用响应:
1 | { |
此时的控制状态:
message.content为null,这并不代表失败,而是模型将注意力转移到了结构化工具调用字段;finish_reason为"tool_calls",明确通知 Harness 本轮推理处于工具挂起等待态;arguments是一段未经解析的序列化 JSON 字符串。
阶段二:宿主执行与结果回传
Harness 解析 arguments,验证 threshold_ms 字段符合非负整数规则,调用内部数据库监控 SDK,得到结果并序列化为 JSON 字符串。
客户端组装并发送第二次请求:
1 | { |
阶段三:模型汇总输出结论
服务端返回最终自然语言文本:
1 | { |
finish_reason 变为 "stop",且未包含新的 tool_calls,表示工具调用闭环结束,Harness 可以将结果渲染给终端。
并行调用与副作用防护
高级模型在面对复杂指令时,经常在单轮响应中返回多个工具调用。例如用户提问:“对比上海与北京两地的当前气温”:
1 | "tool_calls": [ |
1. 并行调用的调度原则
- 只读查询(Read-only):如指标查询、文档搜索、网络 GET 请求。完全可以在 Harness 内部通过异步线程池(如 Python
asyncio.gather)并发发起,降低整体 P99 耗时。 - 写操作与副作用(Mutation):如创建工单、扣减额度、更新数据库。如果模型在一个响应中返回了多个写入动作,Harness 必须审视数据依赖与业务事务性。不可直接盲目并发,必须按业务拓扑串行化执行或增加事务控制。
2. 局部容错处理
当并行执行两个工具时,若 call_bj_02 遭遇上游接口超时,绝不能丢弃已成功的 call_sh_01,更不能直接向模型抛出顶层异常而中断任务。正确做法是将错误结构化包装后回传:
1 | [ |
让模型在下一轮自行决定是重试北京节点、还是基于上海的数据向用户说明情况。
流式传输(Streaming)下的参数拼装状态机
在终端交互或实时控制台应用中,通常会开启 stream=True。此时服务端通过 SSE(Server-Sent Events)按 chunk 推送文本,工具调用的参数也会被切分为若干字符碎片(Token Deltas):
1 | data: {"choices":[{"delta":{"tool_calls":[{"index":0,"id":"call_123","function":{"name":"query_db"}}]}}]} |
直接对中间的任意一个 delta 调用 json.loads() 都会导致解析崩溃。处理流式工具调用的核心是状态机累加器:
  stateDiagram-v2
    [*] --> Idle: 建立 SSE 连接
    Idle --> Buffering: 收到 tool_calls 首包 (记录 call_id & name)
    Buffering --> Buffering: 收到 arguments delta (字符串拼接)
    Buffering --> Validating: 收到 finish_reason="tool_calls"
    Validating --> Executing: JSON 解析 & Schema 校验通过
    Validating --> ErrorHandling: JSON 损坏或 Schema 不匹配
    Executing --> Idle: 执行工具并构建下一轮请求
    ErrorHandling --> Idle: 生成结构化错误回传
在收到最终的 finish_reason 或 [DONE] 之前,绝不能提前触发外部工具执行;若 SSE 连接在中途发生网络断开(Network Reset),必须整包丢弃该调用并清理中间状态,严禁拿着残缺的参数执行下游操作。
生产级最小工具调用循环实现
下面使用原生 Python(不依赖任何第三方 Agent 框架,仅使用 openai SDK)演示一个健壮的工具调用循环,包含参数校验、异常捕获与步长熔断:
1 | import json |
工具设计的五项工程实践原则
在构建工具集时,必须避免将庞杂的底层 API 无节制地开放给模型。以下是保障系统稳定性的五条实践标准:
- 高内聚单职责:工具功能力求原子化。不要设计一个名为
do_everything_with_db并接收任意自然语言描述的宽泛工具,应拆分为fetch_user_by_id与update_order_status等边界确定的接口。 - 严格的入参约束与字段描述:参数类型必须明确使用字符串、数值、布尔或枚举(Enum),避免使用自由格式的任意 Object。在参数字段描述中注明取值范围与单位(如“秒还是毫秒”、“元还是分”)。
- 输出信噪比控制(Payload Truncation):如果下游接口返回了 500 行堆栈或 2MB 的原始 JSON,严禁原样序列化后丢进模型上下文。应在 Harness 侧进行数据提炼,仅返回关键状态码、计数器与前 3 条核心记录,其余持久化到底层日志中,防止无意义数据冲垮模型的注意力工作区。
- 副作用沙箱与审批拦截:明确划分“只读操作”与“写入操作”。针对格式化磁盘、删除数据库、批量发送邮件等破坏性动作,必须在 Harness 侧配置拦截器,接入人工确认(Human-in-the-loop)或只读沙箱。
- 对模型返回内容保持零信任:即使参数通过了 JSON Schema 校验,Harness 依然要进行越权检测(如校验请求的
tenant_id是否属于当前操作者)。永远不要假设模型生成的参数必然合规。
思考题与工程自测
在梳理自己的 Agent 架构时,可对照排查以下场景:
- 当模型返回的
arguments缺失了required字段时,你的 Harness 是直接抛异常崩溃,还是把 JSON Schema 报错信息作为role: "tool"回传给模型让其自纠纠偏? - 如果在执行并行工具时,第 1 个工具成功耗时 100ms,第 2 个工具耗时 5000ms,你的系统是否配置了并发限制和单工具超时时间?
- 在厂商 API 偶尔返回 HTTP 500 或网络抖动重试时,你的 Harness 是否具备幂等性控制,以防止同一个带副作用的工具被重复触发执行两次?