
Planning、Reflection、RAG 分别解决什么问题:分清 Agent 系统的职责边界
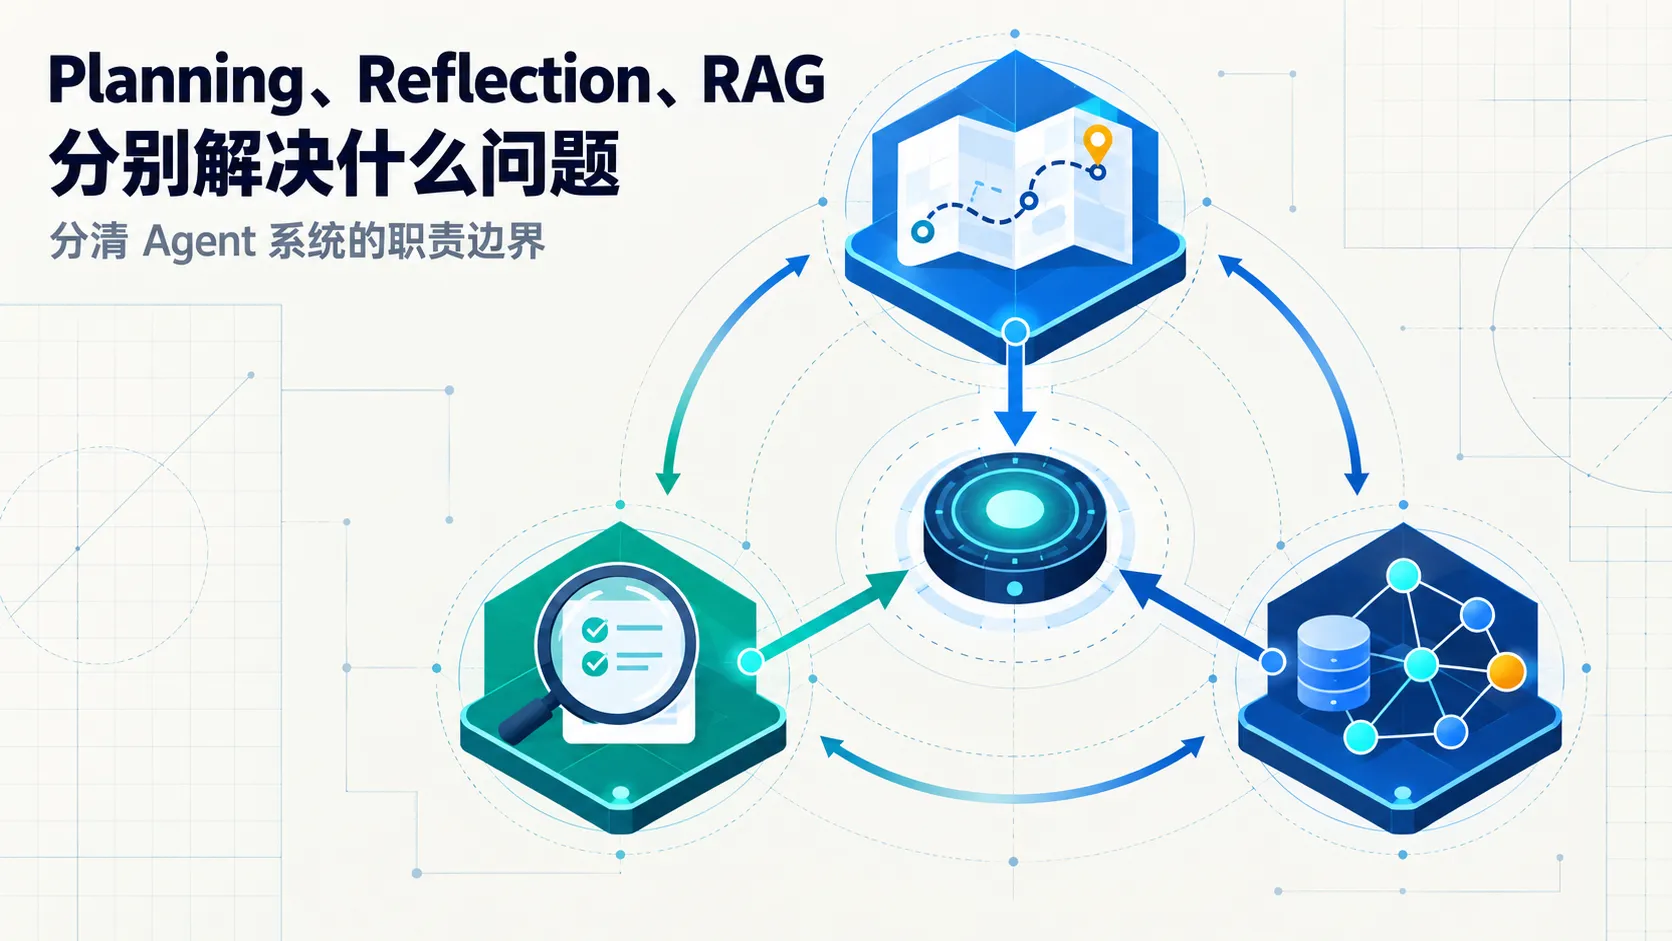
Planning、Reflection、RAG 分别解决什么问题:分清 Agent 系统的职责边界
Asaakii本文是「Agent 基础与工程」系列专栏的第 7 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在构建较复杂的 Agent 系统时,Planning(任务规划)、Reflection(自省反思)与 RAG(检索增强生成)常被打包作为“高级智能体”的标准配置。然而,如果在系统设计初期没有明确这三者的职责边界与失效模式,极易在工程落地中产生典型的能力错配:
- 外部事实缺失时,试图通过“让模型多思考几轮 Planning”来解决知识盲区,导致一本正经地编造幻觉;
- 能够通过确定性单元测试或正则断言校验的输出,强行引入另一个大模型执行 Reflection,导致推理延迟倍增且校验者容易对生成者盲目附和;
- 面对高度不确定的动态环境,试图在第一轮生成包含数十个子步骤的超长静态计划,第一步执行出错便导致整体链路崩溃。
明确三者的本质分工,是构建高效、确定性交付系统的关键前提。
核心职责解耦:三元协同架构
从系统工程角度看,三者分别向大模型注入了三种截然不同的确定性能力:
  flowchart TD
    subgraph Goal ["任务输入"]
        G[用户复合目标]
    end

    subgraph Triad ["核心能力三元组"]
        P["Planning 规划流<br/>【解决拓扑与控制】<br/>决定下一步做什么、按什么顺序推进"]
        R["RAG 知识检索流<br/>【解决事实与依据】<br/>为推理提供缺失的上下文与私有数据"]
        C["Reflection 评估反思流<br/>【解决质量与边界】<br/>检验当前动作或结果是否正确合规"]
    end

    subgraph Exec ["执行中枢"]
        E[Agent Harness 执行引擎]
        T[外部工具与代码沙箱]
    end

    G --> P
    P -->|任务子步骤指令| E
    E <-->|发起检索 / 注入事实| R
    E <-->|调用工具 / 产生观测| T
    E -->|提交中间结果| C
    C -->|评估未通过: 附带错误诊断重定向| P
    C -->|评估通过: 提交最终交付| Out[最终成功交付]
| 核心组件 | 核心解题域 | 输入 | 输出 | 典型失败模式 |
|---|---|---|---|---|
| Planning(规划) | 动作拓扑与调度 | 原始目标、当前状态、可用工具清单 | 结构化任务分解(DAG 或步骤序列) | 过度规划(Over-planning):假设前提过多,一旦环境扰动计划全部失效 |
| RAG(检索) | 外部事实与上下文注入 | 检索 Query、过滤条件 | 相关的文本切片(Chunks)与结构化元数据 | 上下文污染(Context Pollution):召回过多低质量或矛盾切片,冲垮注意力 |
| Reflection(自省) | 输出断言与收敛保证 | 执行结果、验收标准、历史轨迹 | 评分、布尔断言、归因诊断(Critique) | 盲目确认(Sycophancy):反思模型对生成模型的错误保持附和与妥协 |
1. Planning:任务拓扑分解与动态编排
Planning 的本质是将复杂的高维目标降低到当前工具能够直接处理的粒度。
常见的三种 Planning 模式
- 先规划后执行(Plan-and-Solve / 一次性分解):
- 流程:在启动执行前,由 Planner 模型一次性将目标切分为子任务列表(Step 1 到 Step N),随后由 Executor 严格按序执行。
- 适用场景:依赖关系固定、不确定性极低的批处理任务(例如“下载文件
解压 解析 CSV 导入 MySQL”)。 - 缺点:对运行期异常极度脆弱。
- 交替式动态步进(Dynamic Step-by-step / ReAct):
- 流程:模型不预先锁定全量步骤,而是执行一次
Thought $\to$ Action $\to$ Observation,根据当前观察到的真实数据,现场决定下一步动作。 - 适用场景:调试排障、网页探索、复杂信息调研。
- 缺点:容易在局部陷入死循环,步数不可控。
- 流程:模型不预先锁定全量步骤,而是执行一次
- 分层式规划(Hierarchical Planning / Supervisor-Worker):
- 流程:顶层规划者(Supervisor)维护全局高阶里程碑,底层执行者(Worker)在受控的局部小循环内解决单点子任务,定期向上层汇报状态并触发重新规划(Replanning)。
- 适用场景:软件工程开发、复杂业务研报撰写。
2. Reflection:质量断言与错误纠偏
很多系统在模型产出内容后不做任何检验便直接返回给用户,导致幻觉或语法错误直接暴露。Reflection 是在系统闭环中建立的质量防护栅栏。
生产级 Reflection 的三种实现层级
  flowchart LR
    subgraph Level1 ["L1: 确定性程序断言 (Deterministic Guards)"]
        D1[编译器报错 / 单元测试 / JSON Schema / 正则断言]
    end

    subgraph Level2 ["L2: 专职评估模型 (Specialized Critic)"]
        D2[独立 System Prompt 的 Evaluator / 针对特定 Rubric 打分]
    end

    subgraph Level3 ["L3: 经验沉淀闭环 (Reflexion with Verbal Memory)"]
        D3[将失败归因写入 Episodic Memory 供下轮 Prompt 规避]
    end

    Level1 -->|最优先选用: 零幻觉/极快| Level2
    Level2 -->|语义层质检| Level3
在工程实践中,永远优先使用代码驱动的确定性断言(L1),而非无节制地调用 LLM 进行模糊复盘(L2)。例如:
- 校验 SQL 是否符合语法,直接调用
sqlparse或在只读连接上执行EXPLAIN,而不是让模型“检查一下这段 SQL 写得对不对”; - 校验代码修复是否生效,直接运行对应的测试用例(
pytest),依据退出码判断; - 只有当评估对象属于主观自然语言质量(如“回复是否符合品牌语调”、“总结是否遗漏核心事实”)时,才下沉至专职的 Critic 模型。
3. RAG:事实与参数外知识注入
RAG 在 Agent 系统中的角色不是简单的“向量召回”,而是作为一种按需调用的感知工具(Agentic RAG)。
在普通 RAG 流水线中,检索动作是预先固化的:接收用户输入
而在 Agent 架构中,RAG 表现为一个或多个具名工具:
search_product_manual(query="错误码 0x44")query_customer_profile(user_id="U8901")
模型只有在自主判断“当前已知事实不足以回答问题”时,才会主动发起检索调用,并根据召回结果的质量决定是否需要改写关键词重新发起二次检索。
模块协同实战:代码级调度实现
以下通过 Python 演示一个清晰解耦的闭环处理框架,完整呈现 Planning、RAG 注入、Execution 与确定性 Reflection 的协同推进:
1 | import json |
工程选型与避坑决策树
面对新业务需求时,通过以下决策矩阵定位所需组件,避免概念堆砌:
1 | 遇到系统瓶颈时: |
系列导航与参考
喜欢这篇文章的人也看了
评论
匿名评论隐私政策
✅ 你无需删除空行,直接评论以获取最佳展示效果





