单 Agent 和多 Agent 的边界:判断何时真正需要多智能体架构
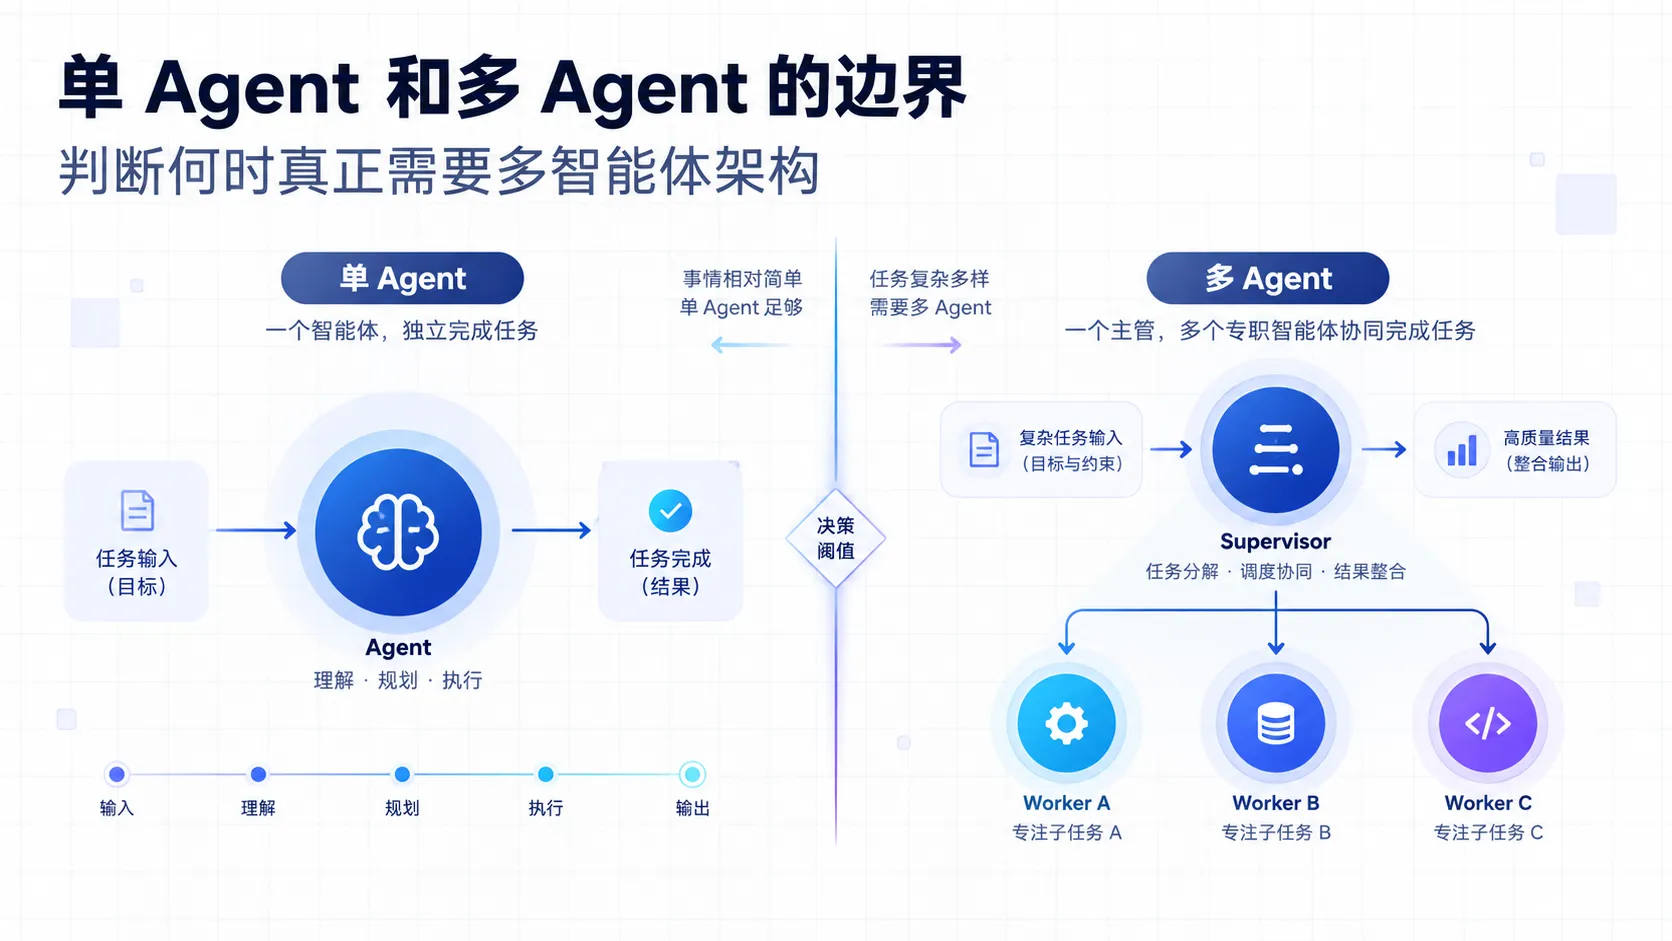
单 Agent 和多 Agent 的边界:判断何时真正需要多智能体架构
Asaakii本文是「Agent 基础与工程」系列专栏的第 8 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在智能体开发领域,多智能体(Multi-Agent System)常被设计成充满戏剧色彩的“虚拟公司”:Prompt 赋予不同模型“产品经理”、“架构师”、“程序员”、“测试工程师”等拟人化设定,彼此在聊天室内互相客套、多轮对话。
在演示场景中,这类设计具有极佳的观赏性;但在生产环境中,无约束的“拟人化自由交流”往往直接带来不可控的系统灾难:Token 消耗呈指数级膨胀、端到端响应延迟飙升至分钟级、模型之间互相推诿产生死锁,且整个分布式链路极难进行因果排障与断点恢复。
从分布式系统和软件架构的本质来看,多 Agent 绝非角色扮演玩具,而是分布式计算中的上下文隔离(Context Isolation)、权限隔离(Privilege Separation)与并发控制策略。
选型基准:单 Agent 与多 Agent 核心维度权衡
在决定是否引入多 Agent 之前,必须在以下关键工程指标之间做出评估:
| 维度 | 单 Agent(Single-Agent + Tools) | 多 Agent(Multi-Agent Architecture) |
|---|---|---|
| 状态集中度 | 全局单一 AgentState,状态完全确定且易于持久化和回溯 |
分布式状态,需处理子智能体之间的通信协议与数据一致性 |
| Token 成本 | 线性消耗,受限于当前单次任务的步数上限 | 显著放大,存在跨智能体上下文冗余传递与协调开销 |
| 端到端延迟 | 取决于模型单轮耗时与工具调用深度(通常几秒到十几秒) | 串行级联时延迟成倍叠加;仅在并发扇出(Map-Reduce)时具备吞吐优势 |
| 可观测性与排障 | 线性调用追踪,一次请求对应一组有序的 Span | 分布式链路追踪(Distributed Tracing),排查难度陡增 |
| 上下文利用效率 | 随着工具与交互轮次增多,容易发生注意力分散(Context Pollution) | 上下文物理隔离:每个子智能体只承载局部任务的专有工作集 |
| 适用边界 | 目标明确、步骤紧凑、单上下文可容纳的常规任务(占 80% 业务) | 上下文超限、异构权限、并行检索、独立红蓝博弈的复杂大任务 |
何时坚守单 Agent 架构
绝大多数生产级业务在初期都应采用“单 Agent + 确定性状态机 + 丰富工具集”架构。
如果任务满足以下特征,强行拆分多 Agent 只会增加系统熵增:
- 状态具有强前因后果依赖:后一步的操作完全基于前一步的准确输出,且中间数据体积小(例如:查询订单状态
查询退款规则 提交退款申请)。 - 工具总数可控(通常少于 15 个):只要每个工具的描述清晰、入参结构强类型化,当前主流顶尖模型完全具备在单上下文中精准调度十几个工具的能力。
- 系统首先追求 SLA 确定性与低成本:工业级业务通常对 P95 延迟(如必须在 3 秒内响应)和单次调用成本有严苛限制。单 Agent 能够杜绝模型间无效客套带来的资源浪费。
何时必须切换至多 Agent 架构
多 Agent 真正产生架构价值的场景,本质上是遇到了单 Agent 的物理极限。以下四种情况属于典型的架构分水岭:
1. 上下文物理超限与噪声隔离(Context Isolation)
在复杂场景中,子任务可能需要吞吐巨大的局部上下文:
- 任务 A(代码排查):需要读取 10 个源码文件,产生 60,000 Tokens;
- 任务 B(运维日志):需要检索 300 条实时日志,产生 40,000 Tokens。
如果将这些数据全部塞入同一个单 Agent 上下文,总 Token 量迅速突破 100k,不仅触发昂贵计费,而且模型极易出现“迷失在中间(Lost in the Middle)”的注意力涣散,无法准确提取关联信息。
多 Agent 解法:主智能体派发子任务,子智能体在完全独立的隔离上下文中执行密集读取,最终仅向主智能体回传提炼后的 500 字结构化摘要,主上下文体积始终维持在几千 Tokens 的健康区间。
  flowchart TD
    subgraph Master ["主智能体 (Supervisor)"]
        S[总控调度器]
    end

    subgraph SubA ["子智能体 A: 代码分析 (Worker)"]
        A_Ctx["独立上下文 (60k Tokens 源码)"]
        A_Exec[分析定位 Bug 原因]
    end

    subgraph SubB ["子智能体 B: 日志审计 (Worker)"]
        B_Ctx["独立上下文 (40k Tokens 监控日志)"]
        B_Exec[提取核心异常堆栈]
    end

    S -->|派发分析子任务| A_Exec
    S -->|派发日志检索子任务| B_Exec
    A_Exec -->|回传提炼摘要: 仅 300 Tokens| S
    B_Exec -->|回传提炼摘要: 仅 200 Tokens| S
2. 权限与物理网络隔离(Privilege Boundaries)
不同操作在企业安全体系中具有完全不同的安全等级:
- 面向公网用户的客服 Agent:完全只读,部署在 DMZ 隔离区;
- 生产环境运维 Agent:具备执行 Shell 命令、重启微服务或修改数据库的敏感权限,部署在受限内网核心区。
两者绝不能合并为一个单 Agent。必须通过专职的审批中继将意图结构化签名后,传递给内部特定的受控 Agent 执行,实现最小特权原则(Principle of Least Privilege)。
3. 并发扇出与横向扩展(Parallel Fan-out / Map-Reduce)
当任务能够拆解为完全互不依赖的子目标时,单 Agent 的串行循环会造成巨大延迟瓶颈。例如“全网横向对比 10 款竞品的技术架构”:
- 单 Agent 串行查询:耗时
- 多 Agent 并发扇出(Fan-out):由调度中心同时启动 10 个并发子 Agent 执行信息检索,整体耗时收敛至最慢节点的耗时(约 35s),最后由聚合节点汇总。
4. 非对称认知与盲测评估(Adversarial Validation)
当需要对产出内容进行严苛的对抗质检时,必须采用独立的 Critic Agent:
- 认知偏差规避:如果让同一个 Agent 既负责生成方案又负责复核,模型存在极强的“证实偏差”(Sycophancy),倾向于认为自己的逻辑无懈可击;
- 盲测机制:Critic Agent 不接收生成者的中间思考过程(CoT),仅接收原始验收标准与最终交付物,以纯粹的外部视角进行挑刺和安全渗透测试。
工业级多 Agent 常见拓扑架构
在实际落地中,拓扑结构直接决定了系统的可维护性。以下是四种典型模式:
  flowchart LR
    subgraph T1 ["1. 主从分发型 (Supervisor-Worker) 【最推荐】"]
        S1[Supervisor] --> W1[Worker A]
        S1 --> W2[Worker B]
    end

    subgraph T2 ["2. 管道流水线 (Sequential Pipeline)"]
        P1[Agent 1] -->|结构化合同| P2[Agent 2] -->|结构化合同| P3[Agent 3]
    end

    subgraph T3 ["3. 网状点对点 (P2P Mesh) 【严禁在生产中使用】"]
        M1[Agent A] <--> M2[Agent B]
        M2 <--> M3[Agent C]
        M3 <--> M1
    end
- 主从分发型(Supervisor-Worker):中心 Supervisor 掌握全局任务状态,负责拆解目标、派发给专业 Worker、汇总结果并决定终态。Worker 之间互不可见,不发生横向通信。这是工业界最推崇、稳定性最高的设计。
- 管道流水线型(Sequential Pipeline):各 Agent 按照固定 DAG 前后级联,上游输出作为下游输入。环节之间必须使用强类型 JSON Schema 进行严格的契约校验。
- 分层树状调度(Hierarchical Tree):Supervisor 下挂 Secondary Manager,进一步细分领域 Worker,适用于百万行级超大规模代码重构或集团级业务自动化(如 OpenClaw、Pi 框架的 Subagent 派发)。
- 网状点对点型(P2P Mesh):Agent 之间广播消息自由交流。在生产系统中应严厉禁止这种无中心拓扑,它极易陷入死循环震荡。
生产级 Supervisor-Worker 模式原生实现
以下使用原生 Python 演示一个标准的 Supervisor-Worker 架构。代码展示了如何做到子任务并发执行、上下文物理隔离与结构化数据汇聚:
1 | import asyncio |
架构演进路线图:从简至繁的迁移策略
在架构设计中,应当遵循极简优先、按需裂变的演进路径:
1 | 阶段 1: Single-Agent + Hardcoded Python Workflow (确定性业务用代码写死,局部用模型) |