Agent Infra:从 Harness 运行时到生产环境基础设施
Agent Infra:从 Harness 运行时到生产环境基础设施
Asaakii本文是「Agent 基础与工程」系列专栏的第 9 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
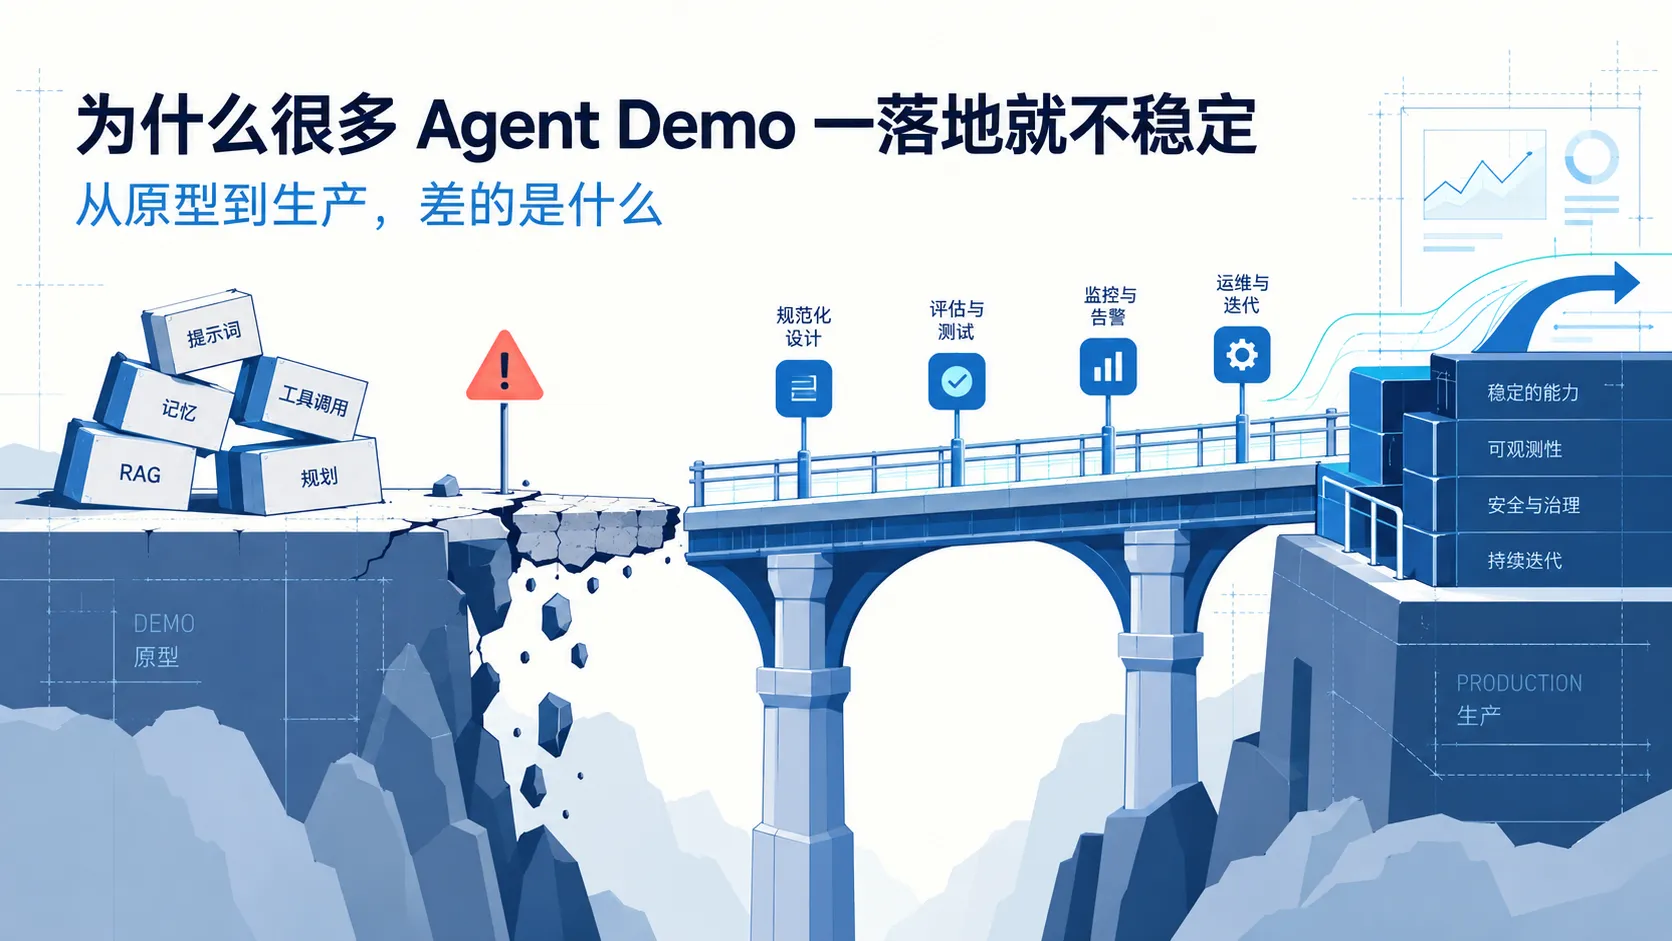
在本地编写一个 while True 的 Agent 循环通常只需要几十行代码:组装提示词、发起模型调用、解析工具、执行并打印输出。然而,当把这一套逻辑部署至企业生产环境时,系统会直接暴露在真实世界的分布式挑战之下:
- 运行中途工作节点(Worker Pod)发生 OOM 重启,未跑完的任务状态全部丢失;
- 模型 API 遭遇供应商网络抖动或 429 限流,任务直接崩溃引发级联失败;
- 含有写副作用的工具(如扣费、更新数据库)在重试过程中被触发多次,导致数据不一致;
- 模型生成的 Shell 命令逃逸出预期目录,破坏宿主文件系统。
解决这些问题不再属于模型算法或提示词工程的范畴,而是依赖承载运行时的底层基础设施(Agent Infrastructure)。
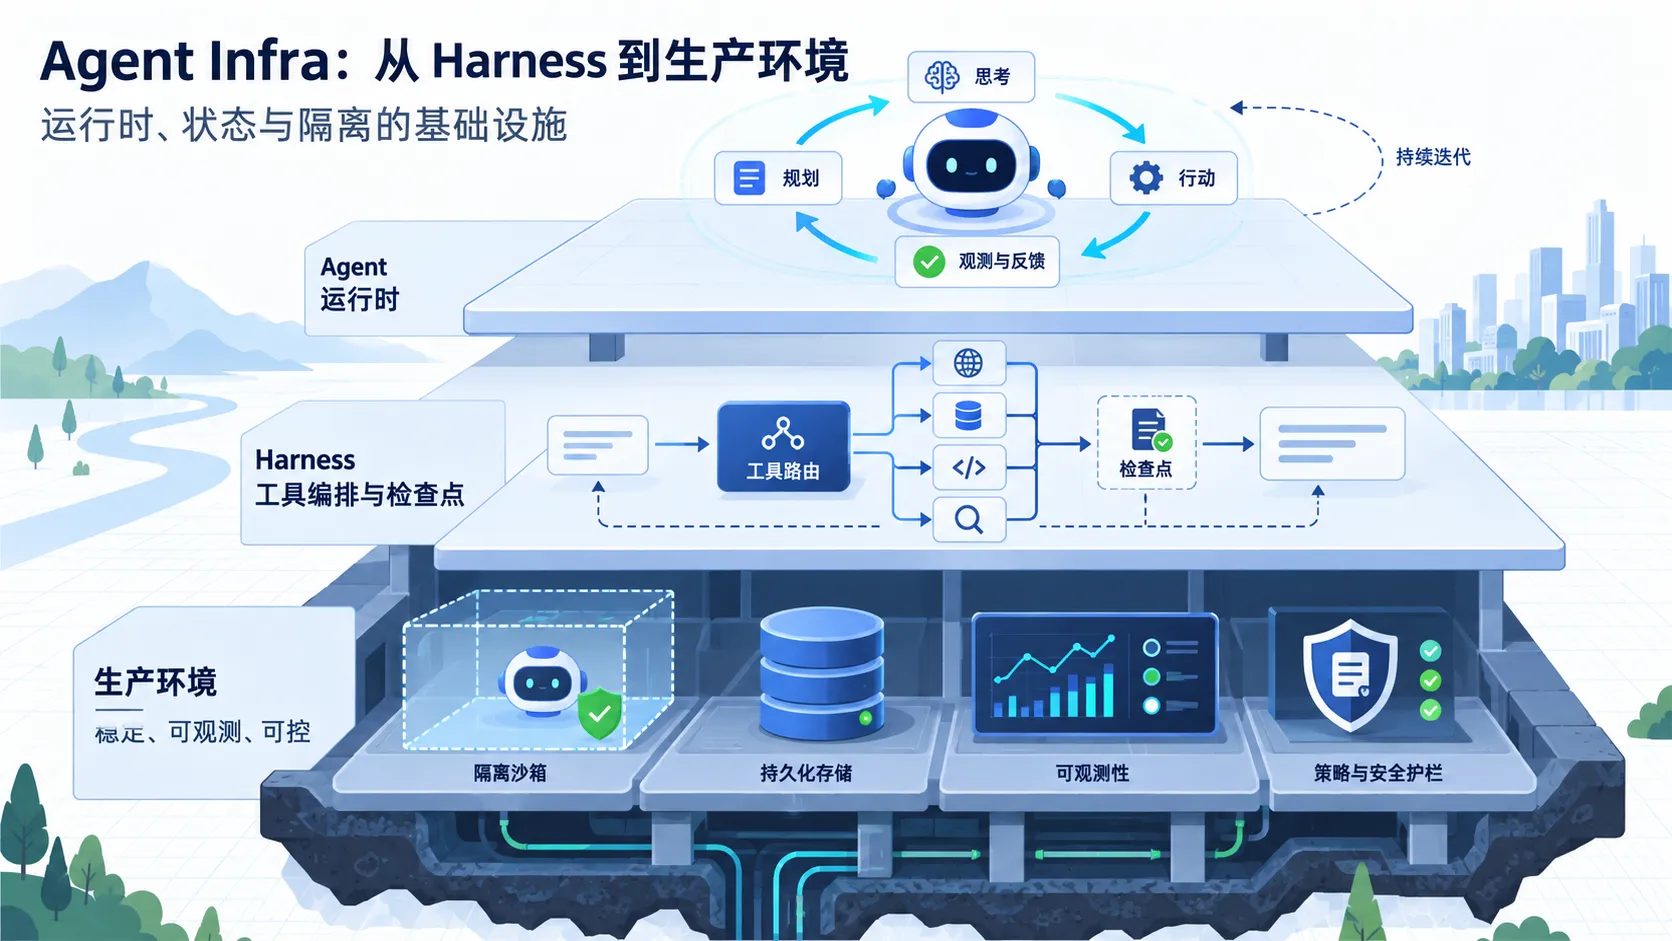
职责分层:Loop、Harness 与 Infra
将 Agent 系统稳定推向生产,必须明确划分三个截然不同的系统层次:
  flowchart TD
    subgraph Infra ["Agent Infra 生产基础设施层"]
        Sched[分布式任务调度器 (Temporal / Celery / Ray)]
        Store[(状态检查点存储 (Postgres / Redis))]
        Obs[可观测平台 (OTel / Langfuse)]
        Gate[多租户网关 / RateLimiter]
        Box[代码与网络执行沙箱 (Firecracker / Docker)]
    end

    subgraph Harness ["Agent Harness 运行时宿主层"]
        CtxMgr[上下文裁剪与装配引擎]
        ToolReg[工具注册表与安全拦截]
        StateMach[强类型状态机管理器]
        Ledger[幂等执行台账]
    end

    subgraph Loop ["Agent Loop 协议驱动内核"]
        LLM[模型单步推理]
        Disp[工具分派与结果聚合]
    end

    Sched --> Harness
    Harness --> Loop
    Loop <--> Harness
    Harness <--> Store
    Harness <--> Obs
    Harness <--> Gate
    Harness <--> Box
各层的职责边界与关注点对比如下:
| 层次 | 核心职责 | 输入与输出 | 典型技术栈 |
|---|---|---|---|
| Agent Loop(执行内核) | 推进模型决策与工具派发的单步状态转移 | 输入本轮消息,输出文本或工具调用声明 | 原生 Python 循环、LangGraph 节点 |
| Harness(运行时外壳) | 管理上下文装配、参数 Schema 校验、权限拦截与错误重试 | 维护局部内存轨迹与因果配对,控制步数预算 | Pydantic、自研 Agent Harness |
| Agent Infra(生产底座) | 提供集群任务持久化、节点自愈、分布式链路追踪、沙箱隔离与多租户审计 | 保证长生命周期任务高可用,防范资源耗尽与安全穿透 | Kubernetes、Temporal、PostgreSQL、OTel、Firecracker |
外部依赖治理:大模型 API 的生产管控
大模型 API 具备典型的弱网络、高延迟、波动大的特征。必须将其作为具有强故障倾向的外部服务来治理。
1. 超时控制四层矩阵
简单的 HTTP Client 超时设置(如 timeout=60s)无法应对流式长文本输出。必须拆分为四级超时防护:
  flowchart LR
    T1["1. Connect Timeout (TCP 握手: 3s)"] --> T2["2. TTFT Timeout (首 Token 到达: 15s)"]
    T2 --> T3["3. Inter-token Timeout (字符间隔断流: 5s)"]
    T3 --> T4["4. Global Task Deadline (单任务总超时: 300s)"]
- TCP Connect Timeout:限制建立底层 TCP/TLS 连接的时间(建议
); - TTFT(Time-To-First-Token)Timeout:请求发出到服务端吐出第一个 SSE 数据包的时限(针对深度思考模型可放宽至
- Inter-Token Timeout:相邻两个 SSE Chunk 之间的传输间断上限(若超过
无任何字符推送,判定为中间网络僵死,主动断开); - Global Task Deadline:由外层调度器赋予当前任务全局硬性时限(如最多运行 10 分钟),随请求向下传递,防止死循环无限消耗费用。
2. 抖动重试与退避策略(Jittered Backoff)
面对模型厂商的 HTTP 429(Rate Limit)与 5xx 服务端错误,严禁使用固定间隔重试,必须采用带随机抖动的指数退避(Exponential Backoff with Full Jitter):
加入随机抖动能打散并发请求高峰,避免成百上千个 Agent Worker 在同一时刻重试引发雪崩。
状态持久化与断点续跑(Checkpointing)
在执行需要数十分钟的长程任务时,计算节点宕机是常态。生产级 Infra 必须支持步进检查点(Step-level Checkpoint)。
检查点持久化机制
每当一轮工具调用完成、返回结果被写入轨迹之后,Harness 必须先将此时的 AgentState 序列化并存入持久化存储(如 PostgreSQL),再发起下一轮模型请求:
  sequenceDiagram
    participant H as Agent Harness
    participant DB as Postgres (State Store)
    participant L as Model API
    participant W as Worker Process

    H->>L: 发起推理
    L-->>H: 返回工具调用
    H->>H: 执行工具
    H->>DB: 写入 Checkpoint (State, Messages, Step=N)
    Note over W: 突发断电 / Pod 崩溃重启
    W->>DB: 检索未完成任务 (TaskID, Step=N)
    DB-->>W: 恢复完整上下文与状态机
    W->>L: 基于 Step N 状态继续发起下一步
幂等执行台账(Idempotency Ledger)
断点恢复中最危险的隐患是副作用工具的重复执行。
例如任务包含三个步骤:
- 扣减账户资金;
- 生成结算报表;
- 发送确认邮件。
若步骤 1 执行完毕后系统崩溃,重启恢复时若重新回放全部历史,可能导致资金被扣减两次。
工程解法:在 Harness 内部维护幂等执行台账。任何带副作用的工具在执行前,必须先在数据库中插入一条 PENDING 记录并生成确定性的幂等键(Idempotency Key):
重启恢复检测到该 Key 状态为 COMPLETED 时,直接跳过物理执行,返回台账中记录的历史输出。
执行环境隔离:沙箱(Sandbox)架构
当 Agent 具备执行 Python 脚本、Bash 终端命令或安装依赖包的能力时,必须构建严格的代码沙箱,杜绝逃逸到宿主操作系统。
常见沙箱隔离级别对比
| 技术方案 | 启动耗时 | 隔离级别 | 资源开销 | 适用场景 |
|---|---|---|---|---|
| 进程级受限(chroot / seccomp) | 弱(共享内核,易逃逸) | 极低 | 纯只读命令、受限计算 | |
| 标准容器(Docker / OCI) | 中等(共享宿主内核) | 低 | 常规本地开发工具、非多租户企业内网 | |
| 微虚拟机(MicroVM / Firecracker) | 强(独立硬件级虚拟化内核) | 较低 | 面向公网用户的任意代码执行(生产标配) | |
| 沙箱容器(gVisor / Kata Containers) | 强(拦截系统调用 / 独立内核) | 中等 | K8s 原生集成的多租户执行 Pod |
在网络层面,沙箱默认应配置禁止访问私网元数据服务(如 169.254.169.254)与内部内网 IP 段,仅允许经过白名单审核的外部网络出口。
生产级 Harness 持久化检查点实现
以下通过原生 Python 展示一个具备持久化检查点与崩溃恢复能力的 Harness 骨架:
1 | import json |
生产就绪检查表(Production Readiness Checklist)
在将 Agent 服务上线提供外部 SLA 前,需逐项验收以下基础设施指标:
- 状态持久化:计算节点被随手
kill -9后,重启 Worker 能否在 5 秒内精准拉起上下文断点继续执行? - 死循环熔断:单任务设置了硬性 Token 预算、工具调用上限与总超时时间,一旦超限立即阻断并告警?
- 调用全链路追踪:从收到用户输入到最终产出,每一次模型调用的 Request ID、Prompt Tokens、Completion Tokens 及工具执行耗时是否全部注入 OpenTelemetry Trace?
- 安全沙箱:运行代码的进程是否彻底剥离了宿主机 root 权限、隔离了物理文件系统并屏蔽了内网元数据接口?
- 幂等性保障:外部网络异常重试时,是否对扣减库存、转账等敏感动作通过 Idempotency Key 做了强拦截?