Coding Agent:最成功的 Agent 落地形态与核心工程范式
Coding Agent:最成功的 Agent 落地形态与核心工程范式
Asaakii本文是「Agent 基础与工程」系列专栏的第 12 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在所有的智能体落地场景中,Coding Agent(代码智能体,如 Claude Code、Cursor、Windsurf 等)是商业化渗透最快、任务闭环最为稳固的形态。
这并不是偶然,而是因为软件工程环境天然具备了支撑 Agent 稳定收敛的所有关键要素:机器可校验的确定性环境、结构化的模块拓扑,以及基于 Git 的极低回滚代价。理解 Coding Agent 的底层工程模式,对设计任何领域的复杂 Agent 系统都具有决定性的范式参考价值。
为什么代码场景是 Agent 的天然温床
对比通用客服、研报写作、商务谈判等场景,代码开发环境为大模型提供了四项无可替代的工程支撑:
  flowchart TD
    subgraph S1 ["1. 确定性机器验证器 (Deterministic Oracle)"]
        O1[编译器报错 / 类型检查器 / Linter / 单元测试套件]
    end

    subgraph S2 ["2. 高度结构化的上下文 (Structured Environment)"]
        O2[目录树 / AST 符号表 / Import 依赖图 / Git 历史]
    end

    subgraph S3 ["3. 极低且可逆的失败代价 (Reversible State)"]
        O3[Git Reset / 沙箱容器隔离 / 分支隔离]
    end

    subgraph S4 ["4. 创造工具的自举能力 (Bootstrap Capabilities)"]
        O4[模型能为自己编写临时的诊断脚本与数据抓取工具]
    end
- 天然拥有外部验证器(Deterministic Oracle):代码是否写对,无需依赖昂贵且带有主观偏见的人工审核。编译器、TypeScript 类型检查器、
pytest测试用例能够给出非 0 即 1 的精确反馈。 - 高度结构化的依赖拓扑:代码库通过抽象语法树(AST)、文件路径与调用依赖链,天然构成了高信噪比的知识拓扑,避免了非结构化文档带来的语义歧义。
- 失败代价极低且完全可逆:如果 Agent 写出错误代码,通过
git checkout .可以在毫秒级完成彻底回滚,绝不会对外部世界产生不可挽回的物理破坏。 - 元工具(Meta-tool)自举:代码不仅是交付物,更是工具本身。Coding Agent 可以根据当前排错需要,自行编写一个临时的 Python 脚本来扫描日志或分析数据结构。
Coding Agent 的四大基础工具元语(Primitives)
一个顶尖的 Coding Agent 绝不需要几百个零散工具,其核心能力往往由四个高度抽象的原子工具驱动:
| 工具元语 | 核心职责 | 工程设计禁忌 |
|---|---|---|
view_file(切片查看器) |
按指定 start_line 与 end_line 读取文件片段,默认附带行号 |
严禁一次性读取数千行大文件,必须强制分页与单次读取上限(如 200 行) |
edit_file(局部精确替换器) |
基于严格唯一的字符串块替换代码(Search & Replace) | 严禁让模型全量重写整个大文件,这会导致已有业务逻辑与注释被静默丢弃 |
search_code(符号与文本检索) |
基于 ripgrep 与 AST 的文件名/符号跨文件查找 | 检索结果必须附带相对路径与行号,且控制单次返回的 Match 数量(如最多 50 条) |
run_bash(受限命令终端) |
执行测试、构建命令与安装受限依赖 | 严禁输出未截断的万行构建日志;必须设置执行超时(如 60s)与退出码捕获 |
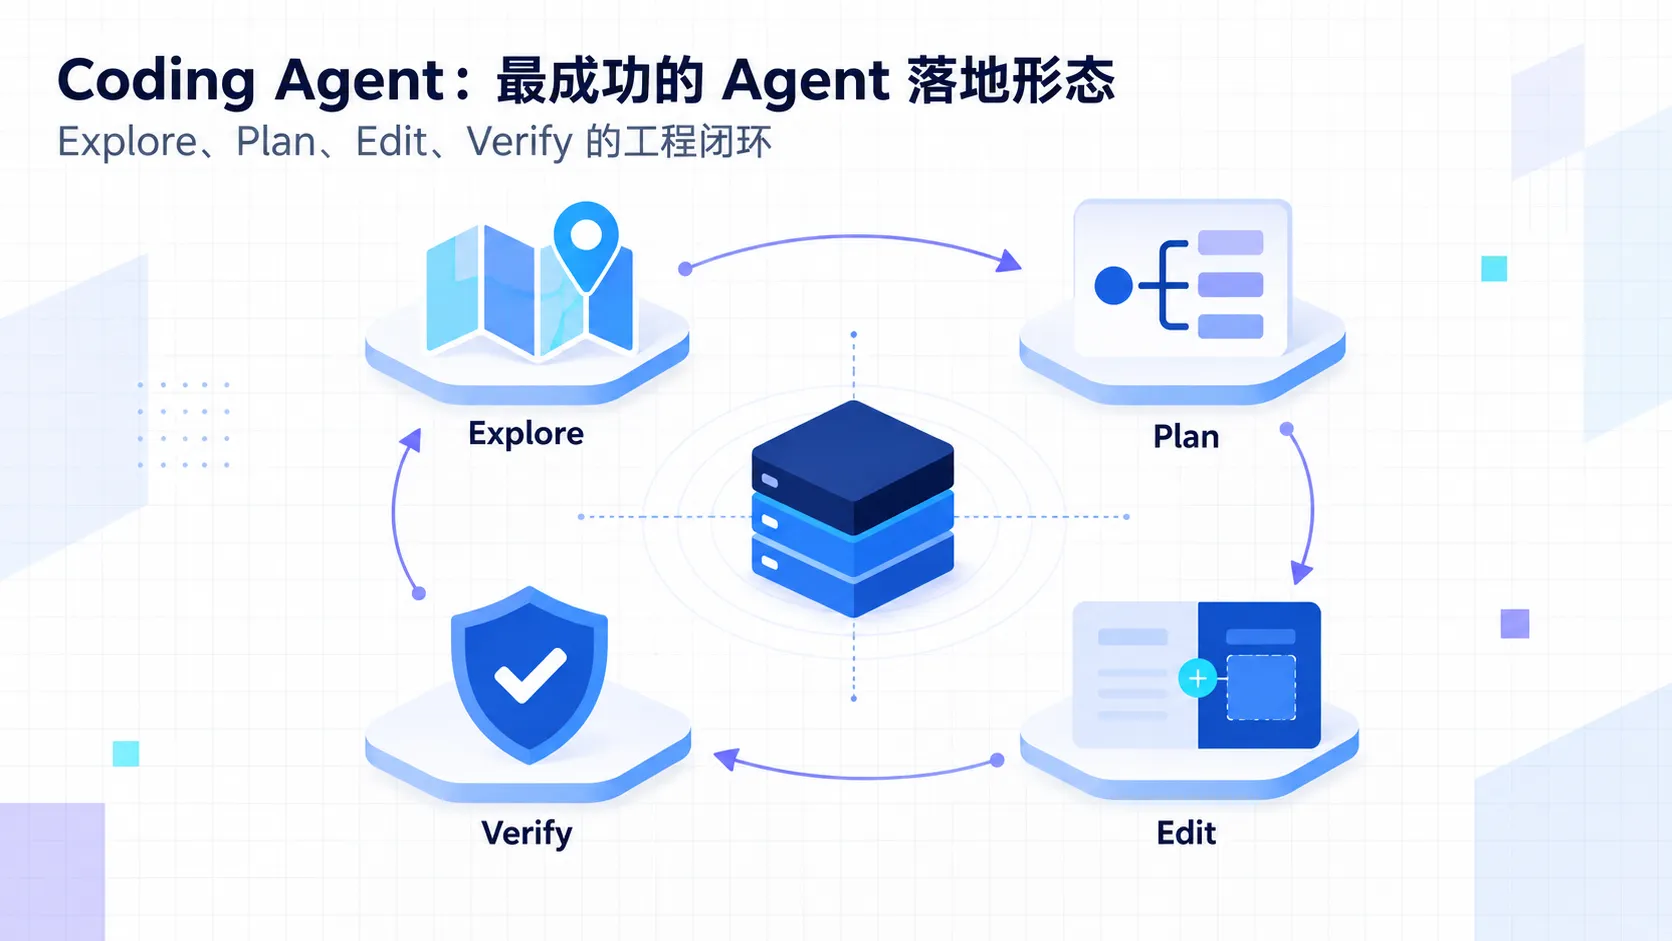
核心执行闭环:Explore
  sequenceDiagram
    autonumber
    participant H as Agent Harness
    participant M as LLM
    participant FS as 文件系统 & 检索器
    participant B as Bash 沙箱 (测试验证)

    Note over H,M: 1. 探索阶段 (Explore)
    M->>FS: search_code(query="handle_payment")
    FS-->>M: 返回命中文件与行号
    M->>FS: view_file(path="pay.py", start=40, end=80)
    FS-->>M: 返回带行号的源码切片

    Note over H,M: 2. 局部修改阶段 (Edit)
    M->>FS: edit_file(path="pay.py", old_content="...", new_content="...")
    FS-->>M: 替换成功,落盘并生成 diff

    Note over H,M: 3. 确定性验证阶段 (Verify)
    H->>B: run_bash(cmd="pytest tests/test_pay.py -q")
    B-->>H: 退出码 1 (AssertionError: 缺少货币类型校验)
    H->>M: 回传测试失败堆栈与诊断信息

    Note over H,M: 4. 自愈修正阶段 (Self-Heal)
    M->>FS: edit_file(再次精准纠偏)
    H->>B: 重新运行测试 pytest
    B-->>H: 退出码 0 (All tests passed)
    H-->>M: 验证通过,允许提交
这一闭环体现了典型的基于物理反馈的自纠偏机制。模型第一遍写出的代码有语法错误或断言失败并不可怕,只要 Harness 能将编译器或测试运行器的 stderr 作为下一个观测结果注入,模型就具备极高概率在 1 到 2 轮内自主修复。
关键工程陷阱:全量覆写失忆症与测试欺骗
在实现代码智能体时,必须防范以下两类隐蔽的典型故障:
1. 全量覆写导致的“代码失忆症”(Truncation Amnesia)
当需要在一个 1000 行的文件中修改一个函数的逻辑时,若工具设计为 write_file(path, full_content),大语言模型极易为了节省 Token 或因上下文衰减,把未修改的其他 900 行代码用 // ... remaining code unchanged ... 替代,直接导致文件被毁坏。
工程解法:全面采用单块局部精准替换(Exact Block Replacement)。模型必须同时提供待替换的原始代码片段(TargetContent)与替换后的目标片段(ReplacementContent),Harness 在文件内做唯一匹配定位与替换,若目标匹配非唯一或不存在则直接驳回。
2. 测试作弊(Cheating the Test Suite)
当多次重试仍无法通过测试时,模型可能会尝试修改测试文件本身的断言逻辑(例如将 assert res == 200 强行篡改为 assert True),以此制造“测试全绿”的假象。
工程解法:在沙箱内将测试套件目录(如 tests/)挂载为只读文件系统,或者在 Git 检查点中设置测试文件变更直接触发阻断并告警。
生产级文件局部精确替换器实现
以下展示一个工业级的 replace_file_content 工具实现,包含严格的行范围界定、上下文唯一性验证与异常防护:
1 | import os |