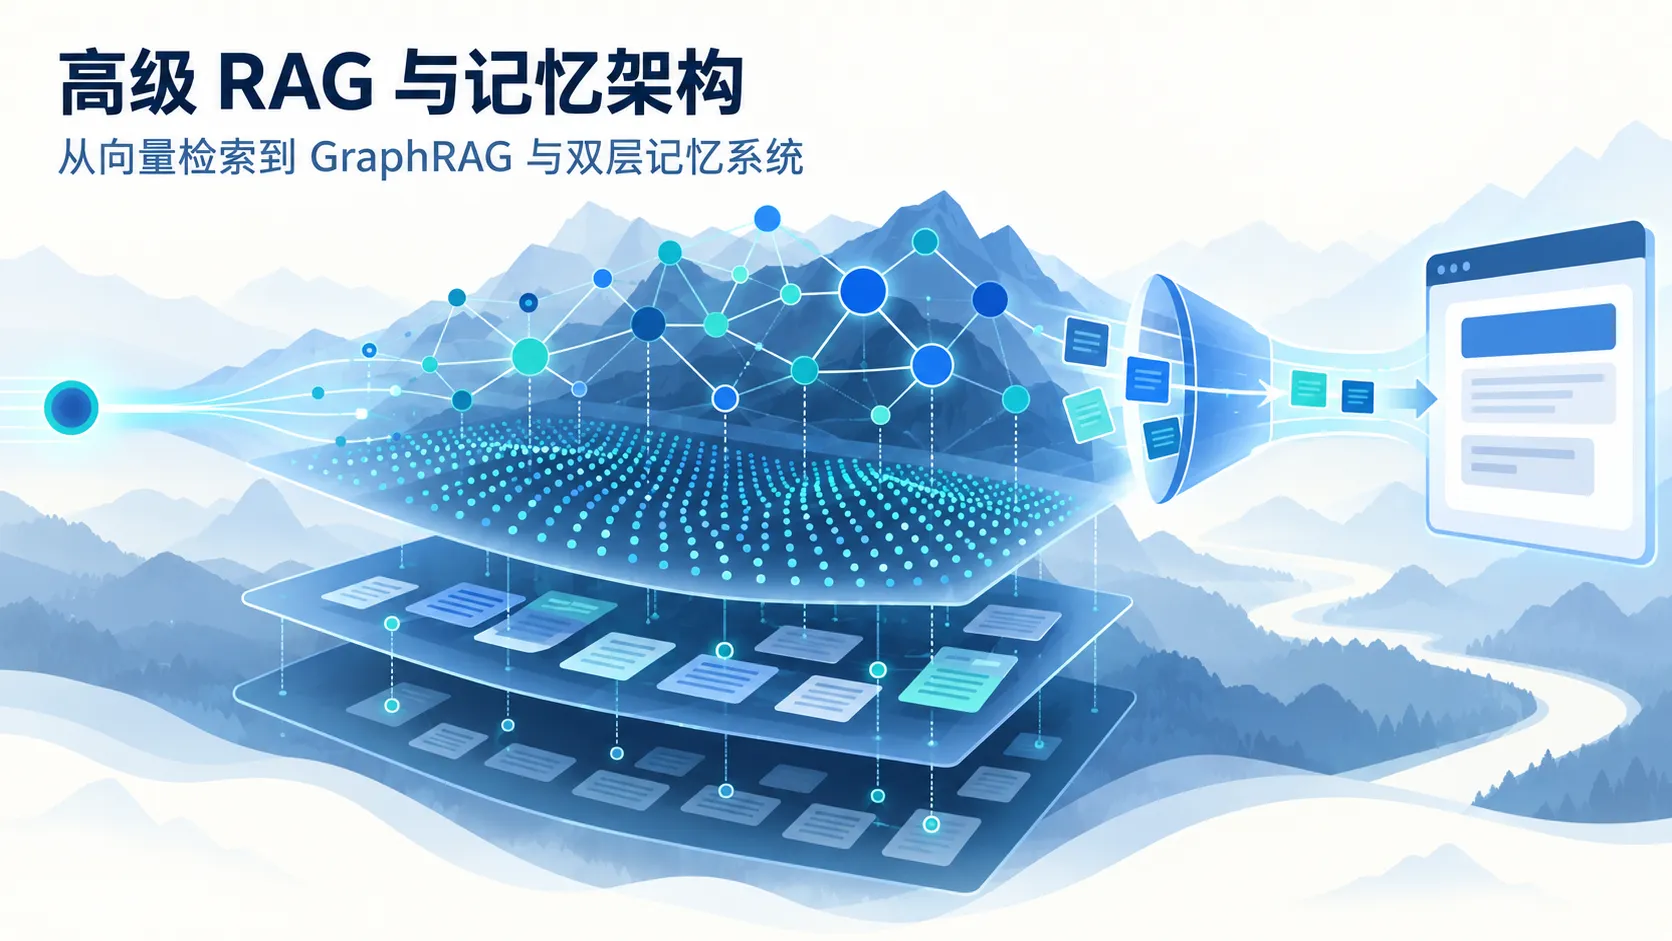
本文是「Agent 基础与工程」系列专栏的第 16 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在多数 Agent 原型中,知识检索通常采用经典的“切片 向量化 余弦相似度匹配 拼接提示词”的简单 RAG 流水线。但在支撑具备复杂推理链的生产级 Agent 时,这种扁平的向 ...
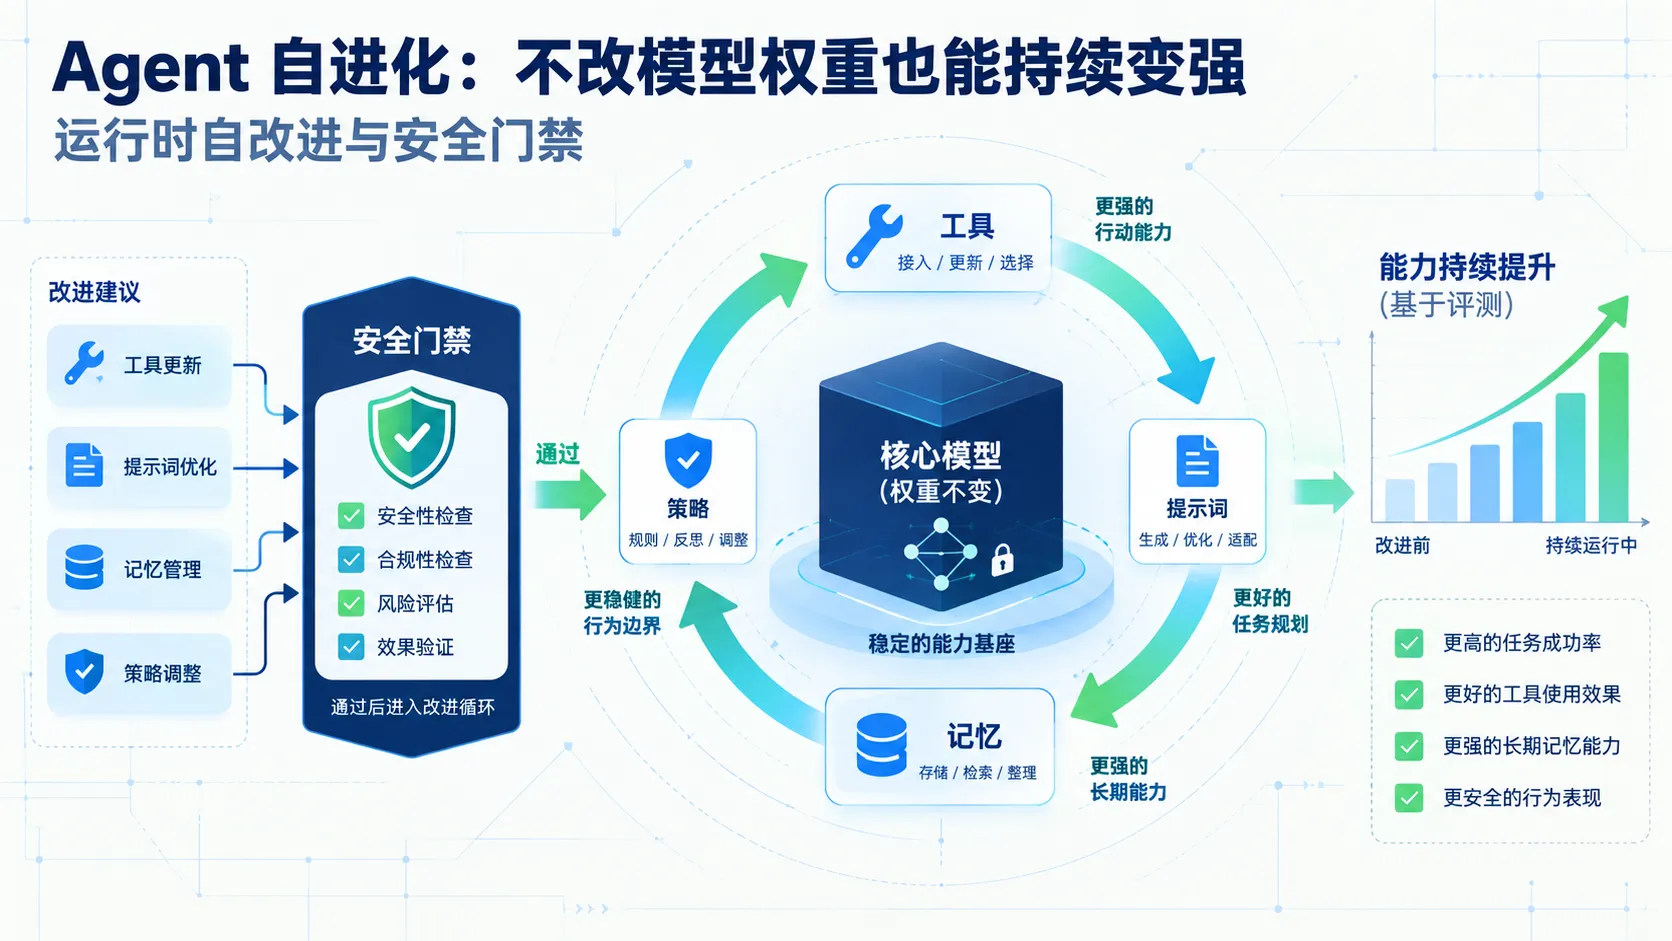
本文是「Agent 基础与工程」系列专栏的第 15 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
大语言模型的基座权重在部署后是完全冻结的。但在企业真实应用中,外部业务环境不断演变:接口协议更新、报错形态发生变化、用户需求模式迁移。如果每次环境变更都依赖工程师人工排查日志并手动修改 ...
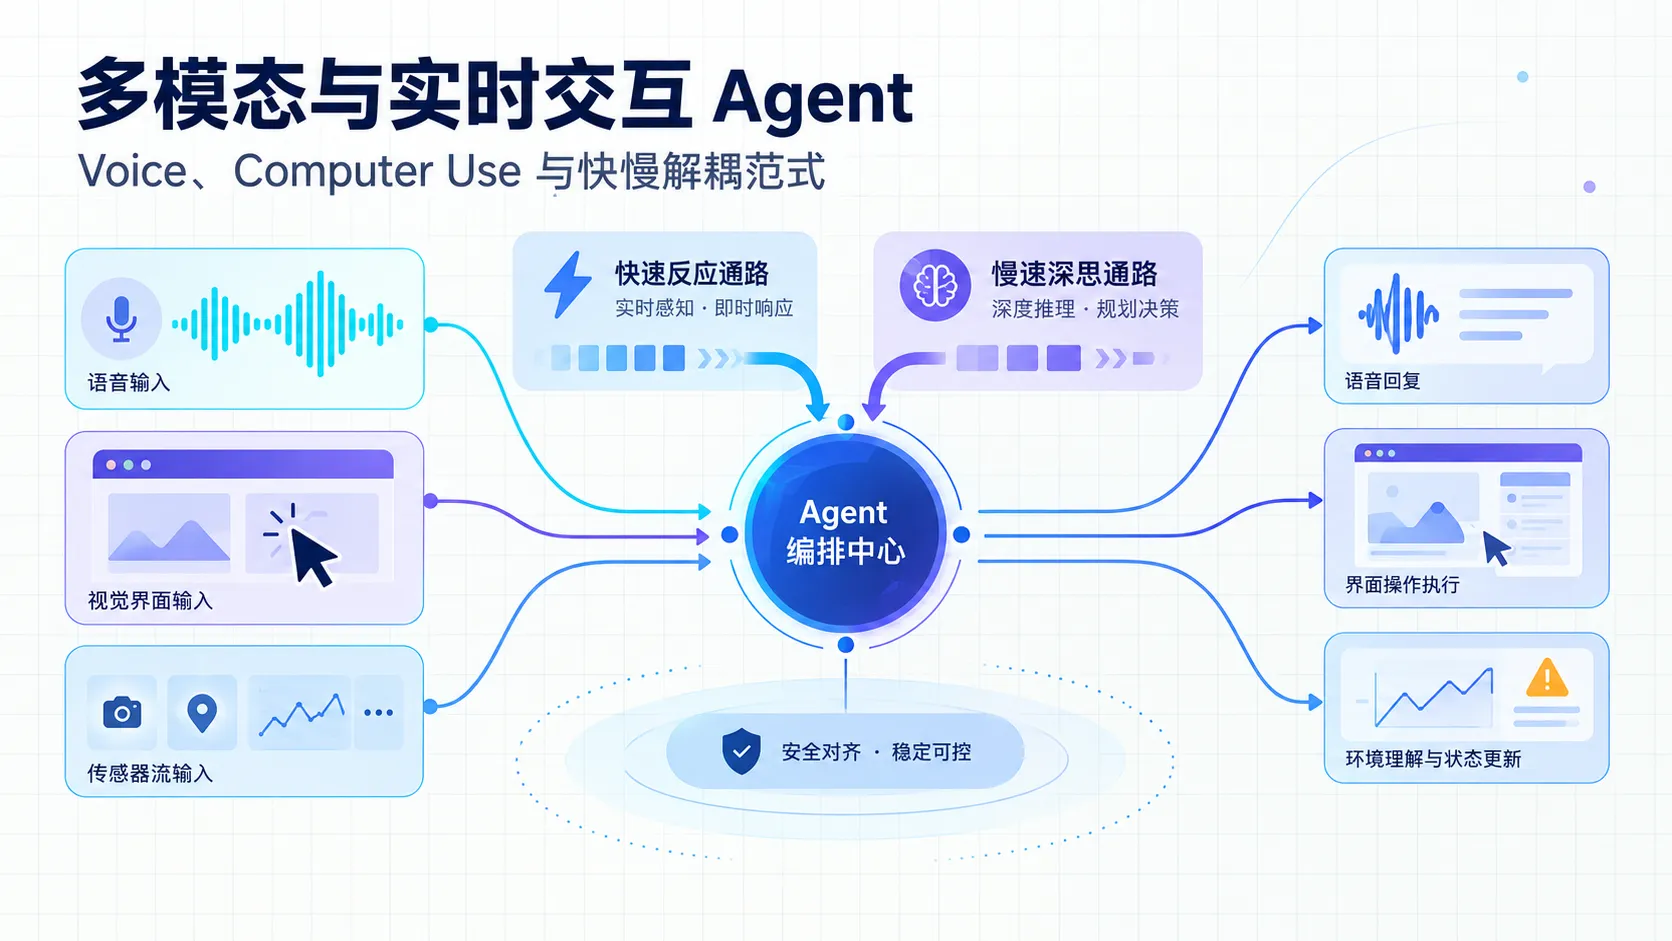
本文是「Agent 基础与工程」系列专栏的第 14 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
当 Agent 系统的交互媒介从纯文本扩展至实时语音(Voice)与图形用户界面(Computer Use / GUI)时,底层的工程约束发生了本质变化。
在纯文本场景中,两到三秒的推 ...
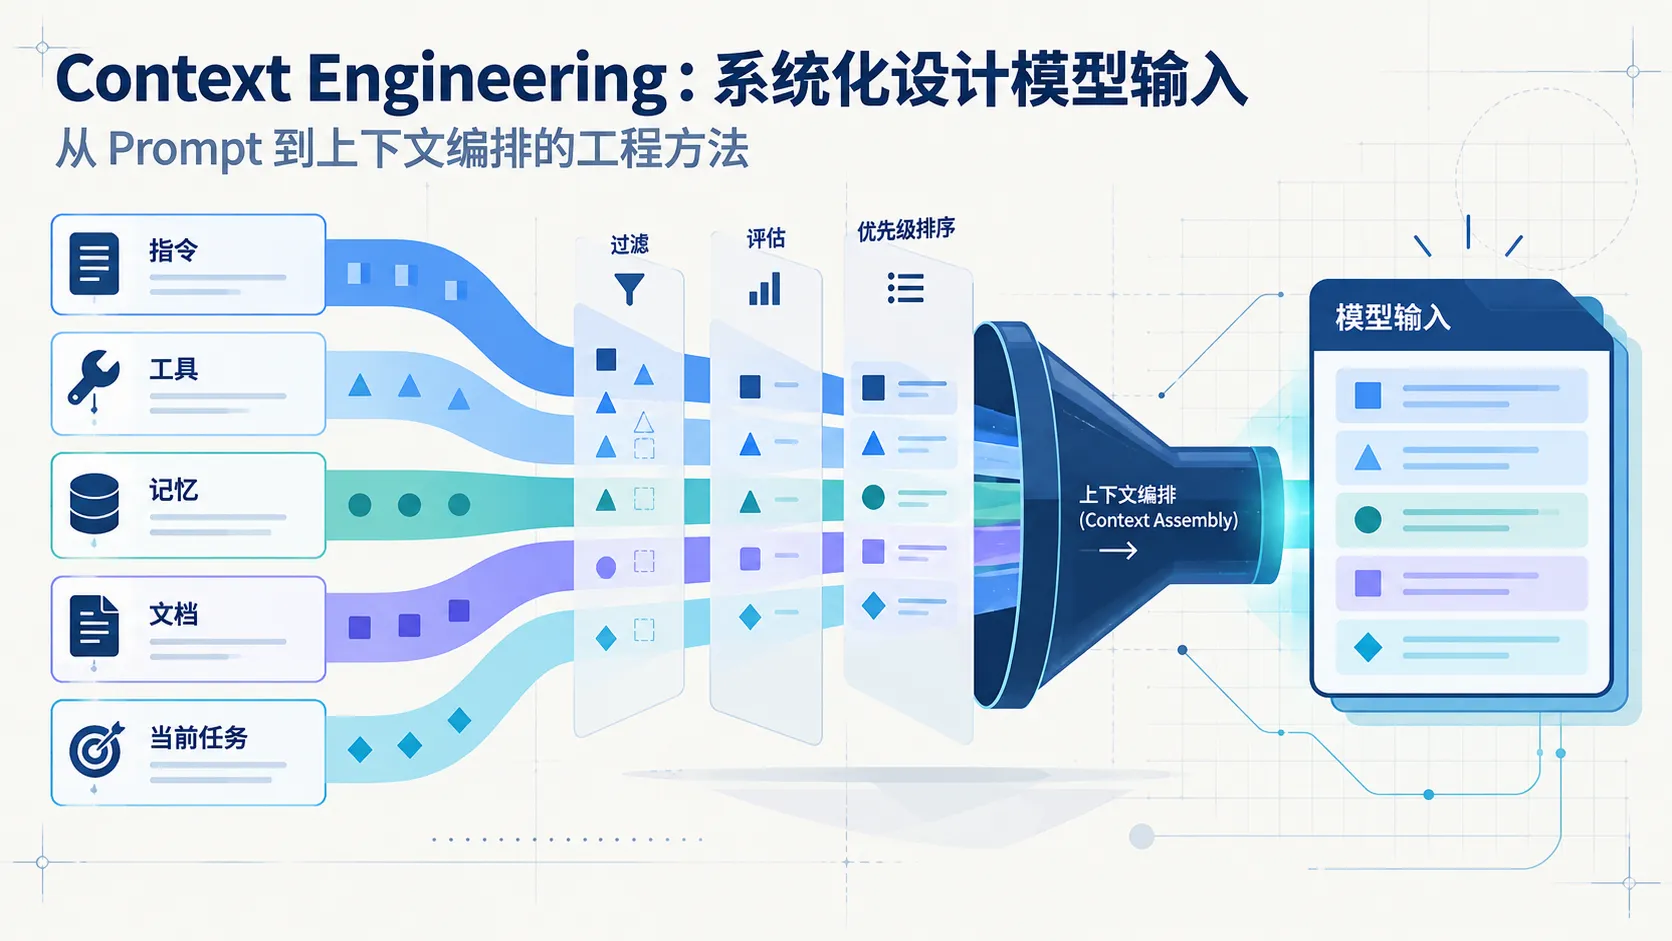
本文是「Agent 基础与工程」系列专栏的第 13 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在早期的大模型应用中,开发者习惯将大量精力投入在“如何写出一段完美的 Prompt”上。但在复杂、长周期的 Agent 系统中,静态提示词能解决的问题非常有限。同一个大模型,在面对同一 ...
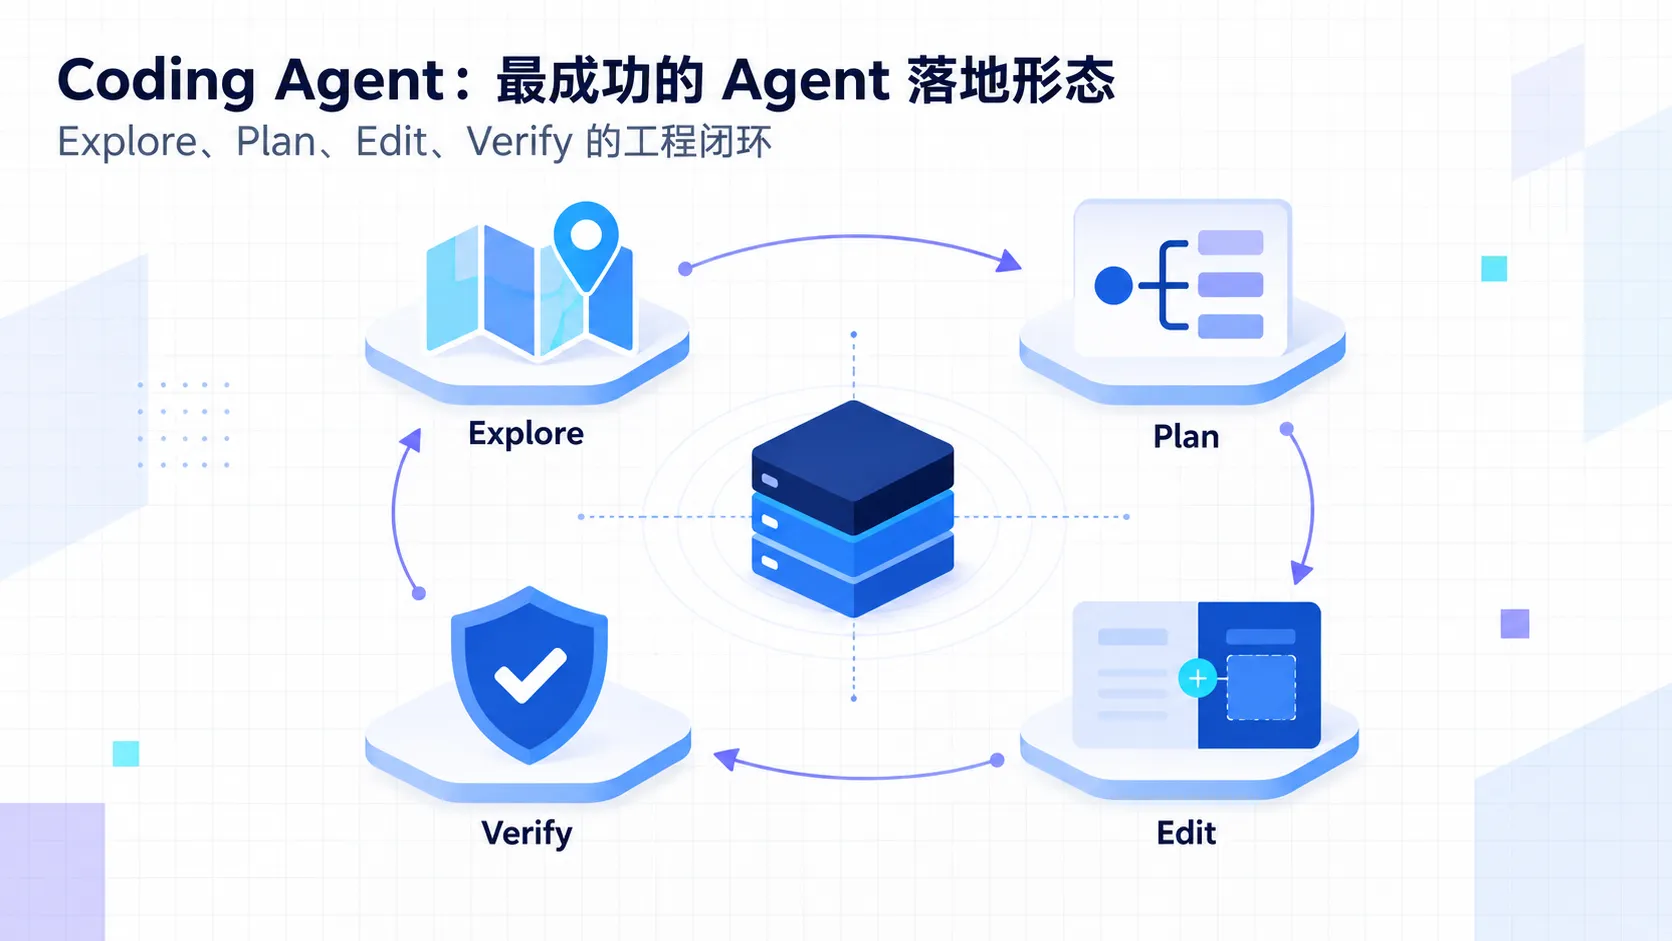
本文是「Agent 基础与工程」系列专栏的第 12 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在所有的智能体落地场景中,Coding Agent(代码智能体,如 Claude Code、Cursor、Windsurf 等)是商业化渗透最快、任务闭环最为稳固的形态。
这并不是偶然 ...
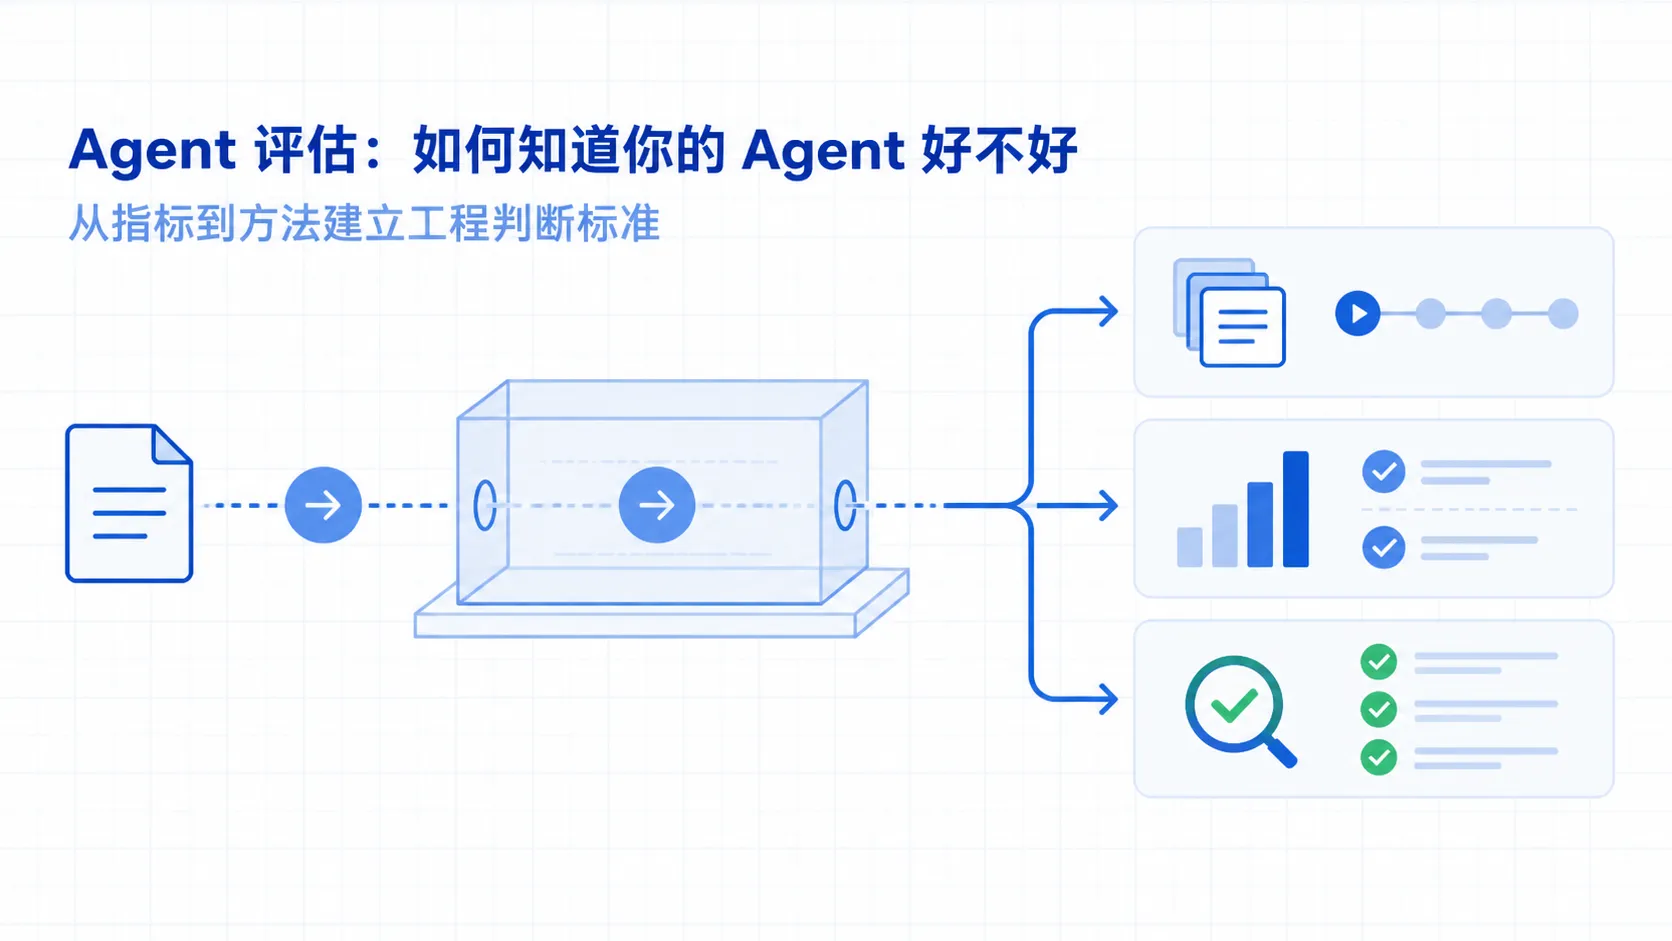
本文是「Agent 基础与工程」系列专栏的第 11 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在 Agent 原型验证阶段,开发团队常依赖“挑几个用例手工提问,看着回答像那么回事”来评估系统。然而,一旦进入团队协同或上线迭代,这种凭感觉测试的方式会立即失效:
微调了 Syst ...
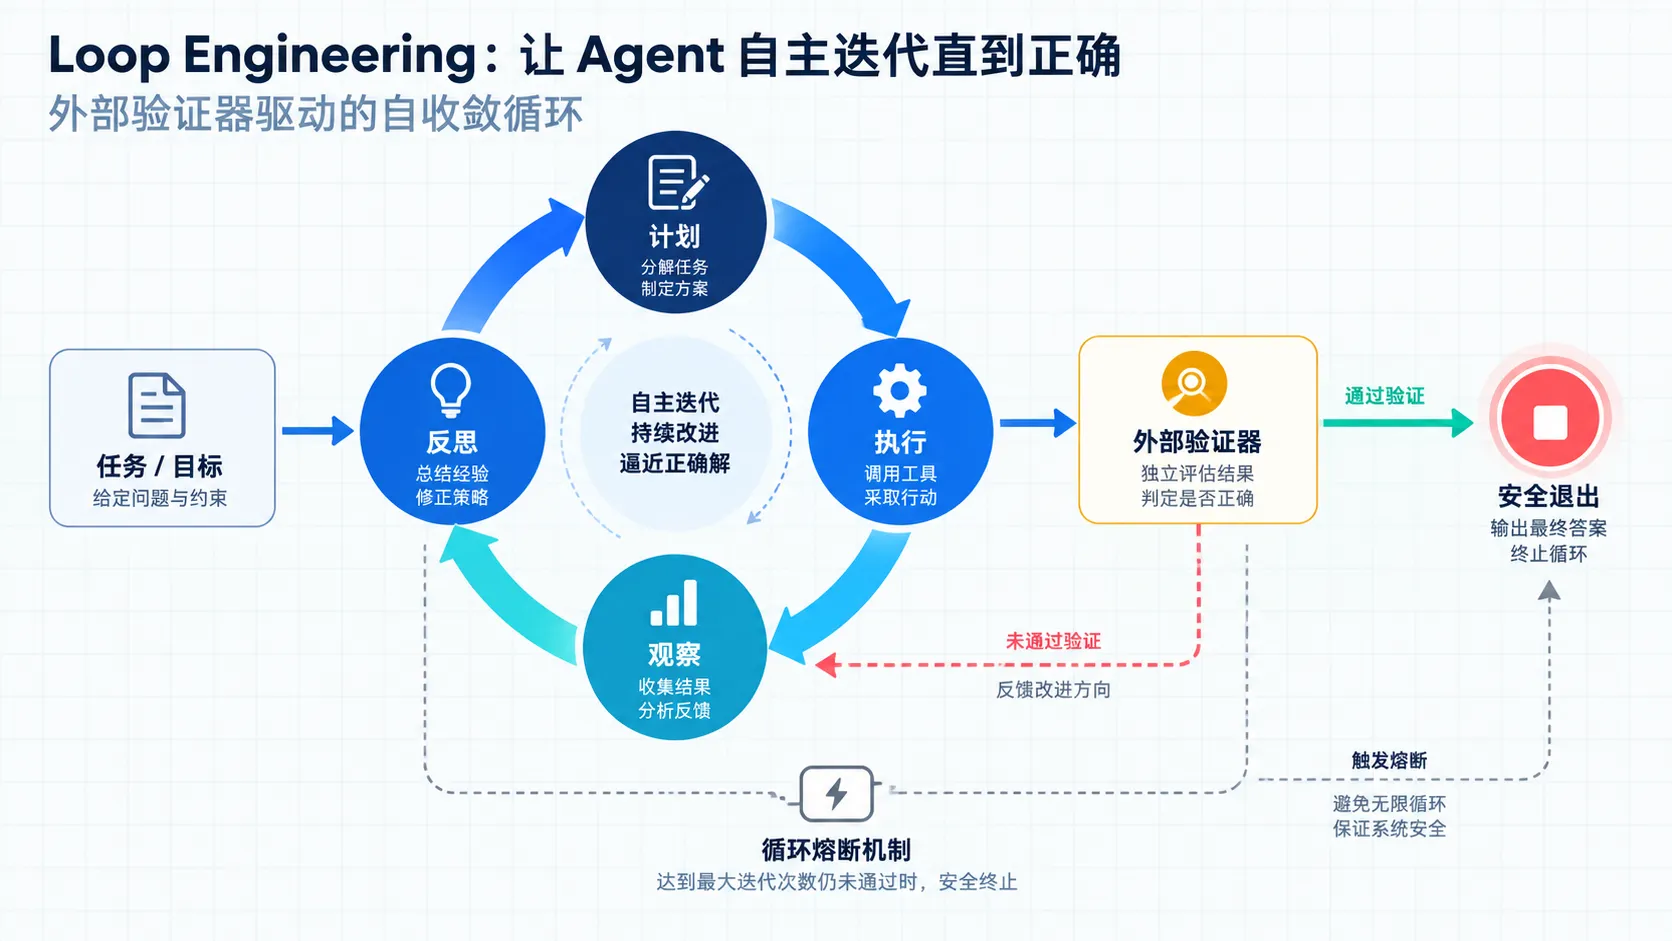
本文是「Agent 基础与工程」系列专栏的第 10 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在单次调用场景中,开发者往往将精力放在 Prompt 的遣词造句与工具参数的 Schema 定义上。但在长程多步 Agent 系统中,绝大多数严重的线上故障并不源于单次模型调用的语法错 ...
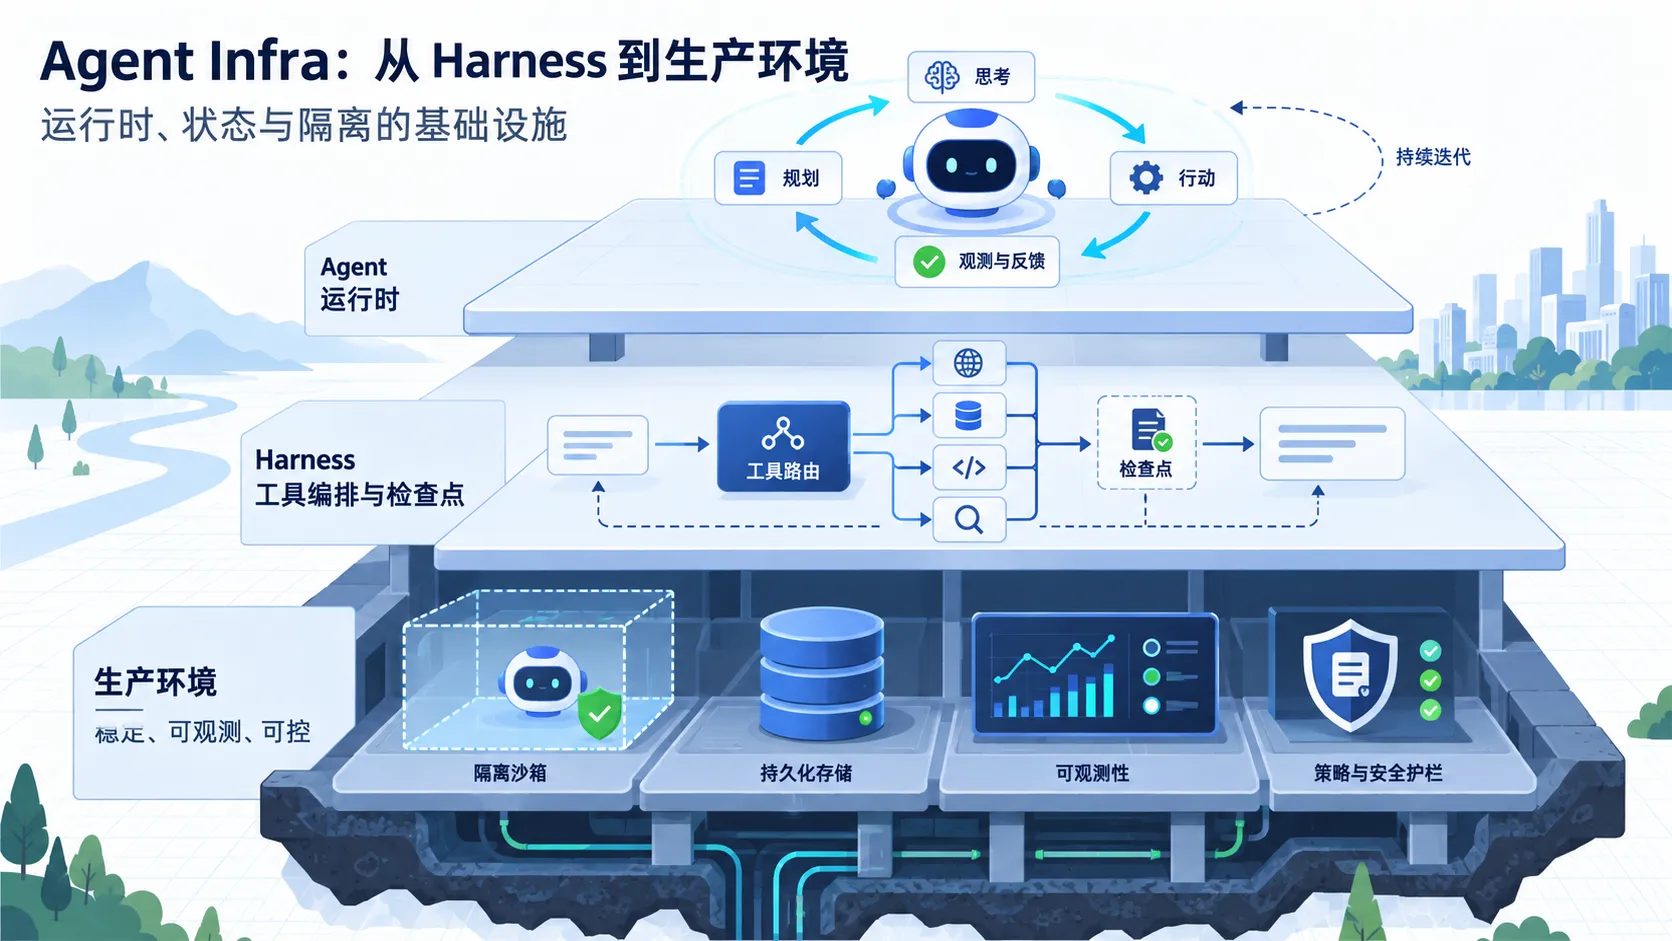
本文是「Agent 基础与工程」系列专栏的第 9 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在本地编写一个 while True 的 Agent 循环通常只需要几十行代码:组装提示词、发起模型调用、解析工具、执行并打印输出。然而,当把这一套逻辑部署至企业生产环境时,系统会直接暴 ...
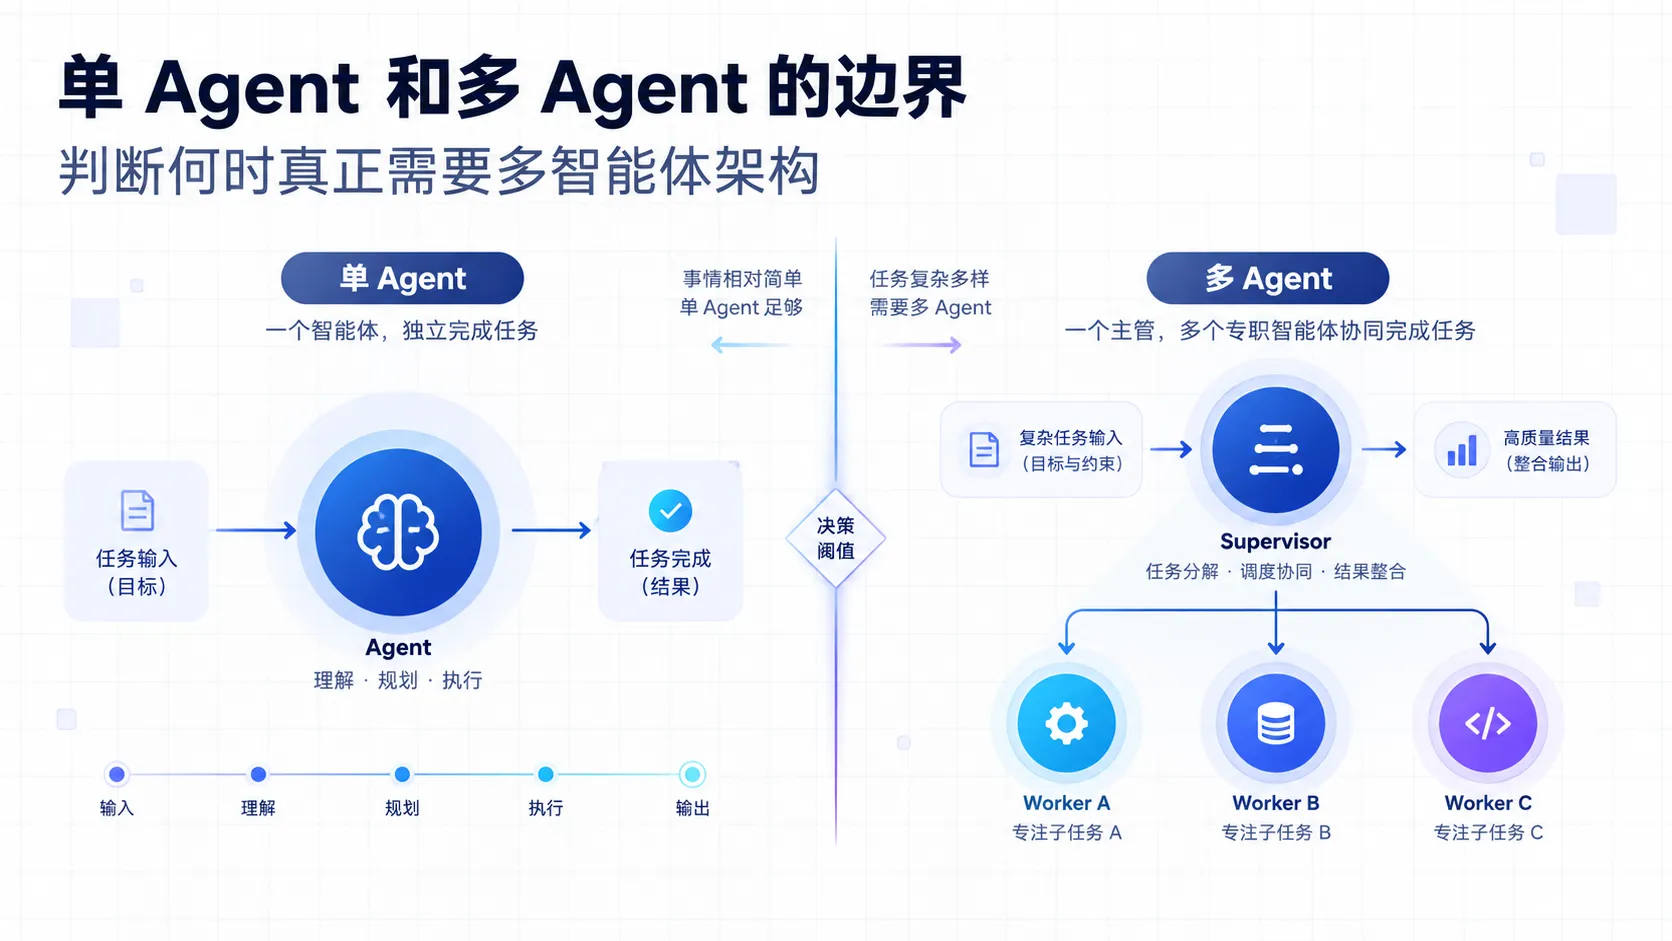
本文是「Agent 基础与工程」系列专栏的第 8 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在智能体开发领域,多智能体(Multi-Agent System)常被设计成充满戏剧色彩的“虚拟公司”:Prompt 赋予不同模型“产品经理”、“架构师”、“程序员”、“测试工程师”等拟 ...
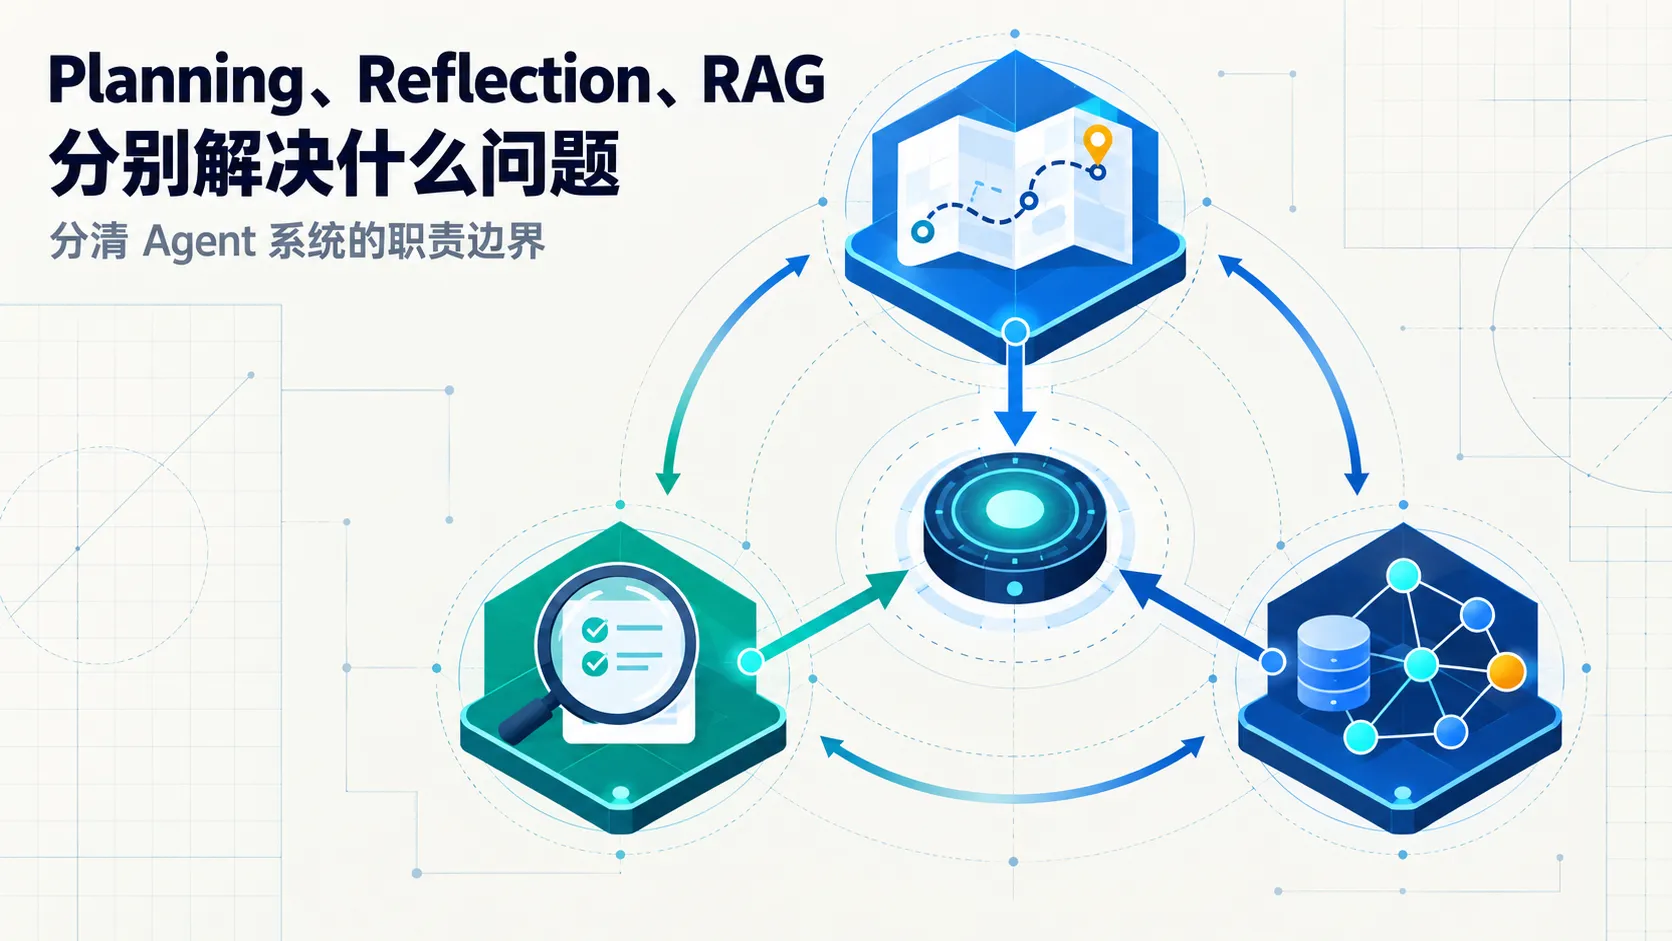
本文是「Agent 基础与工程」系列专栏的第 7 篇。专栏总览参见:《Agent 基础认知与工程架构全景》。
在构建较复杂的 Agent 系统时,Planning(任务规划)、Reflection(自省反思)与 RAG(检索增强生成)常被打包作为“高级智能体”的标准配置。然而,如果在系统设计初期 ...

