DeepSeek Harness 04:LLM 接缝——把模型差异关在适配器里
DeepSeek Harness 04:LLM 接缝——把模型差异关在适配器里
Asaakii在构建 Agent 系统时,不同大语言模型厂商的 API 接口存在显著差异:
- OpenAI 采用专有的
tool_callsJSON 数组与特定流式增量; - Anthropic Claude 采用块结构(Content Blocks)与输入增量协议;
- DeepSeek 拥有原生思维链(Reasoning / Thinking Content)与独特的用量标记。
如果让核心控制循环(Agent Loop)直接感知这些特定厂商的字段,只要引入一个新模型或者某家厂商升级协议,整个控制核心就必须做一次重构手术。
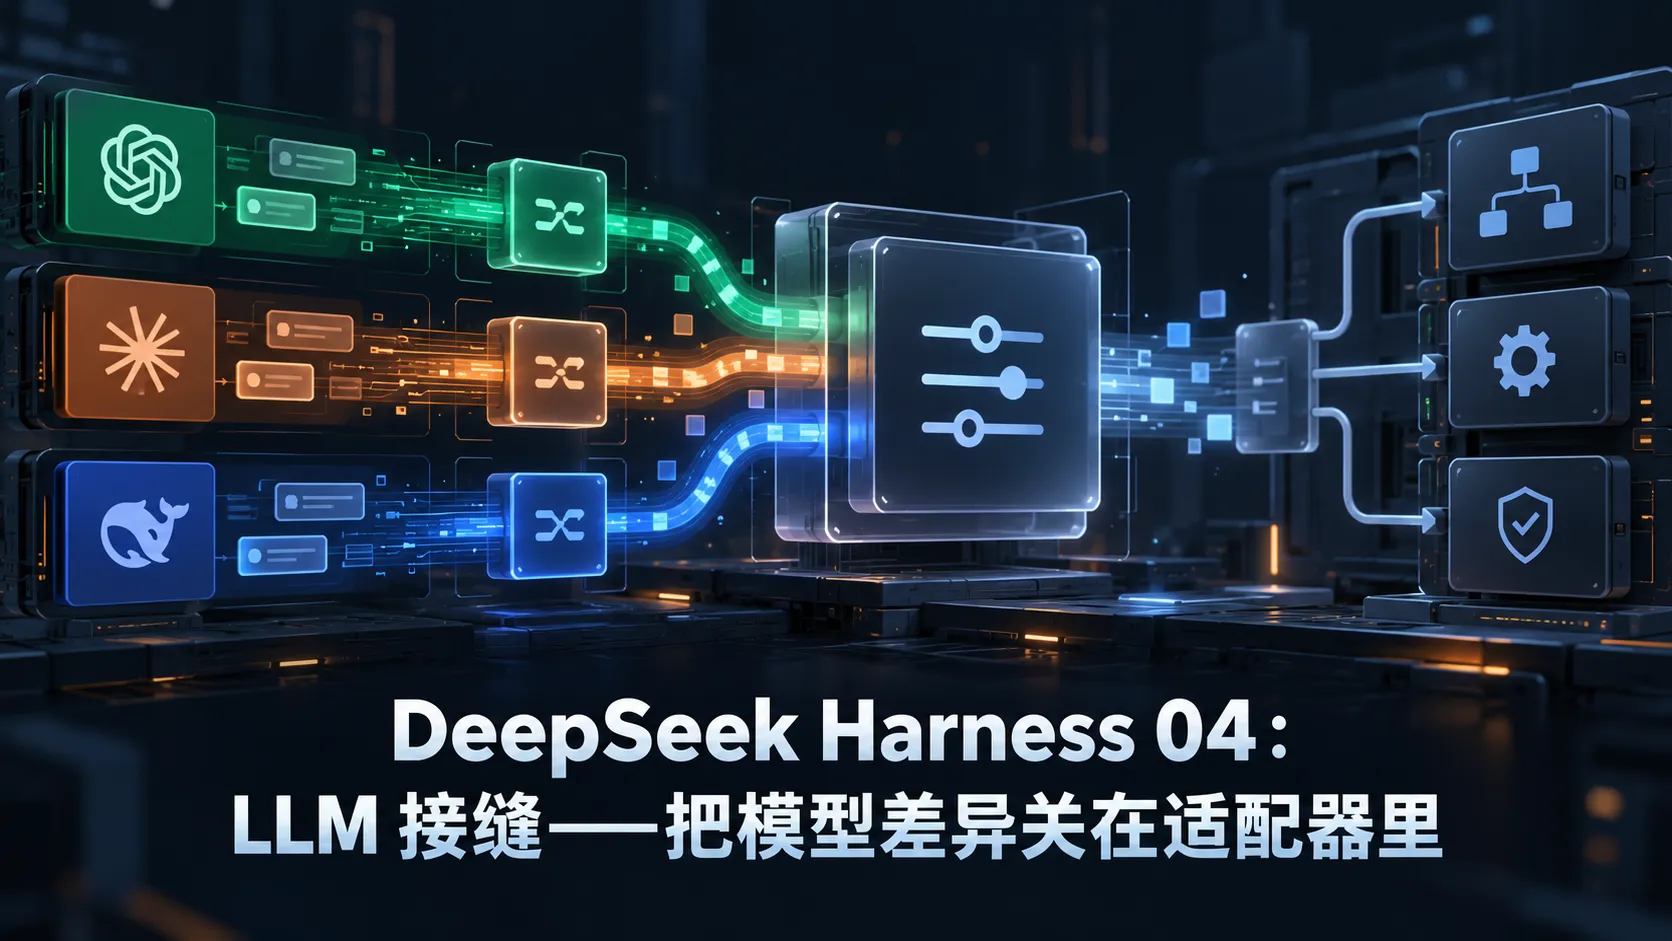
DeepSeek Harness 的设计决策非常坚决:建立一条严格的中立接缝(LLM Seam),主循环只使用 Harness 内部统一词汇表,所有的供应商差异被死死锁在适配器内部。
一、统一词汇表:消息抽象架构
LLM 接缝绝不是简单给 HTTP 请求包一层 SDK,而是定义了 DSH 内部描述一次模型交互的通用标准:
  flowchart LR
  Loop["Agent Loop<br/>(调度核心)"] -->|厂商无关 Message / ContentBlock| Seam["LLM Seam / Registry<br/>(按规则选择适配器)"]
  Seam -->|厂商专属网络协议| Provider["DeepSeek / Claude / OpenAI"]
  Provider -->|流式网络响应| Seam
  Seam -->|厂商无关 StreamChunk| Loop
在 DSH 的统一消息模型中,一条 Message 由若干强类型的 ContentBlock 组成:
text:普通的文本回复;thinking:模型的内生思考过程 / 推理内容;tool_call:结构化的工具调用请求(保留原始参数字符串与独立 ID);tool_result:工具执行完成后的标准结果反馈。
这种设计使得 Agent Loop 在组织上下文与调度决策时,完全不必出现 if (provider === 'openai') 或 if (isAnthropic) 这样令人窒息的胶水代码。
二、StreamChunk 流式协议与五大不变量
在追求低延迟的交互式场景中,模型输出是以流式数据包(Stream)实时推送的。DSH 拒绝使用松散的字符串拼接,而是将流式响应确立为一套包含严格状态机不变量的流式协议(StreamChunk Protocol):
| 事件类型 | 触发时机 | 携带载荷与约束 |
|---|---|---|
block_start |
某个新内容块出现(如文本开始、工具调用开始) | 包含当前块在整条消息中的稳定索引 index 及类型 |
block_delta |
当前块的内容增量到达 | 针对指定 index 的增量数据片段(文本切片或 JSON 字符串切片) |
block_end |
当前块完整输出结束 | 必须携带当前块的完整聚合结果,消费方无需自行拼装 |
usage |
Token 消耗统计数据到达 | 输入 Token、补全 Token 及缓存命中统计(必须早于结束事件) |
finish |
整个流式调用终结 | 包含模型终结原因(stop、tool_calls、length 等)与回放状态 |
为了防止由于网络中断或异常导致的脏状态,DSH 适配器必须保证以下五大运行时不变量:
- 多块交织时的索引归位:不同的内容块(例如模型一边输出文字解释,一边发起工具调用)必须通过全局唯一的
index定位,绝不允许乱序穿插。 - 块终态的自完备性:
block_end必须直接给出合并后的完整数据对象。如果网络在这个瞬间发生抖动,上层消费方不需要猜测前面收到了哪些 delta。 - 用量统计的时序保证:
usage事件必须在终结事件之前发布,一旦触发终结事件,严禁再产生任何新的数据包。 - 取消信号的双向穿透:当用户在界面按下打断按钮时,Harness 发出的
AbortSignal必须穿透适配器,并立即在底层强行终止底层 HTTP 流式网络连接,避免无谓的 Token 资费消耗。 - 参数解析的推迟原则:在适配器层,模型给出的工具调用参数一律保留为原始 JSON 字符串。参数反序列化与 Schema 校验被严格推迟至后续的 Tool Pipeline 阶段。
三、Replay State:如何实现跨轮次无损回放?
统一词汇表固然干净,但也带来一个隐蔽的工程挑战:某些模型供应商在发起多轮工具调用时,依赖特定的上下文元数据(例如服务端的 message_id、前序推理上下文句柄等)。如果我们的统一抽象强行抹掉这些字段,在多轮调用时就可能导致模型续接失败。
DSH 巧妙地通过 finish.replayState 解决了这个两难困境:
1 | export interface FinishPayload { |
replayState 对 Harness 控制核心而言是一个完全黑盒的透传对象。Harness 负责将其原样持久化到会话日志中;当下一次向同一个模型发起会话续接时,适配器重新读取该字段,完成高保真的上下文重建。这既保留了核心架构的纯粹性,又兼顾了特定模型的私有特性。
四、失败事实与恢复策略的物理分离
当调用大模型发生网络错误或服务异常时,很多初级框架的典型做法是在适配器代码里写死重试逻辑。但这往往会带来严重的二次伤害:
- 如果错误是因为账号欠费,盲目重试不仅徒劳,还会阻塞用户数分钟;
- 如果错误发生在模型发起了高危工具之后,胡乱重试可能导致重复执行副作用。
DSH 的设计原则是:适配器只负责报告结构化的“失败事实(Failure Facts)”,绝对不擅自决定“如何恢复(Recovery Strategy)”。
  flowchart TD
  RawErr["Provider 原始错误<br/>(HTTP 429 / 503 / 认证失效 / 超时)"] --> Adapter["LLM Adapter"]
  Adapter -->|归一化失败事实| Fact["Normalized Error<br/>(type: rate_limit, retryAfter: 2000ms)"]
  Fact --> Policy["上层 Agent 策略拦截器<br/>(agent/request-error)"]
  Policy -->|决策一| R1["退避等待后重试"]
  Policy -->|决策二| R2["切换到备用模型路由"]
  Policy -->|决策三| R3["直接终止当前 Turn 并通知用户"]
适配器将底层的 HTTP 错误、JSON 解析错误或供应商限流,归一化为标准的系统级枚举。而究竟是退避重试、切换备选模型降级,还是直接宣告任务失败,全部交由更上层的策略插件通过 agent/request-error 拦截链统筹决策。
五、llm/stream 拦截点:横切治理接缝
所有的模型调用最终都会汇聚在 llm/stream 这一 waterfall 拦截点上。这为工程治理提供了极大的便利:
- 实时流量审计与计费:在拦截器中统计输入与输出 Token,实时更新用户账户配额;
- 单元测试替身(Test Mocking):在自动化测试中,利用拦截器短路真实的 HTTP 请求,直接注入预设好的模拟
StreamChunk流; - 安全合规过滤:在模型返回敏感信息的第一时间掐断流式输出,阻断有害内容在客户端的渲染展示。
通过将模型差异隔绝在接缝之内,DSH 在底座层面具备了极高的模型演进弹性。下一篇我们将深入控制平面的核心——探究 Agent Loop 是如何依赖这条接缝推动整个任务前进的。