Pi Coding Agent 02:pi-ai 多 Provider 适配层——把模型差异隔离在边界外
Pi Coding Agent 02:pi-ai 多 Provider 适配层——把模型差异隔离在边界外
Asaakii在编写原型 Demo 时,直接使用某家原厂 SDK(例如调用 OpenAI 的 openai.chat.completions.create)写几行代码速度最快。
但在真实的工业级研发中,这种做法很快就会暴露出架构隐患:
- Anthropic Claude 采用块结构(Content Blocks)与输入增量协议;
- OpenAI 采用专有的
tool_callsJSON 数组与特定增量; - DeepSeek 拥有原生思维链(Reasoning / Thinking Content)与独特的用量标记。
如果将这些差异散落在系统的业务逻辑中,当你需要切换到性价比更高的模型、或者需要做 A/B 测试对比代码生成质量时,真正难以下手的往往不是那几个 HTTP 端点,而是已经深深渗透进 Agent Loop 核心循环的特定厂商数据结构。
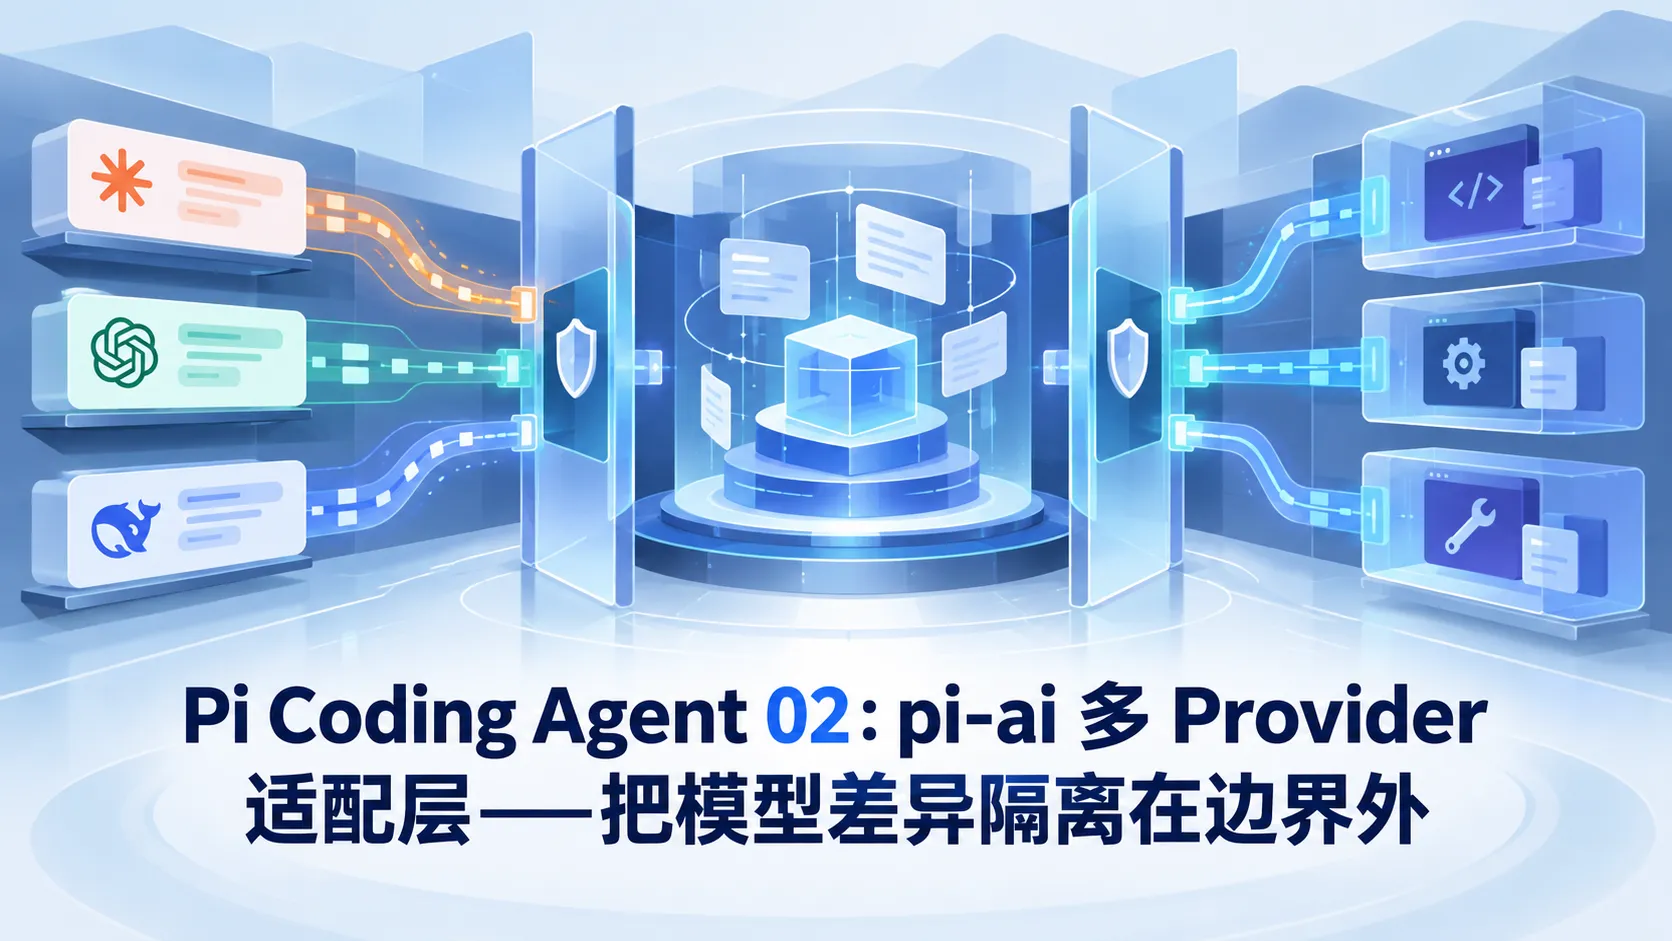
@earendil-works/pi-ai 的核心使命,正是构建一套稳定的内部中间表示(Message IR),把所有无法彻底消除的厂商协议差异,死死关在适配器边界之外。
一、清晰解耦:Provider、Model 与 API Implementation
在 pi-ai 的架构体系中,模型接入被拆分为三个正交维度:
  flowchart LR
  subgraph Providers ["Provider 实体 (厂商目录与认证)"]
    P1["Anthropic 官方"]
    P2["OpenAI 官方"]
    P3["OpenRouter 聚合平台"]
  end

  subgraph Models ["Model 实体 (规格与能力)"]
    M1["claude-3-5-sonnet<br/>(200k 窗口 / $3/$15)"]
    M2["gpt-4o<br/>(128k 窗口 / $2.5/$10)"]
    M3["deepseek-chat<br/>(64k 窗口 / 低资费)"]
  end

  subgraph APIs ["API Implementation (真实网络线协议)"]
    A1["anthropic-messages 适配器"]
    A2["openai-responses 适配器"]
  end

  P1 --> M1
  P2 --> M2
  P3 --> M3

  M1 --> A1
  M2 --> A2
  M3 --> A2
- Provider(供应商):负责管理模型发现目录、API Key 认证头注入与网络 Endpoint 路由;
- Model(具体模型规格):定义上下文窗口上限(Context Window)、输入输出单价、并发配额与工具调用支持能力;
- API Implementation(线协议实现):处理实际底层 HTTP / SSE 网络请求格式与流式 JSON 解析。
[!NOTE]
多厂商复用同一种线协议:这种三层拆分避免了将“厂商”、“模型”与“网络协议”绑死为一个单一体枚举。如果某个第三方服务(如 OpenRouter、Groq 或本地 vLLM)完全兼容 OpenAI 协议规范,适配层可以直接复用openai-responses转换器,而不需要重复编写任何底层的流式解析器。
二、统一 Message IR:Agent 的内部协议标准
在 pi-ai 内部,传递给模型的上下文 Context 是一个中立的强类型对象:
1 | import { Type, type Context, type Tool } from "@earendil-works/pi-ai"; |
消息列表绝不是简单的松散字符串拼接,而是由可判别的三种标准角色组成:
user:保存人类用户的真实输入,支持纯文本切片与二进制图片;assistant:完整承载模型产出的所有内容,包括文本(text)、思维链推理(thinking)、结构化工具调用(toolCall)、Token 消耗(usage)与结束原因(stopReason);toolResult:必须携带toolCallId、工具名称、规范化结果内容、错误布尔标记(isError)以及可选的调试上下文。
三、双向流式协议:同一个流服务“过程”与“终态”
在处理大语言模型的流式推送时,很多系统容易走向两个极端:
- 要么只返回一个松散的异步迭代器(
AsyncIterator),由各个消费方在业务代码里各显神通去拼接字符碎片; - 要么完全阻塞等待全部生成结束,丧失了在终端实时打字展示的能力。
pi-ai 提供了高度优雅的 AssistantMessageEventStream 结构。同一个流对象,同时满足了实时的“过程渲染”与确定性的“最终收束”:
1 | const stream = models.stream(model, context); |
为什么必须有 stream.result() 机制?
让流对象自身负责收束终态,能够将以下关键的**运行时不变量(Invariants)**收归适配层内部集中保障:
- 工具参数碎片合并:模型可能分 10 个数据包吐出一段完整的 JSON 字符串参数,适配器在流结束时负责无损拼合并校验合法性;
- 思维链完整保留:在流式输出中穿插的
thinking过程不会在收束时丢失; - 用量精准结算:各厂商在流末尾吐出的输入/输出 Token 统计被正确归位;
- 异常情况安全兜底:即使底层网络遭遇 HTTP 超时或用户中途按下 Ctrl+C 打断,
stream.result()依然会返回一个合法的结构化AssistantMessage(带有stopReason: "aborted"或"error"),绝不会让整个进程因未捕获异常而崩溃。
四、Stop Reason:状态机的控制流信号
在 pi-ai 的统一抽象中,stopReason 是指导控制循环(Agent Loop)下一步该去哪里的核心状态机枚举,绝不能降级为展示文字:
| 终止原因枚举 | 内部核心语义 | Agent Loop 的确切动作 |
|---|---|---|
stop |
正常结束 | 模型没有发起任何工具调用,当前任务轮次(Turn)平稳收束 |
toolUse |
请求工具 | 模型发起了若干 toolCall,调度引擎暂停文本输出,派发执行平面 |
length |
上下文超限截断 | 模型的输出触达了最大 Token 上限,控制流必须记录未完成状态,禁止谎报成功 |
error |
供应商接口报错 | 保留结构化失败诊断,交由重试策略或降级路由接管 |
aborted |
外部主动取消 | 用户按下打断或超时熔断,彻底阻断后续工具调度 |
deferred |
延后句柄返回 | 针对长程异步任务返回的占位句柄,需由外部宿主管理状态生命周期 |
五、实战检验:双模型对照实验
当你需要在生产环境中将默认模型从供应商 A 迁移到供应商 B 时,切记:TypeScript 编译通过,仅仅说明数据类型形状匹配,绝不代表任务成功率、推理质量和资费成本是等价的!
建议设计一套标准的基准测试用例:
1 | 固定任务:读取 package.json,验证 scripts 字段中是否存在 "test",并引用原始字段行号。 |
记录两组真实客观的评测证据:
| 评估维度 | 模型 A(如 Claude 3.5 Sonnet) | 模型 B(如 DeepSeek-V3) |
|---|---|---|
| 工具匹配准确率 | 是否能准确发起 read 工具并提供正确入参? |
是否能准确发起 read 工具并提供正确入参? |
| 异常恢复轮数 | 遭遇 File Not Found 后能否自我修正路径? |
遭遇 File Not Found 后能否自我修正路径? |
| 总交互轮数 | 完成任务所需的往返请求总次数 | 完成任务所需的往返请求总次数 |
| Token 开销明细 | 输入 Token / 输出 Token / Prompt Cache 命中率 | 输入 Token / 输出 Token / Prompt Cache 命中率 |
| 端到端耗时 | 从发起需求到输出最终回答的物理耗时(秒) | 从发起需求到输出最终回答的物理耗时(秒) |
通过 pi-ai 提供的统一适配层,所有的业务逻辑与测试脚手架无需做任何修改,即可平滑完成不同模型在真实工程任务下的全面对账。