OpenClaw 05:ContextEngine 记忆架构、Compaction 与 Dreaming 系统
OpenClaw 05:ContextEngine 记忆架构、Compaction 与 Dreaming 系统
Asaakii在构建长周期运行的 Agent 时,上下文窗口(Context Window)始终是昂贵且有限的物理边界。一个未经设计的 Agent 在经历十几轮多文件交互后,就会迅速因为上下文溢出而崩溃,或者把最初的用户约束和架构规范遗忘殆尽。
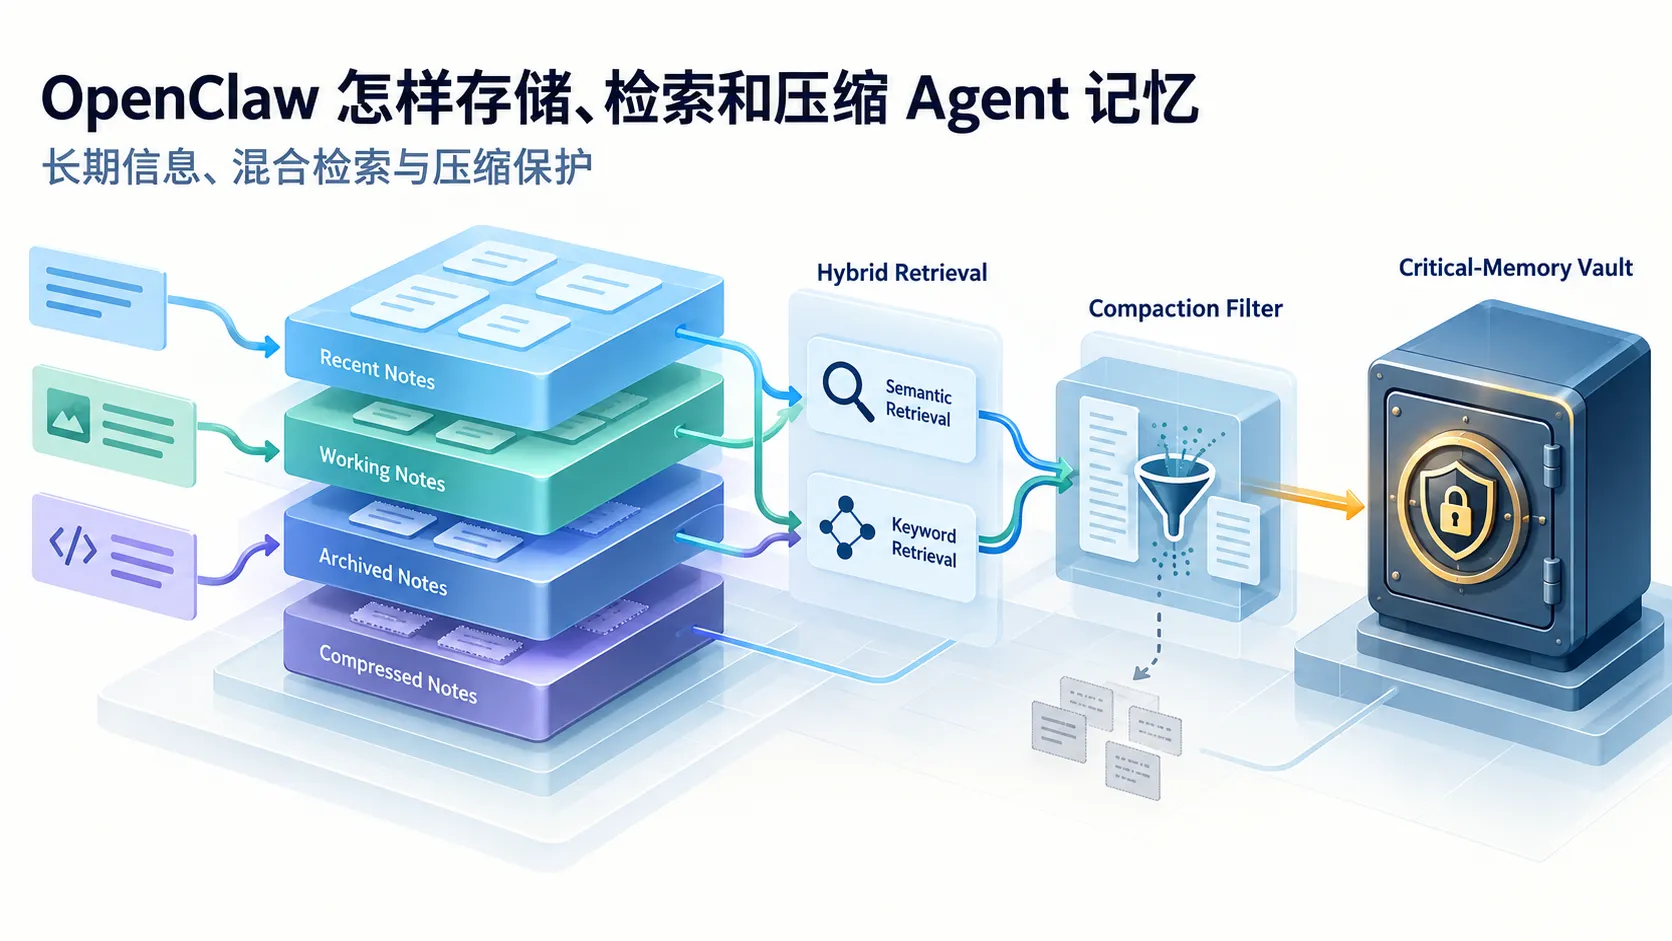
Agent 的“记忆”绝对不是数据库里无节制追加的消息列表。OpenClaw 将记忆抽象为由下至上的三层结构:
- 第一层:持久化记忆(
MEMORY.md) —— 跨会话存活、人类可读、Git 版本控制; - 第二层:ContextEngine —— 每轮调用前在 Token 预算内动态组装最优上下文并执行压缩;
- 第三层:Session 管理 —— 会话生命周期状态机与断点恢复。
本文系统剖析这一架构的具体实现与进阶的 Dreaming(睡眠巩固)机制。
记忆分层全景
  flowchart TD
    subgraph 存储与持久化
        M1["MEMORY.md 索引文件<br>(人类可编辑 / Git 跟踪)"]
        M2["外部宿主: GBrain<br>(Postgres + pgvector)"]
    end

    subgraph 动态上下文引擎 ContextEngine
        A["assemble(budget)<br>Token 预算优先级分配"]
        C["compact()<br>带标识符保留的 LLM 压缩"]
        D["Dreaming 系统<br>(三阶段夜间巩固整理)"]
    end

    subgraph 会话运行时
        S["Session Transcript<br>(追加式事件流)"]
        L["LLM API 调用上下文"]
    end

    M1 --> A
    M2 --> A
    S --> A
    A --> L
    S -->|超限| C
    C --> S
    S -->|夜间 cron| D
    D --> M1
    D --> M2
第一层:MEMORY.md 文件级持久化
很多系统倾向于在启动时连接 Redis 或向量数据库,而 OpenClaw 优先选用 Markdown 文件存储核心长期记忆。
为什么选择 Markdown 文件?
- 透明与可控:开发者可以直接用编辑器打开查看,发现 Agent 记错了直接修改或删除;
- Git 友好:伴随工程仓库一同提交,支持
git diff、版本追溯与分支回滚; - 零外部依赖:不依赖任何独立运行的数据库容器,开箱即用;
- LLM 天然原生:LLM 对 Markdown 的层级结构和引用链接解析效果最好。
索引文件结构模式
1 | .myclaw/memory/ |
MEMORY.md 作为轻量目录:
1 | # Agent Long-Term Memory Index |
写入时机界定:
记忆系统只写入跨会话的长期事实(用户显式纠错、项目非显而易见的约定、用户偏好);绝对不存储源码内容(用 Read 获取)、Git 历史(用git log获取)或当前任务状态(用 Task List 跟踪)。
第二层:ContextEngine 核心接口与 Token 预算
ContextEngine 负责在每一次 LLM 请求前,按照 Token 预算裁剪与拼装出最精炼的上下文:
1 | export interface TokenBudget { |
assemble() 的优先级分配策略
面对严格的 Token 预算(例如限制单次输入最多 32,000 tokens),不能简单将历史记录从前往后全量拼接,必须遵循严格的优先级梯队:
1 | export class DefaultContextEngine implements ContextEngine { |
优先级规则:系统指令 > MEMORY.md 长期记忆 > 早期压缩摘要 > 最新对话轮次。低优先级且未被摘要的历史消息在预算超载时优先被剥离。
上下文压缩(Compaction):标识符保留机制
当活跃消息的 Token 总量触碰警戒线时(如达到窗口上限的 80%),系统触发 compact()。
简单的 LLM 摘要往往会把工程细节模糊化为泛泛之谈(如:“此前分析了鉴权模块并修复了一些问题”)。一旦变成这样,Agent 就彻底丧失了后续代码编辑的能力。
OpenClaw 提出了严格的标识符保留规则(Identifier Preservation):
1 | compaction: |
提示词约束规范
在向模型请求压缩时,强制要求保留代码级物理锚点:
1 | const COMPACTION_PROMPT = ` |
压缩完成后,前序原始消息被安全归档,上下文由该结构化摘要接管,同时在压缩前自动执行一次 auto-flush,将长期结论刷入 MEMORY.md。
Dreaming 系统:记忆的夜间巩固整理
人类大脑在睡眠阶段通过海马体与大脑皮层的协同完成记忆巩固与冗余剪枝。OpenClaw 的 Dreaming 机制通过定时任务实现自主长期记忆维护:
  flowchart LR
    A["Light Sleep<br>(浅睡眠: 扫描当日事件,提取候选片段)"] --> B["Deep Sleep<br>(深睡眠: 概念合并、冲突消解、废弃过期信息)"]
    B --> C["REM 阶段<br>(快速眼动: 跨主题建立关联图谱,提炼 Compiled Truth)"]
    C --> D["产物: DREAMS.md 日志<br>& 更新 MEMORY.md"]
记忆评分公式
候选记忆片段通过以下加权评分公式决定是否被提升为跨项目永久记忆:
$$\text{Score} = 0.30 \cdot R + 0.24 \cdot F + 0.15 \cdot QD + 0.15 \cdot Rec + 0.10 \cdot C + 0.06 \cdot CR$$
- $R$ (Relevance):与工程核心架构的相关度;
- $F$ (Frequency):跨轮次被提及或使用的频次;
- $QD$ (Query Diversity):在不同类型任务提问中的普适度;
- $Rec$ (Recency):近期新事实的衰减得分;
- $C$ (Consolidation):已被其他规则引用的收敛度;
- $CR$ (Conceptual Richness):包含的概念信息浓度。
只有经过验证且有据可查(Grounded)的高分片段才会被正式提升,低分片段与已被解决的调试临时日志在深睡眠阶段自动退休(Retired)。
生产级记忆宿主:GBrain 的架构实践
当团队面对超大规模知识库(例如超过 15,000 个知识页、4,000+ 实体)时,单一的 MEMORY.md 文件会出现检索瓶颈。OpenClaw 的扩展后端 GBrain 采用了 PostgreSQL + pgvector 方案:
Compiled Truth + Timeline 架构
传统向量记忆直接追加导致前后事实冲突,GBrain 区分了当前认知与历史事实链条:
1 | Page: "用户数据库选型偏好" |
Agent 在日常推理中直接读取精炼的 Compiled Truth;当遇到争议或需要回溯决策原因时,按需穿透查看 Timeline 证据链。
Minions 任务队列:确定性优先于 LLM 推理
为了保障高可用,GBrain 放弃了不稳定、易崩溃的异步 sub-agent 临时进程,采用基于 Postgres 的确定性 Minions 任务队列 处理夜间记忆整理,且遵循一条核心原则:
能在确定性逻辑中解决的(正则提取实体、模式匹配关系、语法结构链接),绝不用 LLM 进行猜测。 只有在发生深层次冲突消解与语义合并时才调用模型,兼顾可靠性与执行成本。
总结
OpenClaw 的记忆架构给出了明确的工程范式:
- 区分上下文与记忆:上下文是临时有限的推理空间,记忆是跨生命周期的持久知识;
- 文本优先于黑盒:用 Markdown 索引作为长期记忆底座,透明、可编辑且零依赖;
- 带保真度的压缩:Compaction 严格保护文件路径与符号,避免压缩导致上下文瘫痪;
- 自主维护机制:引入 Dreaming 睡眠巩固,解决记忆单向膨胀与退化问题。
下一篇我们将探讨复杂任务拆解的核心:Multi-Agent 子进程隔离与多渠道路由。