OpenClaw 03:RAG 检索增强工程实现与混合检索
OpenClaw 03:RAG 检索增强工程实现与混合检索
Asaakii在构建自主 Coding Agent 时,很多开发者第一反应是把整个代码库切块塞进向量数据库,每轮循环都做一次强制检索。然而在实际工程中,这种“强行 RAG”往往会适得其反:向量相似度算出的相关代码片段支离破碎,不仅冲淡了上下文预算,还极易丢失代码行号与符号依赖。
在 Pi 与 OpenClaw 的设计中,RAG 绝不是核心循环的主干链路,而是一个按需挂载的工具。绝大多数代码阅读和编辑依靠精确路径、offset/limit 行切片和 grep 就能高效完成;只有面对未知宏观结构、企业文档或海量历史工单时,检索增强才发挥真正威力。
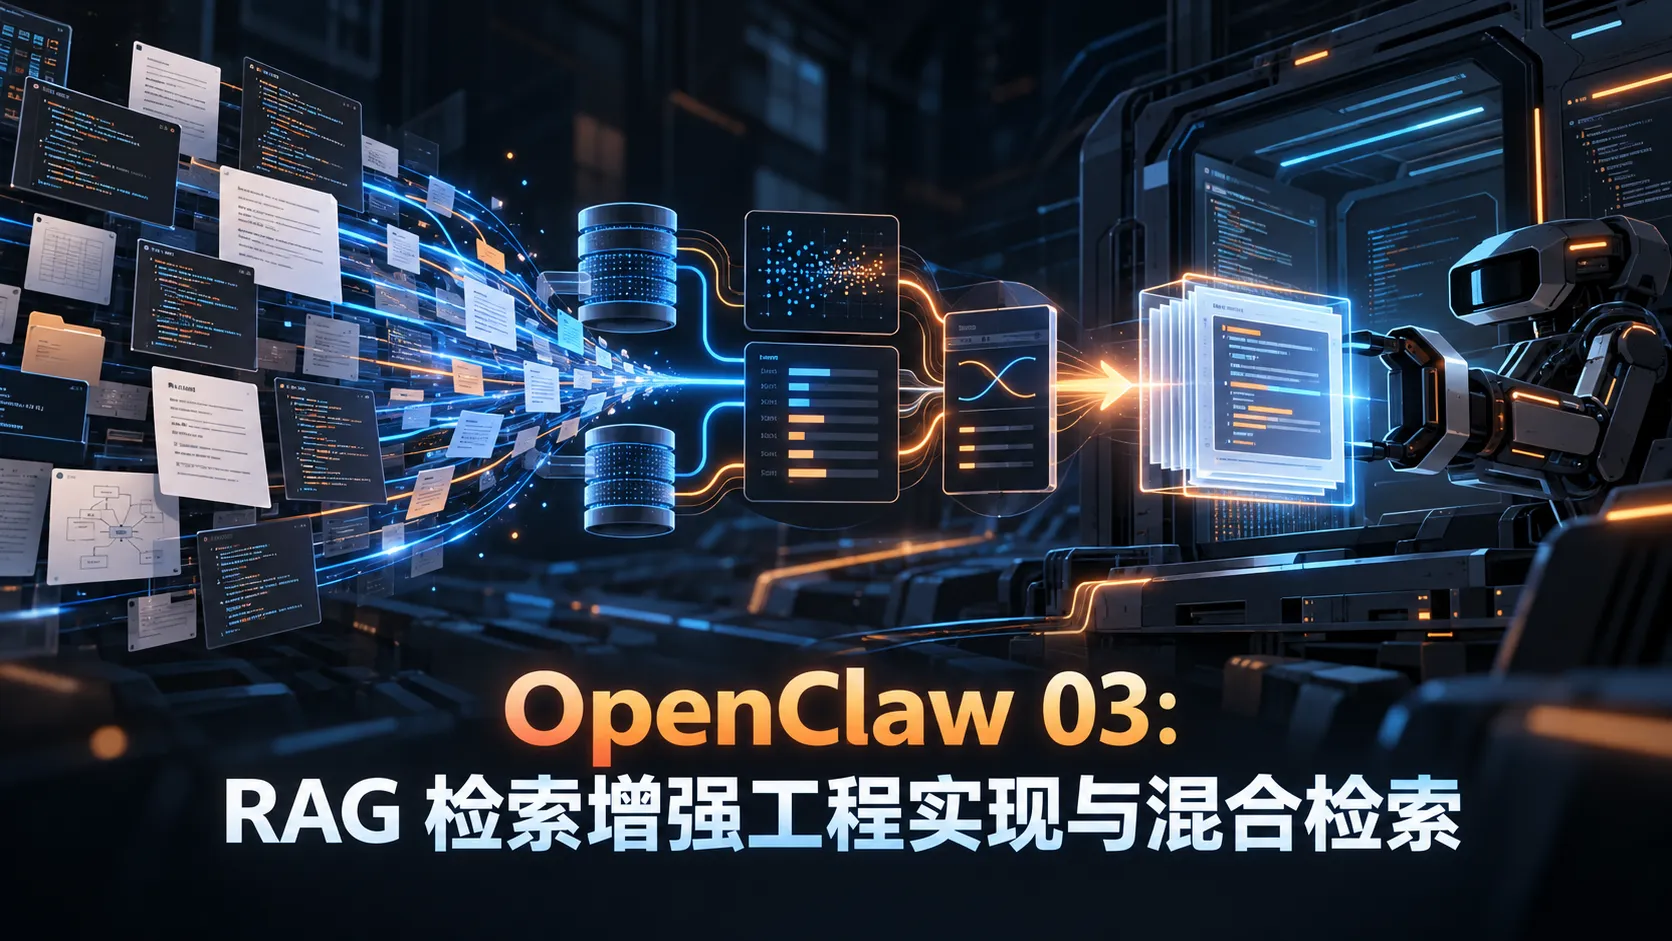
本文梳理从基础文本分块到生产级混合检索(Hybrid Search + RRF + Rerank)的完整实现路径,并剖析 OpenClaw 外部记忆系统 GBrain 的工程选型。
检索增强的核心管线
完整的 RAG 管线分为离线索引构建与在线检索注入两个阶段:
  flowchart TD
    subgraph 离线索引阶段
        D[源码或文档] --> CK[AST / 语义切块]
        CK --> EMB[向量化 Embedding]
        EMB --> VDB[(向量数据库 / pgvector)]
        CK --> BM[(倒排索引 / BM25)]
    end

    subgraph 在线检索阶段
        Q[Agent 搜索查询] --> Q_D[稠密检索 Top-20]
        Q --> Q_S[稀疏关键词检索 Top-20]
        VDB -.-> Q_D
        BM -.-> Q_S
        Q_D --> RRF[RRF 倒数排名融合]
        Q_S --> RRF
        RRF --> RRK[Cross-Encoder 重排序]
        RRK --> CTX[注入 Prompt Top-5]
        CTX --> LLM[LLM 生成结构化分析]
    end
每个环节的设计选择直接决定召回率与首 token 延迟。
代码切块策略:AST 语义边界 vs 滑动窗口
1. 基于 AST 的语义切块(推荐)
对代码文件按固定字符长度硬切,极易把一个类或函数截断成两截,导致模型推理时上下文断裂。更稳妥的做法是借助 Tree-sitter 等解析器,按语言语法树的函数、类、结构体边界切分:
1 | import Parser from 'tree-sitter' |
2. 滑动窗口切块(文本与通用文档)
对于 Markdown 文档、日志或无法直接解析语法的配置文件,退回到带重叠区(Overlap)的固定窗口分块:
1 | export function chunkByWindow(text: string, size = 512, overlap = 64): string[] { |
为什么必须保留 Overlap?
语义并不是离散分布在每个固定字符位置的。若恰好在关键判断条件或名词短语正中间切开,前后两个切块的语义都会残缺。重叠区能保证跨边界信息至少在一个切块内是连贯的。
Embedding 模型选型对比
代码检索与日常自然语言检索不同,它高度依赖精确符号、驼峰命名和长距离语法结构。
| 模型 | 输出维度 | 运行环境 | 特点与适用场景 |
|---|---|---|---|
| GTE-Qwen2 | 768 / 1536 | 本地部署 / API | 阿里开源,代码理解能力强,多语言覆盖好 |
| BGE-M3 | 1024 | 本地部署 / API | BAAI 开源,原生支持稠密检索、稀疏检索与多语言多粒度匹配 |
| text-embedding-3-small | 1536 | OpenAI 云端 API | 通用语义泛化强,成本低,但国内调用需代理且有合规顾虑 |
| Cohere embed-v3 | 1024 | Cohere 云端 API | 支持针对检索、分类任务独立调参,英文企业文档效果好 |
对于私有化 Coding Agent,推荐优先选用 GTE-Qwen2 或 BGE-M3:支持本地 GPU/CPU 推理,避免将核心源码发送至第三方接口,且代码检索精准度经生产验证表现优异。
混合检索:稠密向量 + BM25 稀疏检索 + RRF
纯向量检索存在明显的“语义发散”盲区:当你搜索精确变量名 clientContextId 或接口状态码 ERR_SESSION_TIMEOUT 时,向量余弦相似度可能会返回大量看似相关但字面完全不匹配的通用段落。
生产级方案必然采用混合检索:
- 稠密检索(Dense):基于向量相似度,捕捉宏观语义和同义表述。
- 稀疏检索(Sparse / BM25):基于关键词词频与逆文档频率,精准锁定符号名、类名、错误码。
- RRF(Reciprocal Rank Fusion):倒数排名融合算法,无需将两种完全不同量纲的分数归一化,只根据两者排名的倒数进行加权累加。
1 | interface SearchResult { |
OpenClaw 的持久化记忆层 GBrain 就是采用 PostgreSQL + pgvector + BM25 + RRF 的混合检索实现,在长周期生产记忆库中实现了 P@5(前 5 条命中率)49.1%、R@5(前 5 条召回率)97.9% 的基准表现。
Reranker 重排序:提升精准度
粗召回阶段通常取 Top-20 或 Top-30;直接注入 Prompt 会浪费上下文且引入干扰。在进入 LLM 之前,使用 Cross-Encoder 模型做一次打分精排:
1 | import { pipeline } from '@xenova/transformers' |
- 代价:增加约 150ms ~ 250ms 的推理开销。
- 收益:将 Top-5 的有效信息浓度提升 15% 以上,显著减少 LLM“答非所问”的现象。
在 Agent 中的集成方式:按需工具调用
Coding Agent 不应把 RAG 做成每轮对话的前置中间件,而应封装成模型可选的工具(Tool):
1 | import { ToolDefinition } from './types' |
这种机制让 LLM 自己判断何时需要全库探索。对于明确指明文件的指令(如“请阅读 src/auth.ts”),模型会直接调用轻量的 Read 工具,规避无意义的向量搜索。
核心设计权衡:RAG vs Fine-tuning
在面试或架构评审中,经常需要阐明何时选用 RAG、何时选用微调(Fine-tuning):
| 评估维度 | RAG(检索增强) | Fine-tuning(监督微调) |
|---|---|---|
| 知识时效性 | 实时更新,修改文档或重建索引秒级生效 | 需重新整理数据集并训练,周期长成本高 |
| 事实真实性 | 附带明确来源(引用文件与行号),可溯源 | 权重黑盒,无法从根源杜绝幻觉 |
| 上下文消耗 | 需将切块拼入 Prompt,消耗输入 Token | 不额外占用输入 Token |
| 核心适用场景 | 动态业务知识库、私有代码库、实时工单 | 固化输出格式、注入特定推理逻辑、对齐编码风格 |
总结
OpenClaw 与 Pi 的工程实践表明:最优秀的 RAG 是克制的 RAG。代码工程系统无需在每轮交互中盲目做向量匹配,而是构建“AST 语义切块 + 稠密稀疏混合检索 + RRF 融合 + Cross-Encoder 精排”的高质量工具,在模型需要时提供精准支撑。
下一篇我们将深入探究 Agent 的手脚:MCP 协议与工具并行执行系统。