DeepSeek Harness 11:安全边界——把信任放到模型之外
DeepSeek Harness 11:安全边界——把信任放到模型之外
Asaakii在 AI 领域,很多初学者容易患上一种“模型信任天真症”:试图通过在 System Prompt 里反反复复写上一万遍“你是一个安全守规矩的 AI,严禁执行破坏性系统命令”,来作为整个系统的安全防线。
在真实的生产与对抗环境下,这种防御犹如马奇诺防线般脆弱:
- 大模型是一个概率生成系统,Prompt 随时可能发生语义漂移;
- 用户读取的外部开源代码或网页内容中,可能暗藏精心构造的间接提示词注入(Indirect Prompt Injection);
- 插件自身的参数校验可能存在漏洞。
DeepSeek Harness 的安全架构奠定在一条残酷却清醒的公理之上:绝不信任模型的道德自律,把真正的安全控制权从模型中剥离,交由确定性的外部运行时强制执行。
一、策略平面与决策平面的物理隔离
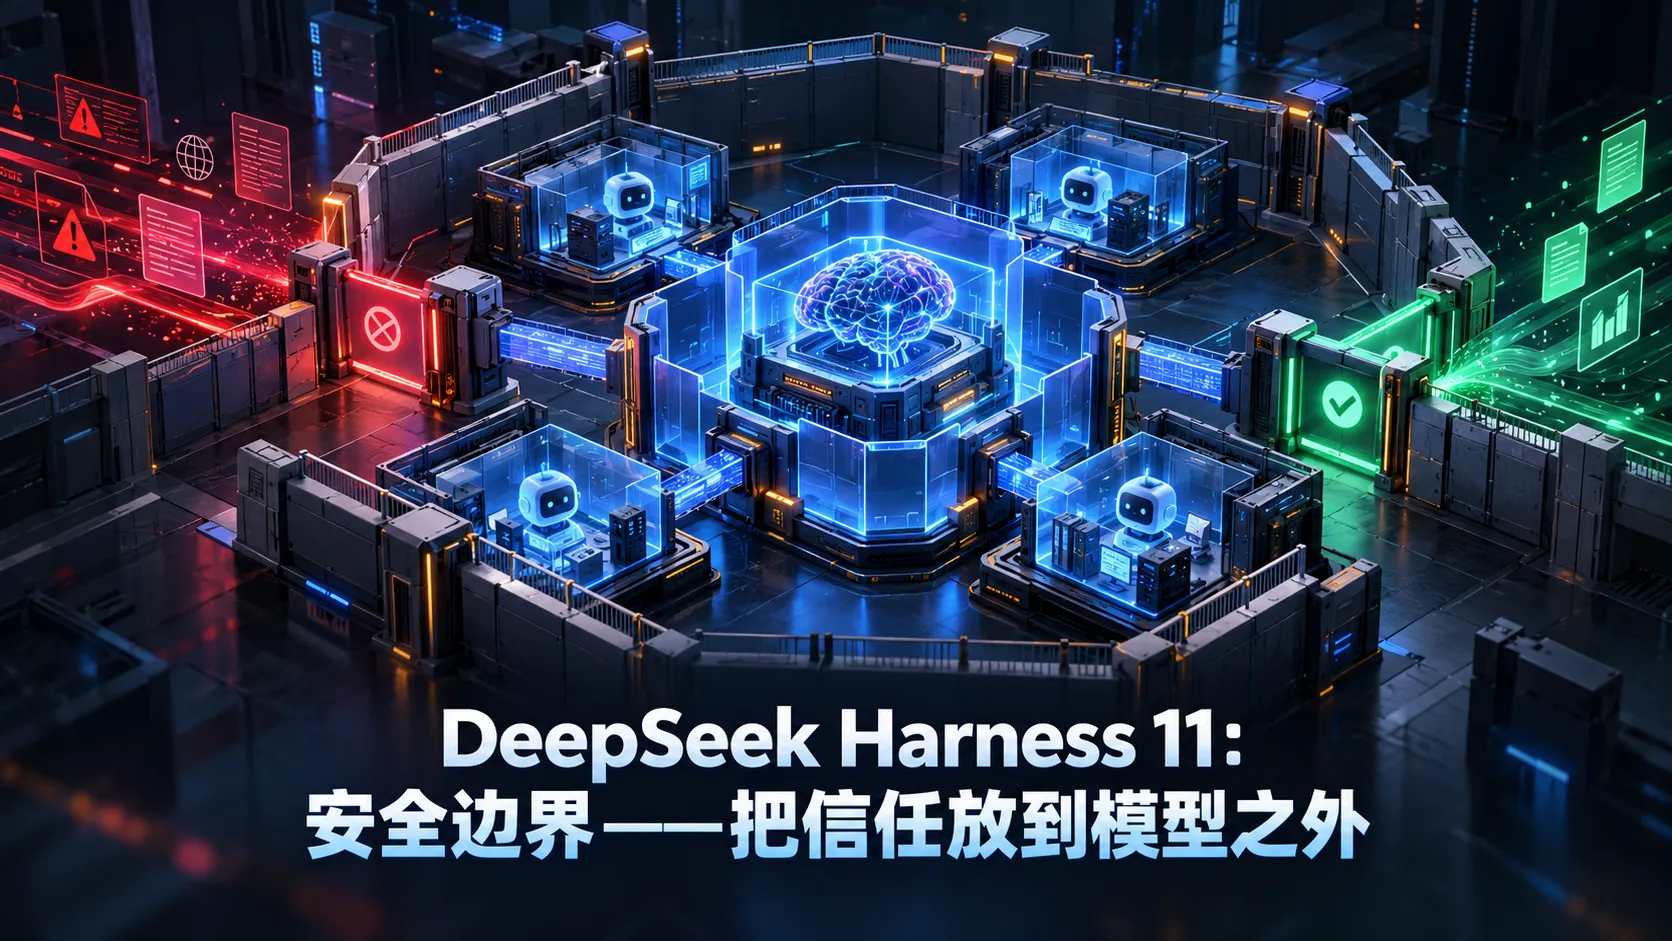
DSH 在架构上严格区分了决策平面(Decision Plane)与策略平面(Policy Plane):
- 模型与 Agent Loop 属于决策平面:它们负责基于当前上下文“提出下一步要做什么”;
- 安全策略、沙箱和权限中心属于策略平面:它们以绝对权威的上帝视角,对模型提出的每一个动作进行冷酷的准入鉴权。
  flowchart TD
  subgraph DecisionPlane ["决策平面 (Decision Plane)"]
    LLM["大语言模型 (提出操作动作)"]
  end

  subgraph PolicyPlane ["外部策略平面 (Policy Plane)"]
    Gate["策略准入网关"]
    Approval["1. Approval 审批服务<br/>高危操作强制中断挂起,唤醒人工确认"]
    Sandbox["2. Sandbox 隔离容器<br/>物理限制文件写入路径、网络端口与进程树"]
    Creds["3. Credentials 凭据保护<br/>敏感密钥绝不暴露给模型或记入日志"]
    Audit["4. Audit 不可逆审计流<br/>如实记录所有鉴权拦截、取消与拒绝事件"]
  end

  subgraph World ["真实宿主机系统"]
    Target["物理文件 / 网络 / 生产服务"]
  end

  LLM --> Gate
  Gate --> Approval
  Gate --> Sandbox
  Gate --> Creds
  Gate --> Audit
  Sandbox --> Target
这四大安全机制拥有高于任何模型意图的绝对优先级:模型自己没有任何 API 能够“关掉安全检查”,也没有任何 Prompt 能够“劝说”策略网关临时放宽权限。
二、生死攸关的 Fail-Closed 原则
在网络安全与系统工程中,有两种失效策略:
- Fail-Open(失败默认放行):当鉴权服务崩溃或策略解析报错时,系统默认放行请求,优先保全业务可用性;
- Fail-Closed(失败默认关闭/阻断):当安全服务发生任何不可预期的异常时,系统立即掐断执行,优先保全系统安全性。
[!CAUTION]
DSH 核心准则:必须 Fail-Closed!
在 Agent 系统中,最危险的系统故障不是报错中断,而是静默降级为更大权限!
如果沙箱容器在初始化时超时、或者规则引擎解析某条安全 YAML 时发生语法报错,系统必须立即拒绝当前工具调用并报错挂起。绝对禁止为了“让流程跑下去”而悄悄回退到宿主机原生进程中裸奔执行!
同样,对于涉及人工审批(Approval)的操作:如果审批通知服务(如企业微信机器人或 Webhook)由于网络抖动无法送达,系统严禁将“通知发送失败”视为“用户已默认同意”,必须严格维持阻断状态。
三、对抗性攻击的残酷现实:实测数据复盘
有些人可能会怀疑:“外部注入攻击真的有那么容易得手吗?至于搞得这么草木皆兵吗?”
腾讯 AI-Infra-Guard 团队在 2026 年 8 月发布的系统性安全研究论文(arXiv: 2608.16393)为行业敲响了警钟。该研究针对包括 DSH 在内的多个主流 Agent 框架进行了超大规模的红蓝对抗实测:
| 评测维度 | 权威实测数据 |
|---|---|
| 受控对抗测试执行总量 | 14,560 次 |
| 测试的间接内容污染通道 | 16 种(包括文件内容、剪贴板、Git 提交信息、网络搜索结果等) |
| 实测的高级攻击方法变种 | 12 种(包括结构伪造、格式截断、隐写对抗等) |
| 最高攻击成功率(文件通道 / 隐藏 Unicode 模式) | 25.5% |
| 最高攻击成功率(纯文本通道 / Fake-Completion 模式) | 17.0% |
这项评测揭示了一个触目惊心的事实:在高达四分之一的场景下,黑客只需在某个开源仓库的某个源文件深处植入带有伪造结束符或隐藏 Unicode 的恶意注释,当 Agent 阅读该文件时,模型就会被成功诱导,自作主张发起删除系统或外泄密钥的工具调用!
这一实测数据彻底击碎了“依靠 Prompt 提示词保平安”的幻想。如果系统没有在外部建立物理沙箱与单调 Guard 拦截,25.5% 的注入成功率意味着任何一个自动化巡检 Agent 都在随时面临被黑客反客为主的致命风险。
四、安全策略的工程取舍
构筑坚固的安全防线并非没有代价:
- 交互摩擦:高频的审批弹窗会降低纯自动化的流畅度;
- 性能损耗:在 Docker 或轻量级沙箱中启动命令,会比直接在宿主机执行多出几十毫秒的容器开销;
- 配置复杂:开发者需要为不同的工作区精心编写权限白名单。
然而,在企业级工程落地中,“跑得慢一点”永远好过“把生产数据库误删”。DSH 通过把信任移出模型,用严密的外部策略平面守住了 Agent 走向严肃工业生产的生命线。