
DeepSeek Harness 10:Context Compaction——上下文工作集管理与成本优化
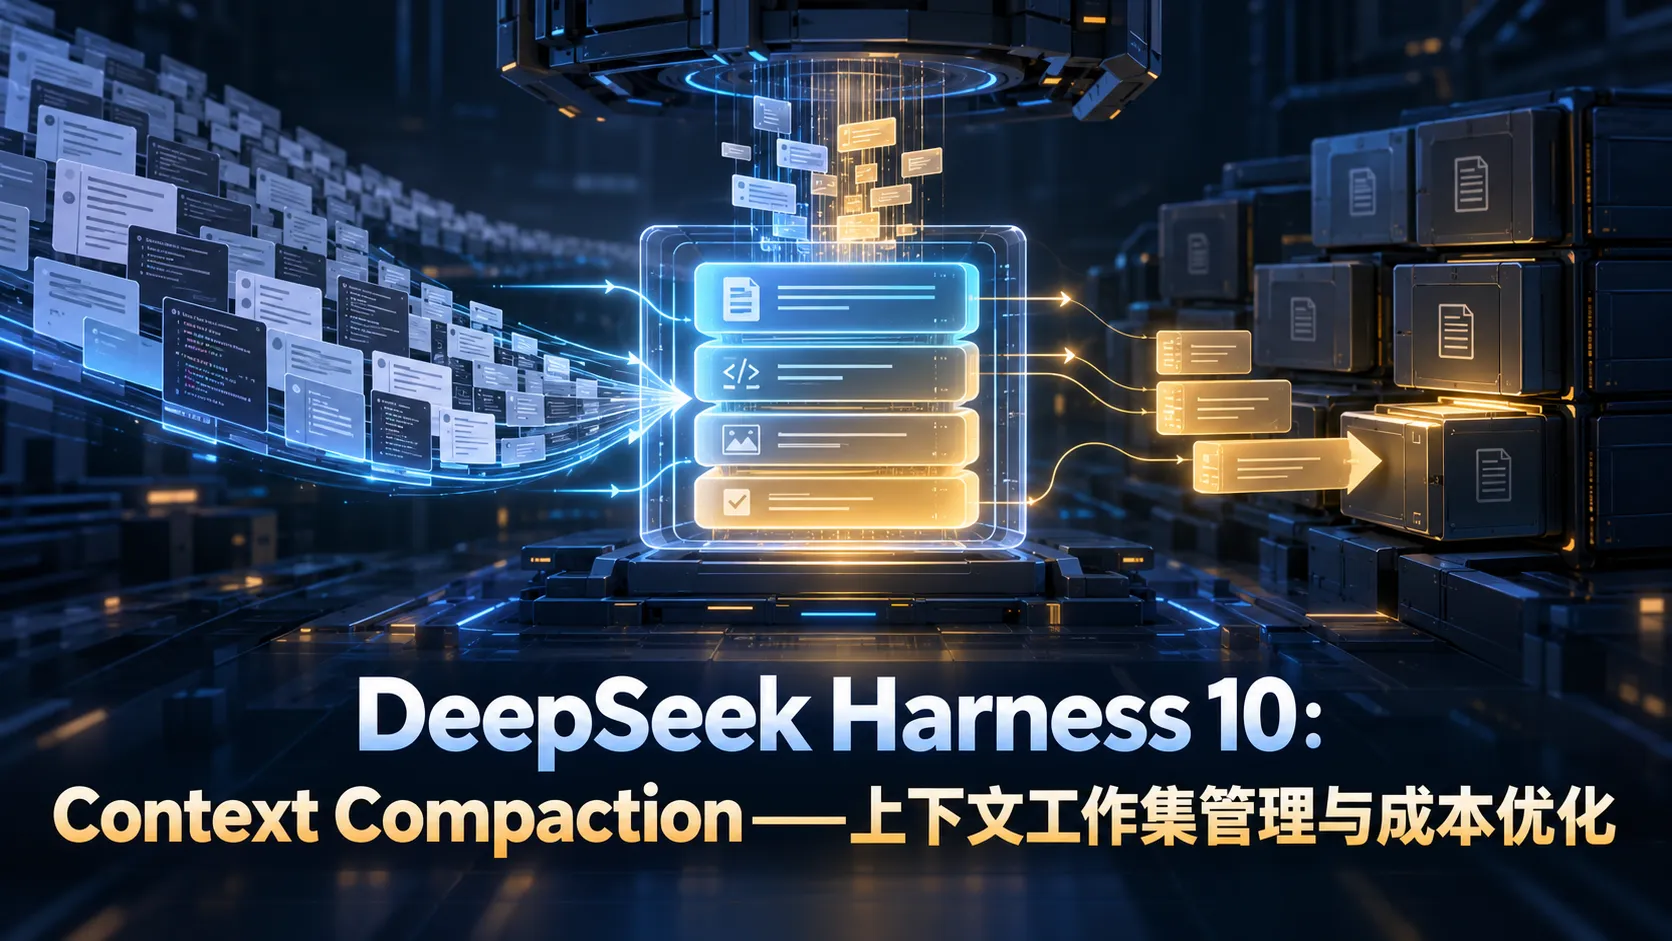
DeepSeek Harness 10:Context Compaction——上下文工作集管理与成本优化
Asaakii在真实的软件工程长程任务中,Agent 往往需要执行 30 轮甚至 80 轮以上的连续交互。如果每次都将从第 1 轮到当前轮次的完整对话记录全量塞进模型,系统将迅速面临三大灾难:
- 费用雪崩:随着上下文膨胀至 100k+ Token,单次推理费用呈现指数级增长;
- 大海捞针困境(Lost in the Middle):上下文充斥着海量已经无关紧要的中间临时输出,模型的注意力被严重稀释,开始遗忘最初的核心约束;
- 暴力截断的破窗效应:如果采用朴素的先进先出(FIFO)滑动窗口直接截断历史,极有可能把关键的初始需求、关键文件的路径或是未完成的任务凭据当场抹去。
DeepSeek Harness 提出了现代化的 Context Compaction(上下文工作集压缩与成本治理) 体系。
一、核心哲学:Context 是受管的工作集,而非聊天记录
DSH 在认知上做出了深刻的区分:
- Session Log 是系统完整且永恒的事实库:必须 100% 忠实记录每一秒发生的全部细节;
- Context 是为当前这一步决策动态准备的“工作集(Working Set)”:它必须高度紧凑、极度聚焦,只装载与当前任务直接相关的有效信息。
  flowchart TD
  RawLog["全量 Session Log 事实库<br/>(30 轮对话 / 200 个事件 / 150k Token)"]

  subgraph ContextBuilder ["上下文工作集构建器 (Context Builder)"]
    StablePrefix["1. 绝对稳定前缀 (System Prompt + Tools Schema)<br/>🎯 强制固定,100% 命中供应商 Prompt Cache"]
    CompactedHistory["2. 结构化压缩摘要 (Surface Replace Node)<br/>🎯 遮蔽过往 25 轮细节,保留核心语义与决策状态"]
    ActiveWindow["3. 活跃动态滑动窗口 (最近 3-5 轮最新交互)<br/>🎯 高保真展示当前正在进行的工具执行与讨论"]
  end

  Spill["SpillStore (溢出存储)<br/>将超大日志/文件文本脱敏外置,仅留哈希句柄"]

  RawLog --> ContextBuilder
  RawLog -.->|大结果剥离| Spill
  ContextBuilder --> LLM["极度紧凑且结构严谨的模型请求<br/>(耗费降低 75%,缓存命中率 > 90%)"]
二、压缩前后绝不能丢失的四大语义资产
上下文压缩绝对不是调用一个摘要模型写一段笼统的“会议纪要”。DSH 的压缩引擎在将一段历史序列转换为结构化摘要节点时,必须满足严格的语义保持约束:
| 关键资产 | 压缩时必须坚决保留的内容 | 丢失后的致命后果 |
|---|---|---|
| 1. 终极目标与不可逆约束 | 用户的初始业务意图、严格的代码规范、绝不能触碰的文件黑名单 | 模型开始自作主张修改不应修改的代码或偏离原始业务方向 |
| 2. 已发生的现实副作用 | 哪些文件已被创建/修改、数据库迁移执行到哪一步、外部 API 提交记录 | 模型误以为前期工作未完成,重复执行写入产生脏数据破坏 |
| 3. 挂起与未结状态 | 哪些子任务正在异步执行、等待人工审批的卡点、被取消的步骤状态 | 任务流程悬空,整个控制状态机失去下一步推进线索 |
| 4. 关键证据链与文件句柄 | 核心函数声明位置、排查出的异常堆栈行号、测试通过的基线版本 | 模型失去事实证据,重新开始大量无意义的低效全局检索 |
三、视图替换(Surface Replace):可解释的审计防线
在 DSH 中,压缩操作绝不会覆写或删除底层日志。压缩引擎在完成提炼后,会在日志中追加写入一条类型为 context/compacted 的特殊事实事件。
该事件显式声明了它所遮蔽的历史序列范围(如 shadowedEventRange: [12, 85])。
在后续的 deriveMessages() 计算中:
- 序列 12 到 85 的几十个事件被一个轻量级的摘要节点优雅遮蔽;
- 但如果后续排查故障,或者需要进行单步重演,审计员随时可以点击展开被遮蔽的区间,查看原始的每一个调用细节。
这保证了运行态的高效性与事后追溯的确定性之间的完美统一。
四、成本与缓存的系统工程:Prefix Cache 与 SpillStore
为了将工业级调用的开销压到最低,DSH 联合设计了两大系统组件:
1. 前缀绝对稳定化(Prefix Stability)
现代商业大模型(如 DeepSeek-V3、Claude 3.5 Sonnet 等)均配备了高性价比的 Prompt 缓存机制(按缓存命中计费,价格可低至原价的 10%)。
DSH 严格规定:
- System Prompt、内置基础能力声明、所有工具的 JSON Schema 必须严格放置在请求的最前缀;
- 严禁在最前缀注入带有动态时间戳(如
当前时间是 15:32:05)的易变内容!动态上下文一律后置,确保最前面的静态前缀能够以 100% 的极高概率命中云端 Prompt Cache。
2. SpillStore(超大输出溢出存储)
当某个工具执行产生超长输出时(例如运行 git log 或构建失败输出了 5000 行错误日志),如果全量塞入上下文,会瞬间击穿预算。
DSH 的 SpillStore 会在工具执行面自动拦截超长文本:
- 将完整原始内容持久化到本地磁盘的溢出缓存文件中;
- 向上层模型上下文仅仅投影该文件的路径引用、哈希摘要以及截取的前 50 行核心报错。
- 如果模型确实需要深入分析某一段,可以主动调用受限的文件切片读取工具精准检索。
通过这一套精密的工作集治理与成本工程,DSH 让 Agent 即使面对长达上百步的企业级长程研发任务,依然能够保持如初次启动般的清醒判断力与极低的资源消耗。
喜欢这篇文章的人也看了
评论
匿名评论隐私政策
✅ 你无需删除空行,直接评论以获取最佳展示效果





