在构建 Agent 系统时,不同大语言模型厂商的 API 接口存在显著差异:
OpenAI 采用专有的 tool_calls JSON 数组与特定流式增量;
Anthropic Claude 采用块结构(Content Blocks)与输入增量协议;
DeepSeek 拥有原生思维链(Reason ...
仅仅知道“一切皆插件”还不足以跑通一个真实的系统。当用户在终端键入启动命令时,系统必须确定地回答三个问题:
本次启动到底安装并激活了哪些插件?
当命令行参数、全局配置文件与内置策略发生冲突时,谁拥有最终裁决权?
当我们将系统底层的文件系统服务换成远程 Docker 沙箱时,终端、代码编辑器与语法分 ...
在很多框架中,想要给系统添加功能,最简单的做法是写一个独立进程的 MCP(Model Context Protocol)服务,或者改改配置文件然后重启整个服务。
但如果你的系统需要在进程内部替换一个持有大量内存状态的组件(例如正在持续运行的会话存储、动态更新的上下文管理器、甚至是控制整个任务步进的 ...
在探讨大语言模型(LLM)的工程落地时,“写一段 Prompt 调一次 API”与“交付一个能在复杂真实环境中自主作业的 Agent 系统”,中间隔着一道巨大的工程鸿沟。
很多初学者容易将 Agent 框架想象为一个封装了 LLM SDK 的轮询脚本。但一旦将这样的脚本放进生产环境,就会立刻面临状态 ...
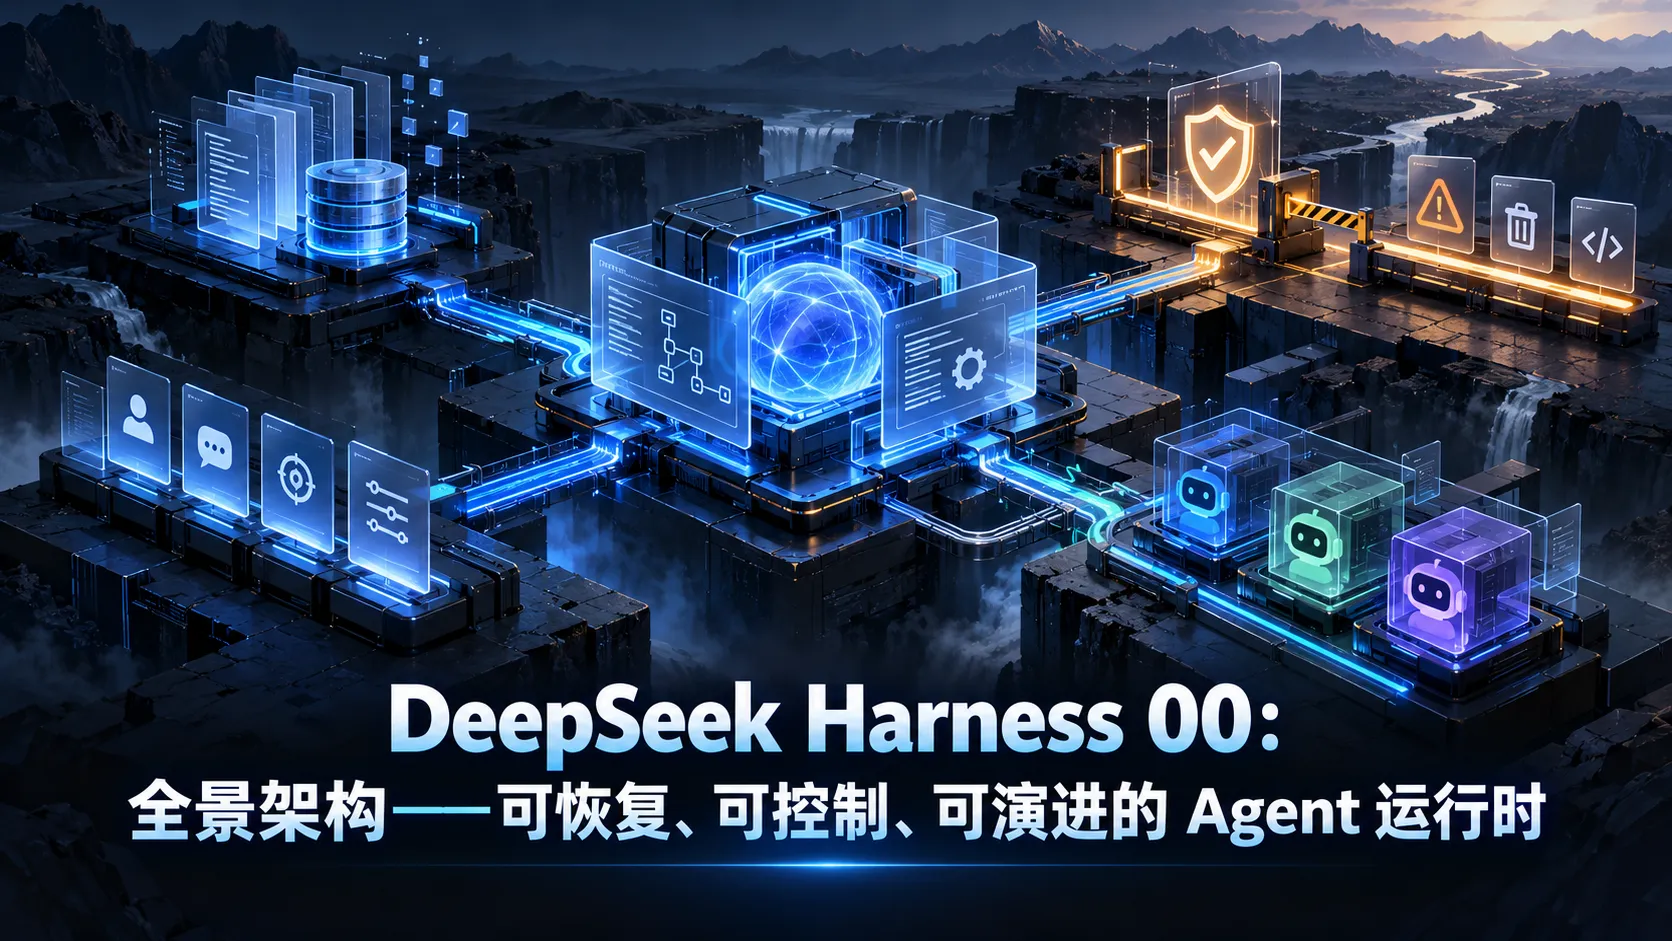
调用一次大语言模型(LLM)API 写一段脚本很简单。困难的是让一个 Agent 连续自主执行几十轮任务:
在中途允许用户打断并调整目标;
在进程异常崩溃后能够完整恢复状态;
在执行高危操作(如删除文件、推送代码)前强制暂停并等待人工审批;
能向开发者清晰解释每一个系统副作用到底是如何发生的。
...
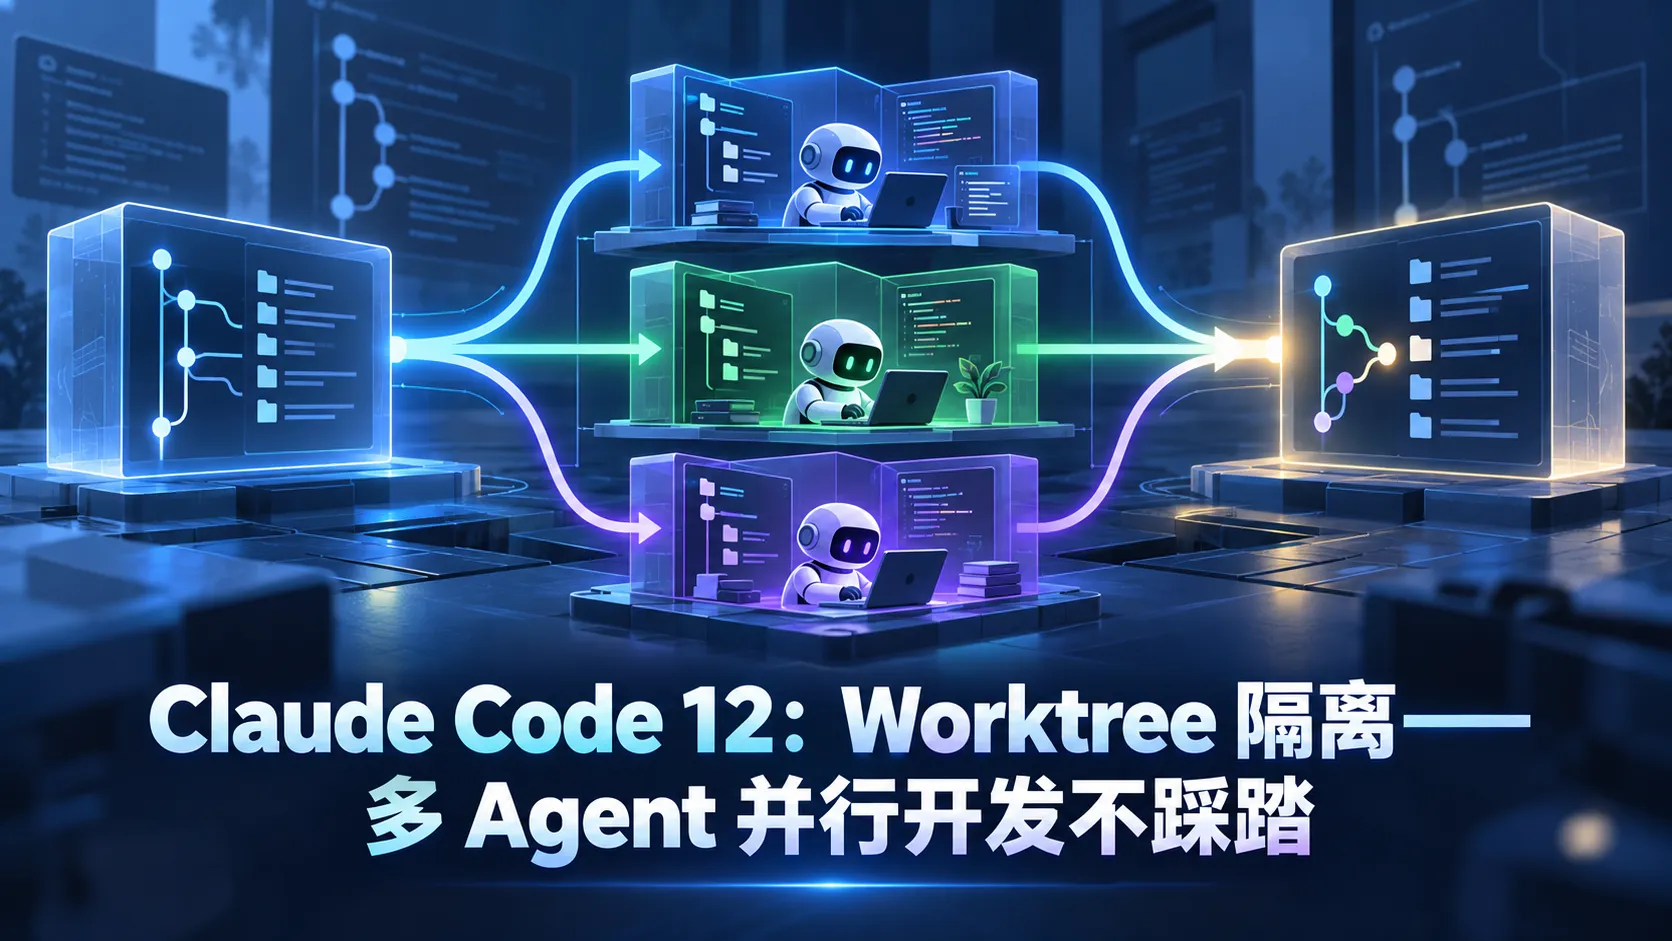
当我们的 Agent 团队进化为能够自主抢单的自组织集群后,一个致命的物理瓶颈赫然挡在面前:文件系统踩踏(File Stepping Collision)。
设想 Worker A 正在重构用户鉴权逻辑,Worker B 正在为 API 编写集成单测。如果两者都在同一个物理工程目录下工作:
未提交 ...
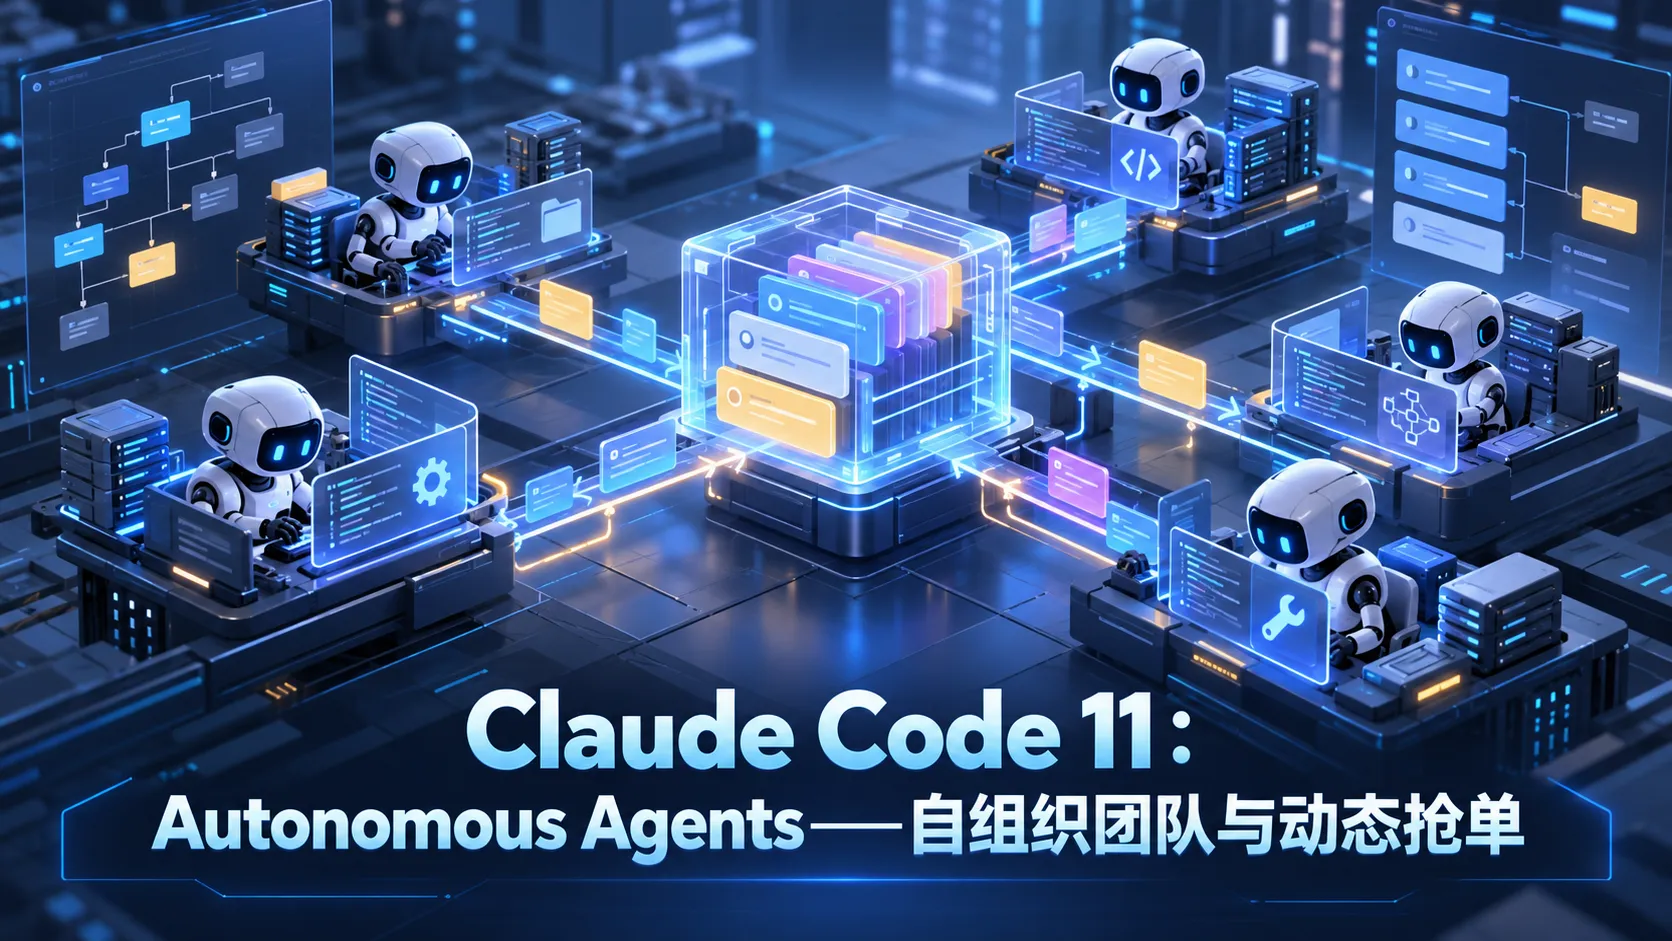
在中心化多智能体团队中,所有任务的生命周期都依赖 Leader 进行人工调度:Leader 拆解任务、Leader 挨个点名分配、Leader 轮询等待每个 Worker 汇报。
这种“主管加员工”的中心化模式在面对几十个模块并行改造时,会迅速遇到Leader 吞吐瓶颈:
Leader 上下文严重 ...
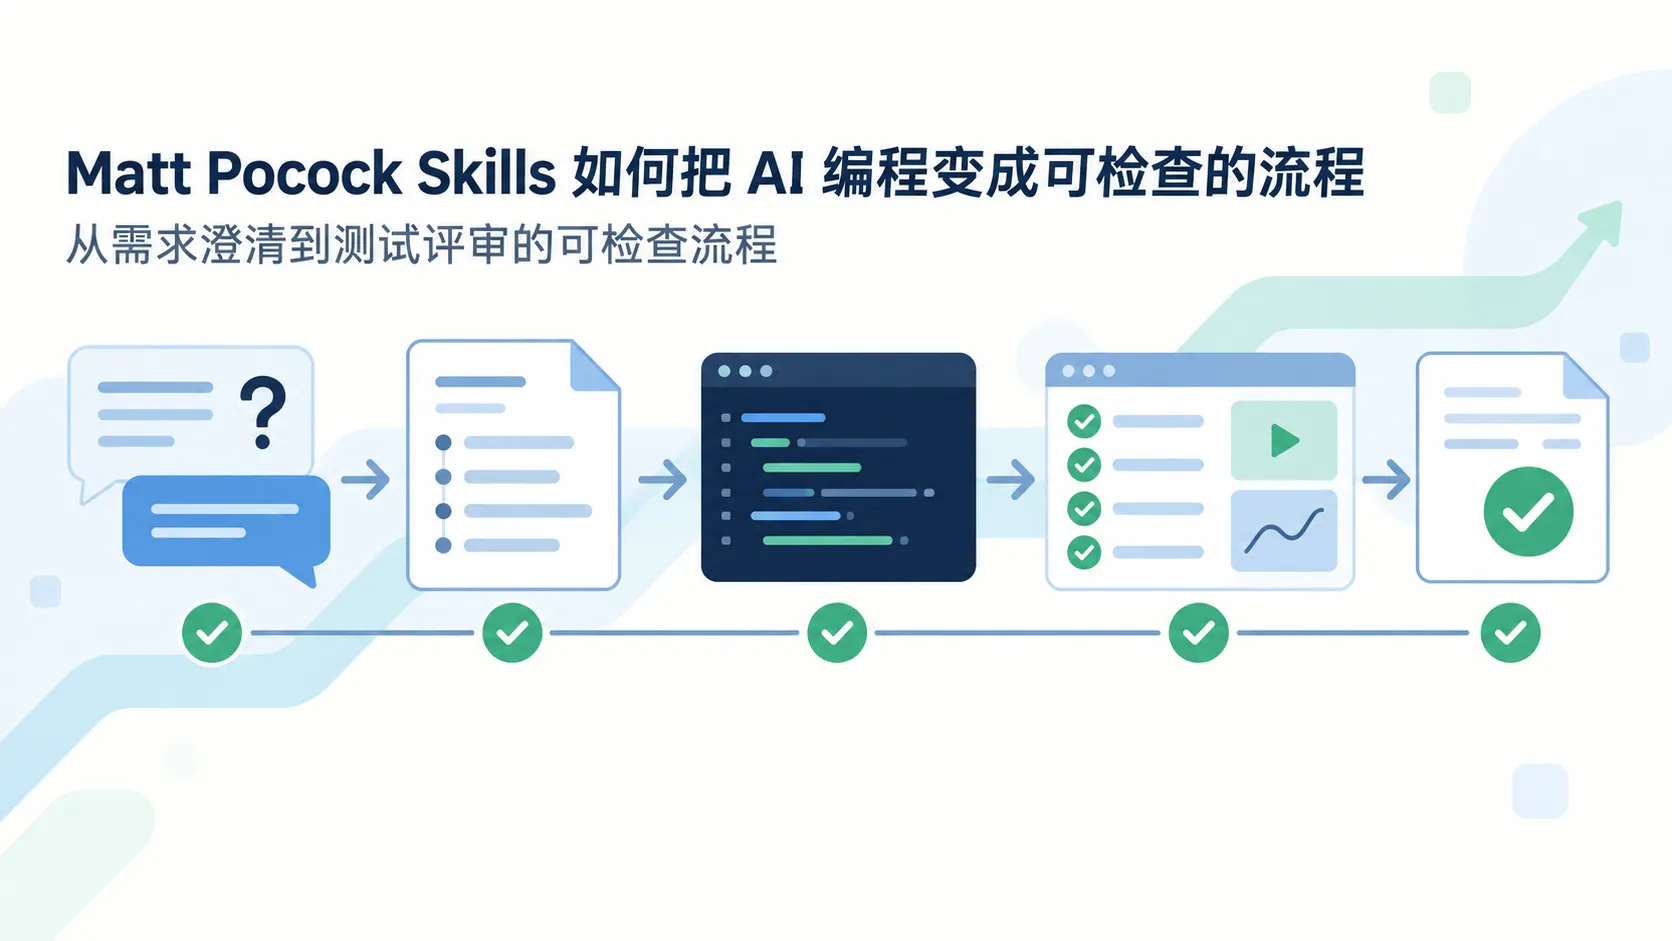
核验范围:本文以 mattpocock/skills 官方仓库 的 main 分支为主要来源,阅读了 README.md、.claude-plugin/plugin.json、ADR-0002、grilling、writing-great-skills,并核对了 implement 的流 ...
在上一篇中,我们构建了基于磁盘 Mailbox 的文件消息总线,使 Agent 团队成员之间能够互发消息。
然而,如果消息只是任意的自由自然语言文本,团队很快会在高风险场景中陷入混乱与失控:
强制关机导致数据损坏:Leader 突然发一句“请停止工作退出”,而 Coder 正在写入关键文件,强行退 ...
在第 4 篇中,我们引入了 Subagent(子智能体)。但那时的 Subagent 是一次性的临时工:任务派生出去,子 Agent 执行完毕返回纯文本结论后随即被销毁。它没有持久化的团队身份,不能与其他平级 Worker 交流,更无法支持长期跨会话的多方协同。
当面对庞大的工程重构——例如微服务拆 ...

