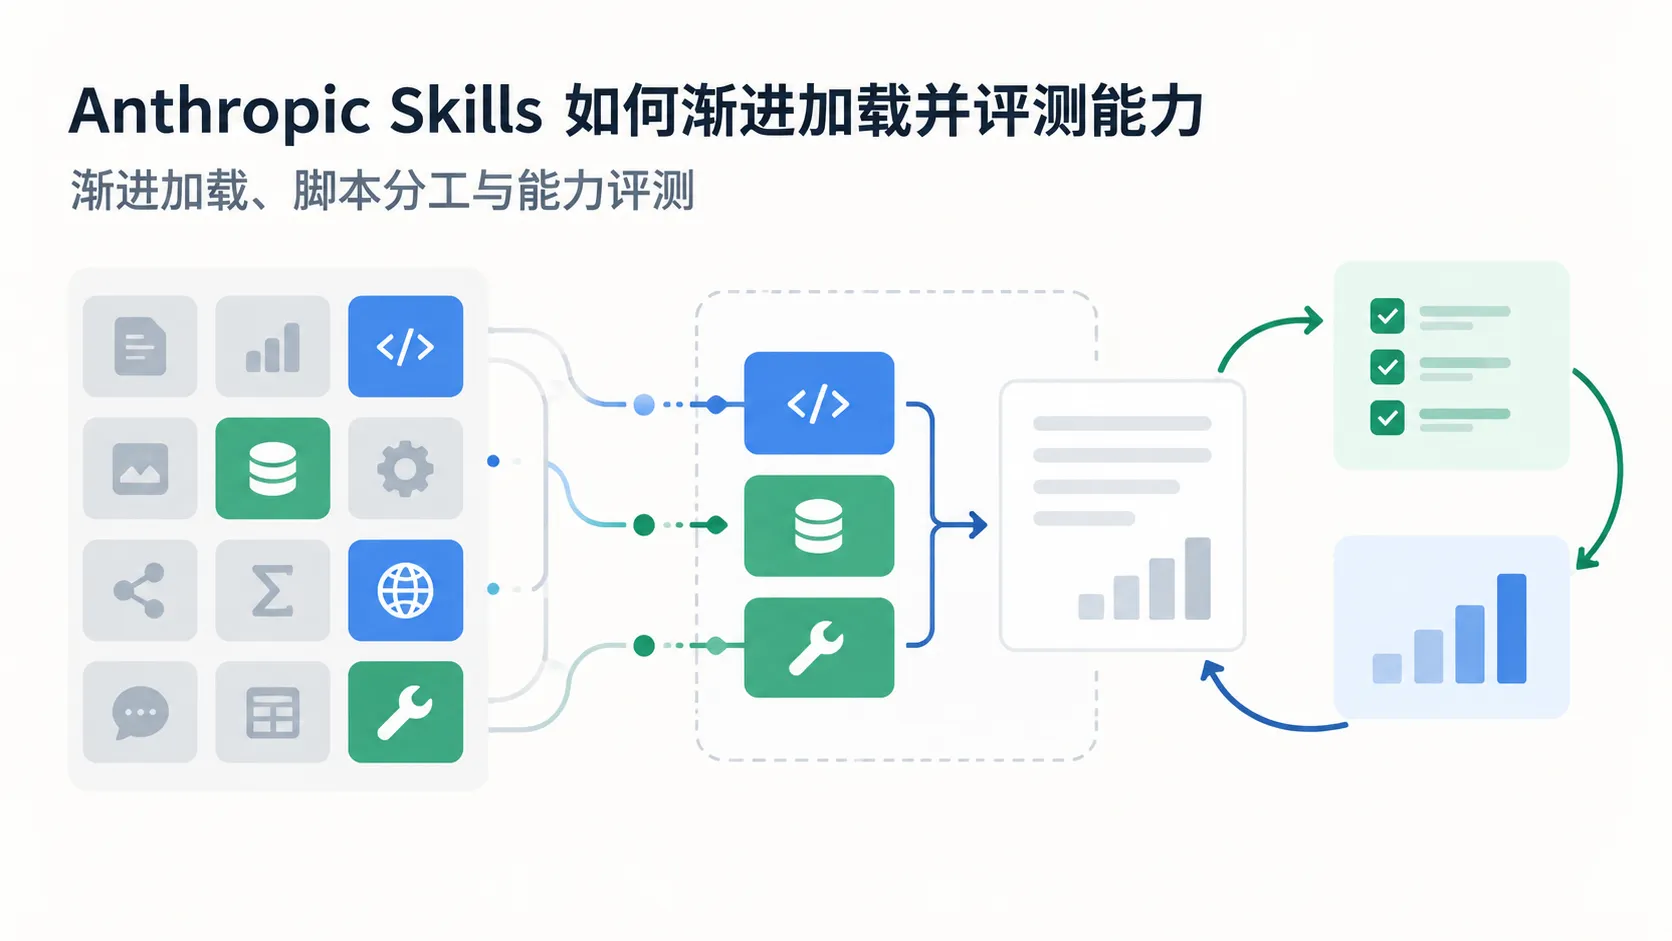
在构建企业级智能体或研发辅助 Agent 时,团队往往会面临一个典型的困境:随着业务能力的增加,团队希望让 Agent 既精通数据库慢查询排查,又精通 Kubernetes 资源发布,还熟悉前端代码审查规范。
传统最直接的做法,是把所有业务 SOP、接口文档和编码规范全部堆进全局的 System Prompt 。这种做法有三个致命硬伤:
Token 浪费与成本飙升 :即使用户只是打个招呼或者问个天气,模型也必须吞吐几万字的规则文档。上下文污染与注意力涣散(Lost in the Middle) :过长且无关的提示词会稀释大模型的注意力,导致在关键指令上产生“指令遗忘”或执行走样。团队协作维护噩梦 :不同部门的规范混在一个巨大的文本里,改动极易相互冲突。
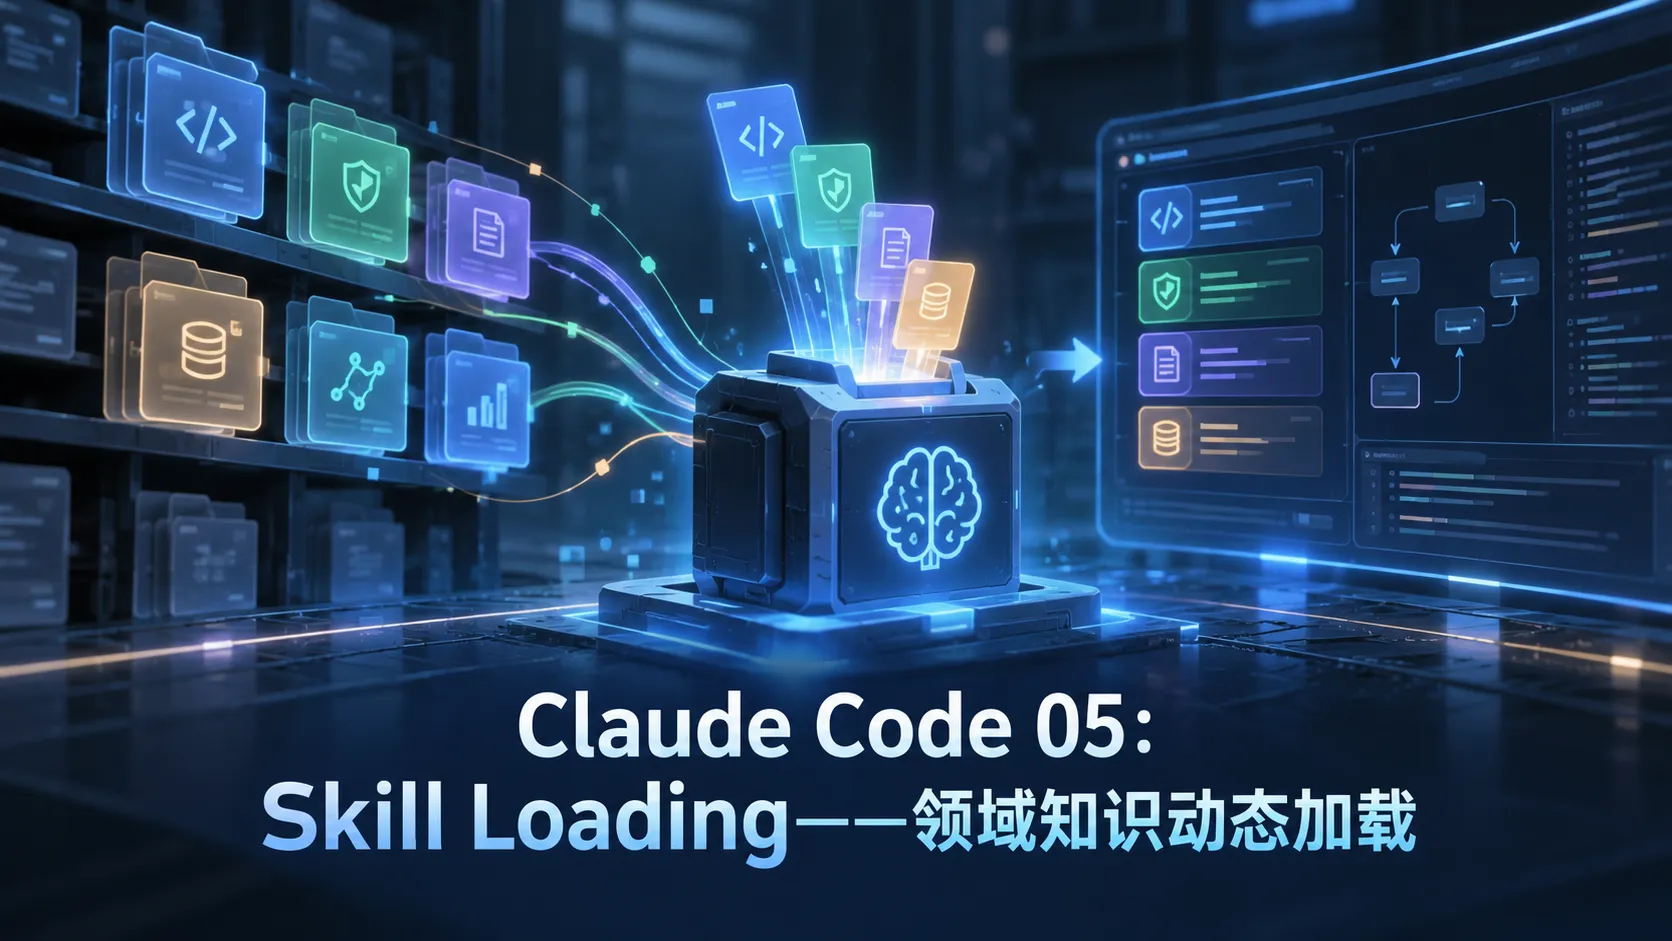
Anthropic 在其命令行编程助手 Claude Code 中推广的 Skill(技能)机制 ,给出了一个极具工程美感的解决方案:将专业技能拆分为相互独立的模块化文件,按需动态加载(On-demand Loading),用完即走,不占用常驻上下文 。
核心设计:按需翻阅的“技能书”模型 Skill 机制的哲学可以类比为人类专家的工作方式:一位全栈架构师并不需要每分每秒把《MySQL 性能优化》和《Kubernetes 权威指南》完整背诵在大脑工作内存中;当遇到数据库问题时,才去书架上翻开对应的操作手册:
  flowchart TD
    UserInput["用户输入: 线上 MySQL 出现慢查询,帮我排查"] --> Matcher["意图路由 / 技能匹配器 (Router)"]

    subgraph SkillRegistry ["模块化技能仓库 (Skills Registry)"]
        direction TB
        S1["Skill 1: code-review (代码审查规范)"]
        S2["Skill 2: database-ops (数据库排查手册)"]
        S3["Skill 3: k8s-deploy (集群发布 SOP)"]
    end

    Matcher -->|"仅匹配元数据 Summary"| SkillRegistry
    SkillRegistry -->|"动态挂载命中项"| S2

    subgraph DynamicContext ["动态组装的推理上下文"]
        BaseSystem["轻量级 Base System Prompt (通用身份定义)"]
        InjectedSkill["当前激活技能: database-ops/SKILL.md 完整指令"]
        BaseSystem --- InjectedSkill
    end

    S2 --> InjectedSkill
    DynamicContext --> MainLLM["主思考大模型 (Claude Opus / Sonnet)"]
    MainLLM --> Output(["生成专业、精准且符合 SOP 的处置方案"])
Skill 目录规范与文件结构 一个合规的 Skill 采用类似静态博客或静态站点的轻量文件组织结构:
1
2
3
4
5
6
7
8
9
skills/ ├── database-ops/ │ ├── SKILL.md # 必须:技能核心规范(含 YAML Frontmatter 与操作指令) │ └── references/ # 可选:供深入检索的补充排查手册 │ └── explain-guide.md ├── code-review/ │ └── SKILL.md └── k8s-deploy/ └── SKILL.md
标准 SKILL.md 模板示范 SKILL.md 的核心在于顶部的 YAML Frontmatter,它向路由器暴露了技能的名称与触发条件:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
--- name: database-ops description: > 生产级数据库运维操作指南,包含 MySQL 慢查询分析、索引优化与锁冲突排查。 当用户提到"数据库"、"慢查询"、"SQL 优化"、"死锁"时动态激活。 --- # 数据库排查与优化指南 ## 1. 慢查询分析标准操作流 (SOP) 当排查线上慢查询时,必须引导用户按以下顺序提供信息: 1. 先确认是否通过 `EXPLAIN` 查看了实际执行计划,检查 `type` 是否为 `ALL` (全表扫描)。2. 检查 `rows` 扫描行数与实际返回行数的比例。3. 检查 `key` 字段是否有效命中预期索引。## 2. 索引设计红线 - 严禁在基数极低(如 status 仅有 0/1)的字段上建立单列索引。- 联合索引必须严格遵循最左前缀原则。- 涉及范围查询(`<` , `>` )的字段必须放在联合索引的最右侧。## 3. 输出格式 按以下结构给出排查结论: - **【核心瓶颈诊断】** :说明慢查询根因。- **【执行计划分析】** :针对 key/type 进行分析。- **【优化改写建议】** :给出具体 SQL 改写或 `ALTER TABLE` 语句。
从零实现:支持动态 Skill 加载的 Agent 我们不需要安装 Claude Code 客户端,只需利用 Python 即可实现一个具备相同能力的 SkillAgent。
1. 技能扫描与元数据提取器 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 import osimport refrom pathlib import Pathfrom typing import Optional from anthropic import Anthropicclient = Anthropic() class SkillAgent : """具备按需加载技能能力的现代化智能体""" def __init__ (self, skills_dir: str = "./skills" ): self .skills_dir = Path(skills_dir) self .skills_meta: list [dict ] = self ._index_skills() def _index_skills (self ) -> list [dict ]: """扫描本地目录,仅提取各 Skill 的 name 与 description 元数据""" indexed = [] if not self .skills_dir.exists(): return indexed for s_dir in self .skills_dir.iterdir(): skill_file = s_dir / "SKILL.md" if s_dir.is_dir() and skill_file.exists(): text = skill_file.read_text(encoding="utf-8" ) name_match = re.search(r"^name:\s*(.+)$" , text, re.MULTILINE) desc_match = re.search(r"^description:\s*>?(.*?)(?=---|\n#)" , text, re.DOTALL | re.MULTILINE) if name_match: name = name_match.group(1 ).strip() desc = desc_match.group(1 ).strip() if desc_match else "" indexed.append({ "name" : name, "description" : desc, "file_path" : skill_file, }) return indexed def _match_skill (self, user_query: str ) -> Optional [dict ]: """利用轻量快速模型做意图匹配,毫秒级判定该加载哪本技能书""" if not self .skills_meta: return None skills_summary = "\n" .join([ f"- 技能标识 [{s['name' ]} ]: {s['description' ]} " for s in self .skills_meta ]) router_prompt = f"""根据用户的输入,判断是否需要激活特定的专业技能。 可用技能库: {skills_summary} 用户当前输入: "{user_query} " 判定规则: 若匹配,仅输出对应的技能标识(例如: database-ops)。 若无任何技能匹配,仅输出 NONE。不要输出多余解释。""" res = client.messages.create( model="claude-3-5-haiku-20241022" , max_tokens=20 , temperature=0 , messages=[{"role" : "user" , "content" : router_prompt}], ) matched_name = res.content[0 ].text.strip() for s in self .skills_meta: if s["name" ] == matched_name: return s return None def run (self, user_query: str ) -> str : """主执行流程:意图匹配 -> 动态装配 -> 执行主推理""" base_system = "你是一个高水平的技术工程助手。用客观、严谨且精炼的中文回答。" matched = self ._match_skill(user_query) if matched: print (f"💡 [动态技能激活] 命中技能: {matched['name' ]} " ) skill_content = matched["file_path" ].read_text(encoding="utf-8" ) clean_instruction = re.sub(r"^---.*?---\s*" , "" , skill_content, flags=re.DOTALL) system_prompt = f"{base_system} \n\n# 【当前激活领域技能规范】\n{clean_instruction} " else : print ("ℹ️ [通用模式] 未命中特定技能,使用基础系统指令" ) system_prompt = base_system response = client.messages.create( model="claude-opus-4-5" , max_tokens=3000 , system=system_prompt, messages=[{"role" : "user" , "content" : user_query}], ) return response.content[0 ].text
编写高质量 Skill 的四项黄金法则 在为 Agent 沉淀技能库时,以下工程原则至关重要:
单一职责原则(Single Responsibility) :每个 Skill 必须高度聚焦在单一垂直场景(如“代码审查”、“SQL 排查”、“接口文档生成”),严禁把相互无关的运维手册与财务规范混入同一个文件。触发词明确具体 :在 description 中明确列出触发该技能的高频技术专有名词和典型场景,便于路由器准确识别。指令使用祈使句与具体 SOP :大模型更适合执行“先做 A,再做 B,输出格式为 C”这种指令式 SOP,而非宽泛的概念科普。严格控制 Token 长度 :单篇 SKILL.md 建议控制在 300~500 行以内。如果业务背景极长,应放入 references/ 目录供二级细粒度检索。
优缺点分析与工程选型边界 核心优势
极致的上下文经济性 :将数万字的领域知识压缩为若干短句 Summary,只有真正命中时才产生 Token 开销。团队资产沉淀极佳 :每个工程师都可以把自己擅长领域的排查经验提炼成一个独立的 Markdown 文件,PR 提交后全团队立即共享该技能。解耦无框架依赖 :底层只是纯 Markdown 文件,既可以无缝对接 Claude Code,也可以嵌入自研的 Python、Go 或 Node.js 智能体服务。
现实痛点与妥协
多一轮路由判定开销 :在未命中显式 Slash Command(如 /skill xxx)时,需要前置调用一次轻量模型判定,增加数十毫秒的网络延时。复杂场景下的技能冲突 :如果存在两个定义边界模糊的技能(例如“SQL 重构”与“数据库排查”),路由器可能会出现摆动或误激活。
关联导航