Agent 框架 09:LangChain——生态全景、LCEL 管道与架构反思
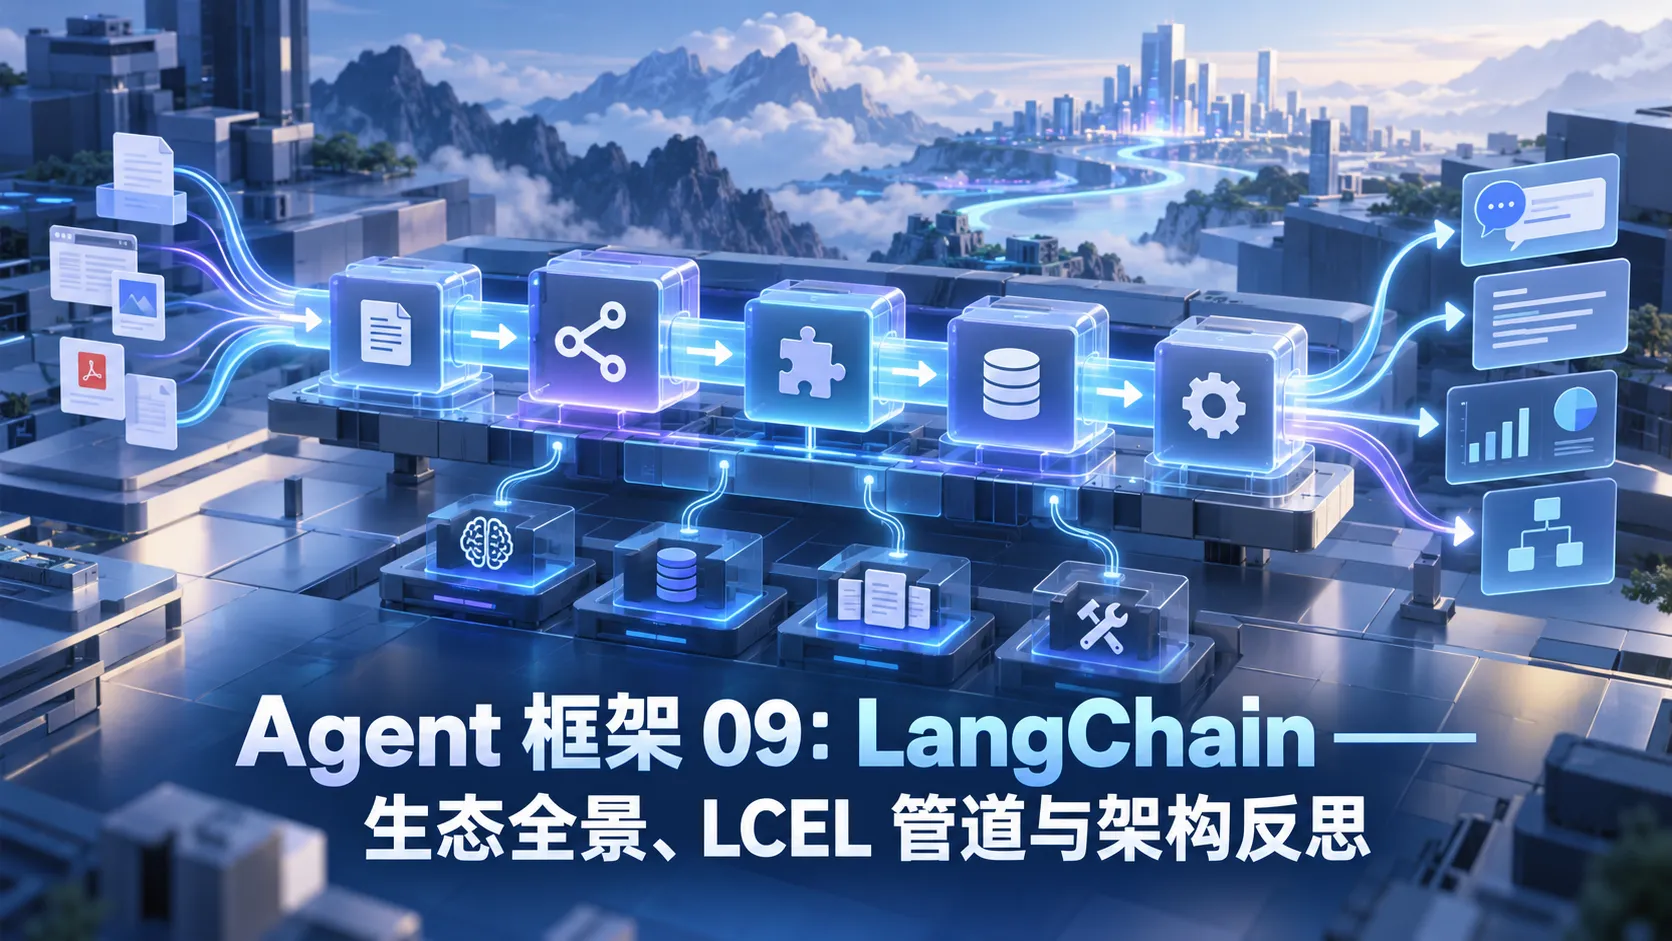
Agent 框架 09:LangChain——生态全景、LCEL 管道与架构反思
Asaakii提及大语言模型与智能体开发,LangChain 是绝对无法绕开的名字。它在 GitHub 上斩获了近十万颗星标,几乎成了 LLM 应用开发的代名词。许多开发者编写的第一行大模型调用代码,就是通过 LangChain 开始的。
然而,在工业界与工程社区中,LangChain 同样是被吐槽、被重构乃至被团队“去 LangChain 化”最多的框架之一:“过度抽象”、“文档混乱”、“API 频繁破坏性断代”、“排查一个空指针要翻阅 30 层调用栈”。
作为技术选型调研,我们既不能盲目神化它,也不能因噎废食全盘否定。本文旨在穿透其纷繁复杂的类库外表,厘清 LangChain 的核心演进逻辑(LCEL)、它不可替代的生态资产、以及在严肃生产环境中应如何克制地使用它。
架构演进:从 v0.1 繁重继承到 v0.2+ LCEL 管道
LangChain 经历过一次极其彻底的思想重构:
  flowchart TD
    subgraph V1 ["旧时代 v0.1 (面向对象与繁重继承)"]
        direction TB
        LLMChain["LLMChain (显式链类)"] --> PromptTemplate["PromptTemplate 绑定"]
        PromptTemplate --> OutputParserOld["OutputParser (硬编码回调)"]
        style V1 fill:#f9f0f0,stroke:#d9534f
    end

    subgraph V2 ["现代化 v0.2+ (LCEL 函数式管道组合)"]
        direction TB
        InputDict["输入字典 Map"] --> P["ChatPromptTemplate"]
        P -->|" | 管道符 "| M["ChatModel (统一 Runnable 接口)"]
        M -->|" | 管道符 "| O["StrOutputParser"]
        style V2 fill:#f0f9f0,stroke:#5cb85c
    end
1. v0.1 旧式写法(已废弃)
在早期版本中,每个功能都被包裹成一个专有类,参数靠黑盒字典隐式流转:
1 | # 旧版繁重写法 (不推荐) |
2. v0.2+ 现代写法:LCEL 管道
现代 LangChain 放弃了深层类继承,转而采用类似 Unix 管道的 | 操作符与统一的 Runnable 协议:
1 | # 现代 LCEL 写法 (标准推荐) |
LCEL 核心基语:函数式管道组合
LCEL(LangChain Expression Language)的设计核心是:所有组件均实现 Runnable 协议。无论同步、异步、批处理还是流式,接口完全统一。
1. 动态分支与并行流水线(RunnableParallel)
利用管道符号,可以极简地表达并行分支计算:
1 | from langchain_core.runnables import RunnableLambda, RunnableParallel |
LangChain 真正强大的基本盘:工业级 RAG 生态
如果说在单体 Agent 决策逻辑上 LangChain 屡受争议,那么在 RAG(检索增强生成)与非结构化数据处理 领域,LangChain 积累的生态资产是无与伦比的:从 PDF/Word/Notion/GitHub 等数百种 DocumentLoader,到各类文本分块算法,再到几乎所有向量数据库的连接器。
标准的 RAG 端到端构建只需十几行优雅的 LCEL 代码:
1 | from langchain_community.document_loaders import TextLoader |
Agent 工具调用与执行器
在传统 LangChain 中,通过 create_tool_calling_agent 与 AgentExecutor 组合实现 ReAct 循环:
1 | from langchain_core.tools import tool |
生产级可观测性:LangSmith 赋能
LangChain 团队最成功的商业化产品是其配套的可观测性平台 LangSmith。只需配置环境变量,全链路每个 Token 的消耗、Latency 延迟以及 Prompt 渲染细节都会被自动捕获:
1 | export LANGCHAIN_TRACING_V2="true" |
为什么很多团队想放弃 LangChain?架构痛点与反思
在经历了从兴奋到疲惫之后,工业界对 LangChain 的批评主要集中在以下三个方面:
1. 过度抽象与类膨胀(Over-abstraction)
在 Python 官方 SDK 中,调用一次聊天只需要:
1 | client.chat.completions.create(model="gpt-4o", messages=[{"role": "user", "content": "hi"}]) |
而在早期 LangChain 中,开发者需要面对 LLM、BaseLanguageModel、BaseChatModel、ChatPromptTemplate、SystemMessagePromptTemplate、HumanMessagePromptTemplate、OutputFixingParser 等上百个类。当业务变复杂时,这种抽象层不仅没有减少代码量,反而成了一层厚厚的迷雾。
2. 破坏性重构太频繁(Breaking Changes)
从早期的顶级命名空间导入,到后来的拆包(langchain-core、langchain-community、langchain-openai),再到类方法的重命名,2023 年编写的 LangChain 代码在 2024、2025 年的版本中几乎无法直接运行,带来了沉重的升级与维护包袱。
3. 错误排查极度困难
一旦某处配置出错,控制台会打印出穿透了 20~30 个内部框架文件的巨大 Traceback,深陷在装饰器、RunnableGenerator 和回调管理器中,定位真正出问题的函数签名极为痛苦。
理性选型准则:如何正确使用 LangChain 生态?
经过整个社区的反复博弈,目前业内形成了一种共识性的最佳实践准则:
  flowchart TD
    Task["业务系统研发需求"] --> Needs{"模块诉求分类"}

    Needs -- "文档解析 / 文本分块 / 向量库集成" --> UseLC["✅ 选用 LangChain Community 工具生态"]
    Needs -- "微观单步 LLM 格式转换" --> UseLCEL["✅ 选用轻量 LCEL 管道 (langchain-core)"]
    Needs -- "复杂多步循环 / 人工审批 / 状态机 Agent" --> UseGraph["🚫 弃用 AgentExecutor\n👉 全面改用 LangGraph 状态图"]
    Needs -- "简单确定性业务逻辑" --> UseRaw["🚫 弃用框架\n👉 直接使用原厂官方 SDK 手写"]
- 取其精华:善用
langchain-community和langchain-text-splitters,避免重复手写海量格式的文件解析器与分块逻辑。 - 去其糟粕:严禁在复杂的生产核心逻辑中使用
AgentExecutor。涉及多步骤跳转、循环重试、持久化断点的智能体,必须迁移至以图为核心的 LangGraph。