Claude Code 04:Subagent——上下文隔离的正确姿势
Claude Code 04:Subagent——上下文隔离的正确姿势
Asaakii在构建自主 Coding Agent 的过程中,一个不可逆的物理规律是:Agent 运行的轮次越多,messages 消息数组就会越发庞大。
设想主 Agent 正在执行重构任务,期间需要确认:“当前仓库采用的单测框架是 jest 还是 vitest?”
为了得出这个结论,Agent 可能需要依次读取 package.json、tsconfig.json、vite.config.ts、检查 tests/ 目录以及执行一次试探性命令。这短短的探索过程产生了 5 次文件读取和上千行文本输出。
如果所有操作都在主对话中发生,这数千行的临时代码会永久滞留在主消息栈中。主 Agent 最终只想要一个词“vitest”,却为此背负了沉重的 Token 包袱,导致后续真正核心的代码修改因为上下文拥挤而频发幻觉。
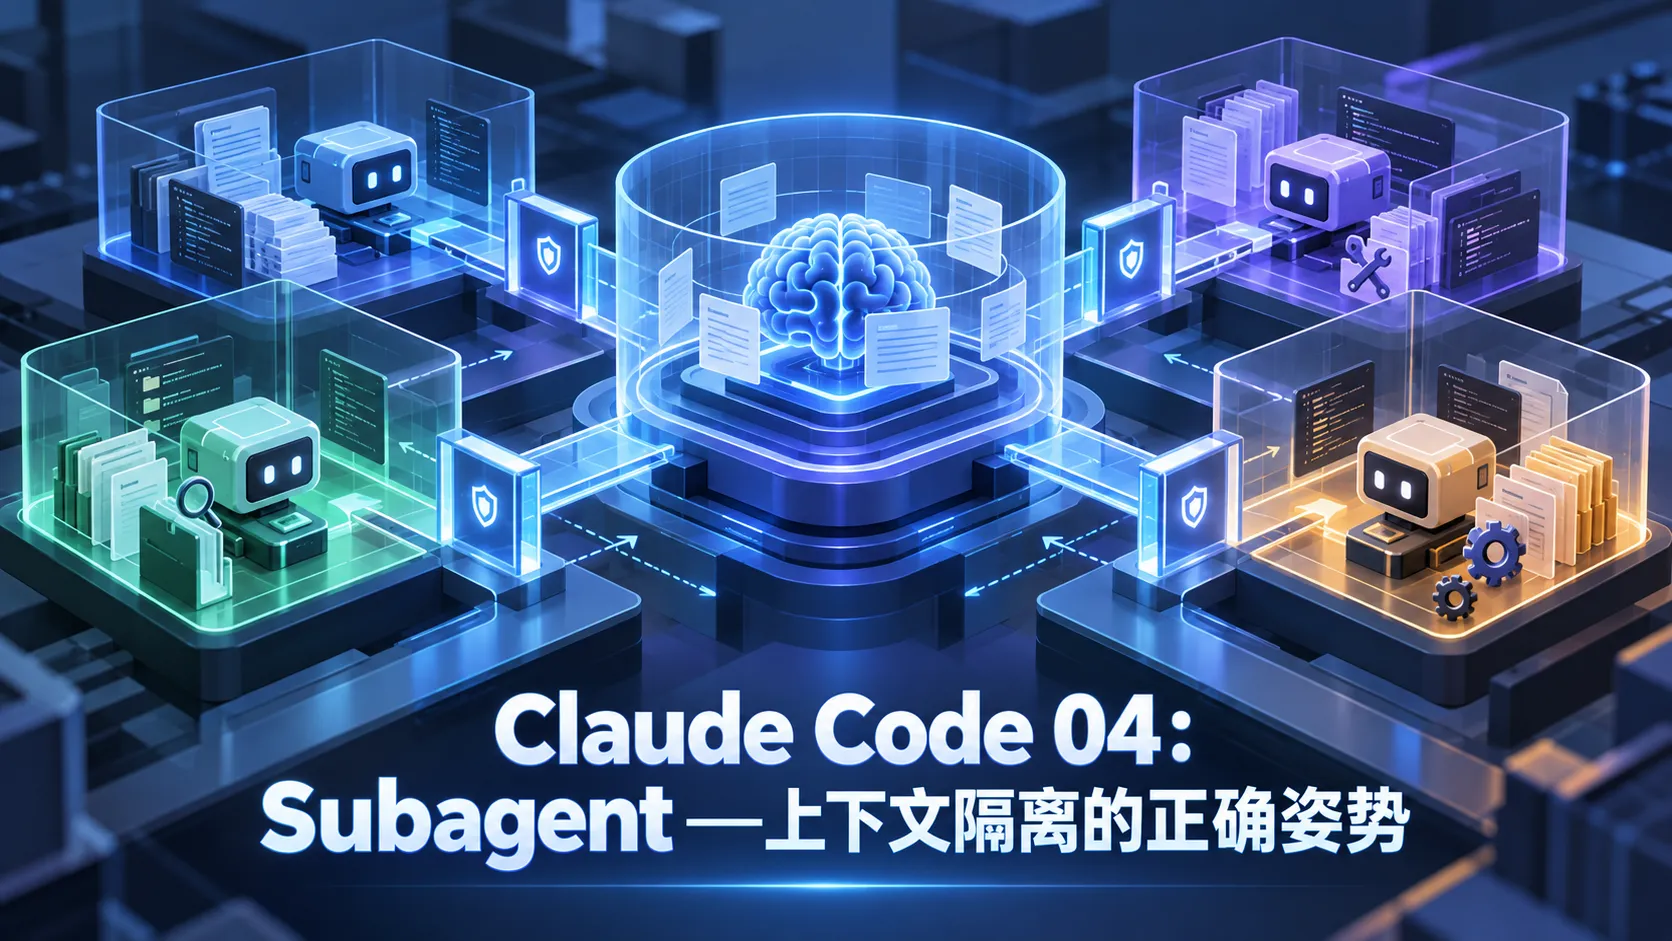
解决这个问题的经典工程模式,就是派生子智能体(Subagent)进行上下文物理隔离。
上下文隔离模式:大任务拆解与结果单向汇聚
子智能体的设计哲学非常明确:给子任务一个纯净的独立上下文,跑完后只向父上下文返回精炼摘要,中间的所有工具探索过程直接丢弃。
  flowchart LR
    A["父 Agent<br>(主上下文保持精炼纯净)"] -->|"派生任务 Prompt"| B["子 Agent<br>(拥有独立空白上下文 messages=[])"]
    B --> C["读取 package.json"]
    B --> D["读取 vite.config.ts"]
    B --> E["分析执行结果"]
    E -->|"仅返回最终结构化结论"| A
子 Agent 在其私有沙箱中即使发起了 30 次工具调用、读了上万行文本,这些海量中间数据在子任务结束时会被整体垃圾回收,父 Agent 只会收到一条轻量的结果反馈。
极简 Python 实现:run_subagent
我们把派生子 Agent 封装为一个标准工具 task_agent:
1 | import anthropic |
将子 Agent 作为工具挂载到主分发字典中:
1 | TOOL_HANDLERS["run_subagent"] = lambda **kw: run_subagent(kw["prompt"]) |
父 Agent 在需要调研大型模块或查阅报错背景时,只需发出一句调用:run_subagent(prompt="深入分析 src/auth 目录下的鉴权流程并给出风险点清单"),主上下文就再也不会被数十次局部文件读取所污染。
生产源码探秘:Claude Code 的 AgentTool
在 Claude Code 真实的工程源码中,子 Agent 绝对不仅仅是一个简单的循环递归,而是一个支持独立模型覆盖、权限降级、后台运行与代码物理隔离的完整编排系统。
AgentTool.tsx 参数契约
1 | // src/tools/AgentTool/AgentTool.tsx(生产源码 Schema 拆解) |
runAgent.ts 的生命周期编排
在 src/tools/AgentTool/runAgent.ts 中,子智能体的初始化流程具备严密的工程防护:
  flowchart TD
    A["runAgent() 入口"] --> B["1. 解析模型覆盖 getAgentModel()"]
    B --> C["2. 分配独立 UUID 与上下文会话"]
    C --> D["3. 构建纯净初始消息栈 (隔离父消息)"]
    D --> E["4. 工具子集裁决 resolveAgentTools()"]
    E --> F["5. 挂载子 Agent 专属的 MCP Server 实例"]
    F --> G["6. 触发 SubagentStart 生命周期钩子"]
    G --> H["7. 运行私有 queryLoop 状态机"]
    H --> I["8. 触发 SubagentEnd 钩子,提取纯文本摘要"]
值得特别关注的是 resolveAgentTools() 工具裁决机制:父 Agent 可以对子 Agent 进行权限降级。例如一个负责探索代码架构的子 Agent,可以被剥夺 FileWriteTool 和 BashTool 的写权限,仅授予只读工具。这种“最小特权原则”有效阻止了不可控的子任务对生产代码造成破坏。
选型思考:什么时候必须派生 Subagent?
在研发实践中,盲目派生子智能体会增加多次 LLM 调用的网络延迟与冷启动开销。我们需要清晰划定边界:
| 评估维度 | 单 Agent 原地执行 | 派生 Subagent 隔离 |
|---|---|---|
| 任务跨度 | 修改当前明确知道行号的单一文件 | 跨越 5 个以上未知文件的全库调研 |
| 中间日志体积 | 输出简短,仅需查看几行返回值 | 跑构建脚本或全量单测,日志成百上千行 |
| 容错敏感度 | 核心主逻辑修改,要求即时反馈 | 试探性实验,失败后允许整体丢弃 |
| Token 预算 | 当前上下文非常充裕 | 上下文已接近压缩阈值,需避免冲击 |
总结
Subagent 是现代 Coding Agent 能够平稳驾驭超大代码库的工程基石:
- 阻断上下文雪崩:将脏活、累活、大文本探索封装在局部子进程中,保障主上下文聚焦最高优先级目标;
- 支持异构模型与权限降级:用轻量级模型跑低风险的调研子任务,实现成本与速度的最优配比;
- 单向结论沉淀:以纯文本摘要作为父子协作契约,规避复杂的跨进程消息死锁。
但是,除了临时生成的探索性上下文,Agent 往往还需要使用特定领域的专有规则(例如团队的特定安全规范或单测约定)。如果把这些静态规则也全部硬编码塞进 Prompt,上下文同样会不堪重负。
下一篇我们将探讨领域知识的按需加载策略:Skill Loading 与 SKILL.md 规范。