OpenClaw 09:Agent 方向面试与实习准备——源码级问答与评测实战
OpenClaw 09:Agent 方向面试与实习准备——源码级问答与评测实战
Asaakii在掌握了 Agent Loop 状态机、MCP 工具协议、ContextEngine 记忆调度和 Git Worktree 隔离之后,如何将这些底层积累转化为在技术面试或实习答辩中的核心竞争力?
随着大模型框架的泛滥,面试官最反感的是只背诵提示词套路、盲目调用外部打包库的“调包侠”。在面试中,能否清晰说出底层的状态转移条件、Token 预算边界、并发踩踏预防与量化评测指标,是拉开候选人差距的关键分水岭。
本文梳理 Agent 技术方向的三层考察矩阵,并提供源码级的回答逻辑与 STAR 表达策略。
Agent 面试的三层考察矩阵
  flowchart TD
    L1["第一层: 概念理解 (筛选层)<br>辨析 Agent 与 Chatbot 的本质,理解不可控的物理根源"]
    L2["第二层: 工程实践 (核心层)<br>掌握 EventStream、并发调度、上下文压缩与 MCP 协议细节"]
    L3["第三层: 系统设计 (高级层)<br>应对万级源码库、权限沙箱、多智能体协同避碰"]

    L1 --> L2 --> L3
第一层:概念理解(筛选层)
1. Agent 与普通 Chatbot 的本质区别是什么?
- 普通回答:“Agent 比 Chatbot 聪明,而且能调用工具。”
- 源码级回答:
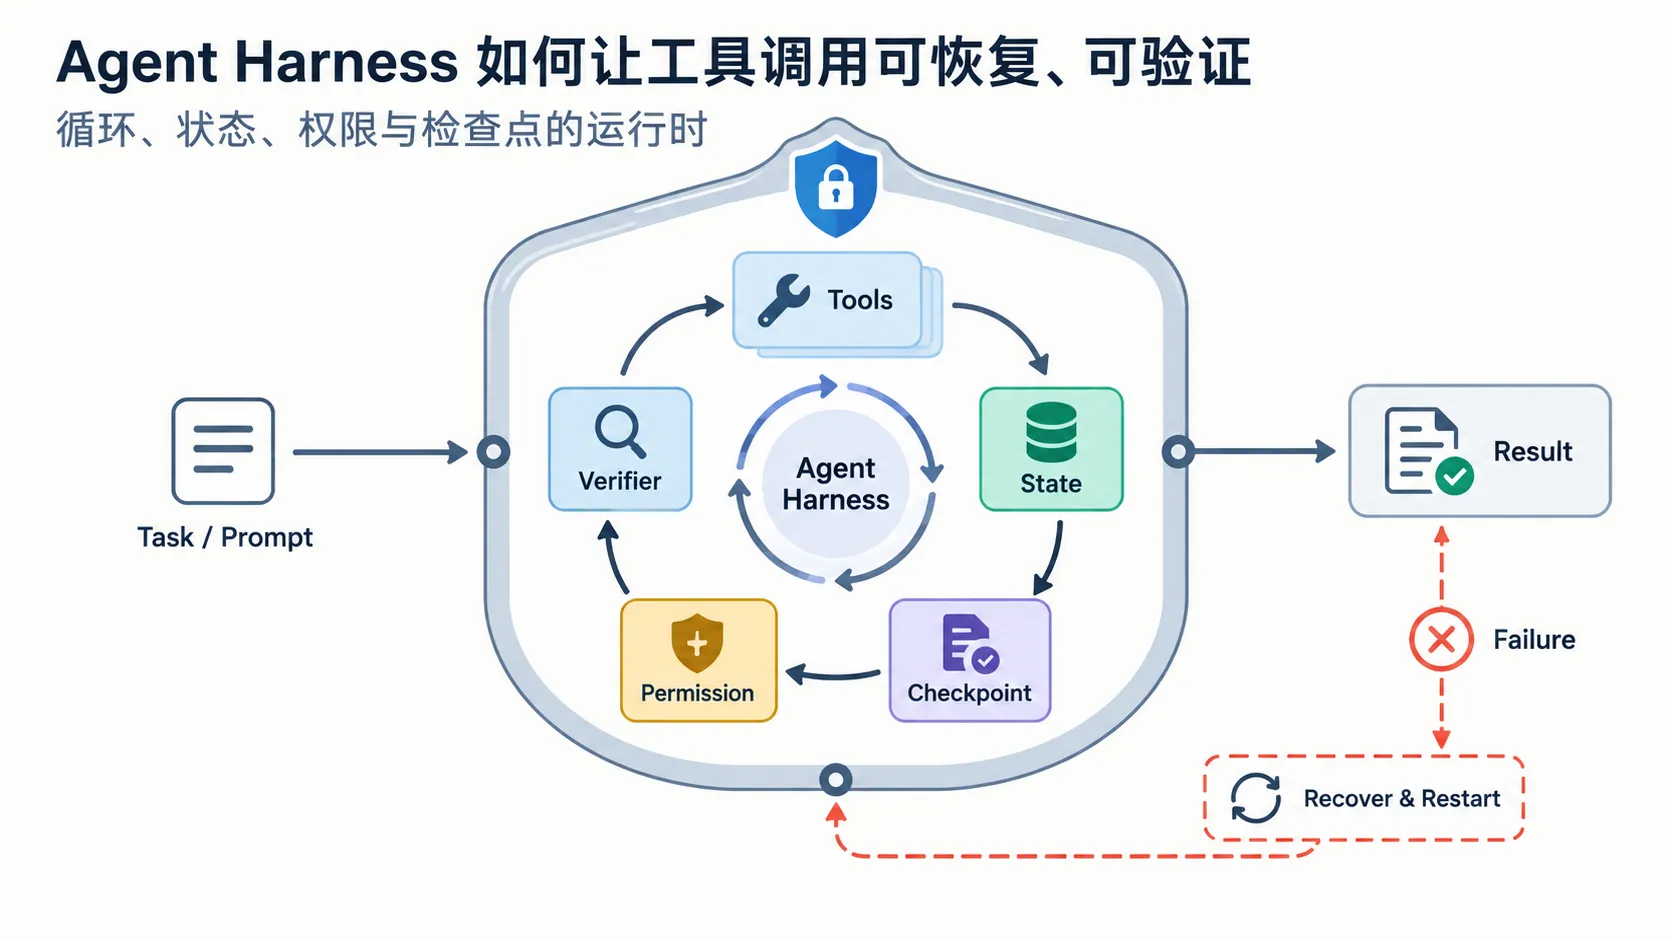
“从运行时的控制流来看,普通 Chatbot 是一次性的输入到输出映射;而 Agent 的核心是一个 双层循环状态机。
它的关键在于内层循环:当 LLM 的响应解析出tool_calls结构体时,系统不会将控制权交还给用户,而是自主调度执行本地或远程工具,并将执行结果打包为tool角色消息再次回传给 LLM。本质是一个受控的while(hasToolCalls)自动闭环。”
2. 为什么实际生产中 Agent 容易出现失控与死循环?
- 普通回答:“因为大语言模型本身存在幻觉。”
- 源码级回答:
“从系统工程角度看,自主 Agent 的本质是一个串行依赖的马尔可夫决策链。步骤 $N$ 的执行结果直接作为步骤 $N+1$ 的输入。
一旦某一步工具返回了报错或超出预期的非结构化文本,若没有精准的容错截断,会导致整个上下文的语义分布发生偏移;随着轮次累加,早期的核心提示词被挤出窗口或被压缩模糊化,造成后续决策依据严重失真,进而诱发连续误判与工具重试死循环。”
第二层:工程实践(核心层)
1. 你的 Agent 核心循环采用了什么执行模型?
参考回答:
“我们采用了基于AsyncGenerator的 EventStream(事件流)模型。agentLoop会向上游依次发射类型化的结构事件(如turn_start、message_update、tool_execution_start、tool_execution_end等)。
这样设计有两个直接收益:
- 解耦运行时与交互终端:CLI 差分终端或 Web 前端只作为流的消费者,逻辑彻底独立;
- 原生背压控制(Backpressure):利用 JavaScript 原生异步迭代机制,当下游网络推送或渲染卡顿时,上层循环自动挂起,防止未消费事件在内存中溢出。”
2. 工具调用是串行还是并行?遇到依赖怎么处理?
参考回答:
“默认采用Promise.all并行执行。因为在 Coding 场景下,单轮通常涉及多个无依赖的 IO 密集任务(例如同时读取三个配置文件的头部信息),并行可以将整轮工具延迟从 $O(n)$ 骤降到 $O(1)$。
当确实存在写后立即读的依赖时,由于模型在生成时是分轮次决策的,优秀的 LLM 通常会在第一轮只发起写入工具,等待写入成功的系统确认返回后,在下一轮循环中再发起读取。”
3. 当上下文接近 Token 限制时,你如何做压缩?
参考回答:
“我们放弃了简单的尾部硬截断,而是设计了带标识符保留规则(Strict Identifier Preservation)的 Compaction 机制。
- 压缩摘要必须原样锁定文件物理路径、精确行号、函数名及关键用户决策;
- 动态组装器
assemble()按照系统指令 > 长期记忆 > 压缩摘要 > 近期活跃消息的严格优先级填充预算;- 压缩前自动执行一次
auto-flush,将已确认的事实验证刷入MEMORY.md,防止上下文压缩导致信息永久蒸发。”
第三层:系统设计(高级层)
场景题:请设计一个能处理包含 10,000 个源文件工程的 Coding Agent
面对超大规模代码库,绝不能把所有代码一次性打包喂给模型。系统设计必须围绕按需获取与沙盒隔离展开:
  flowchart LR
    A["文件发现<br>(ripgrep / Glob)"] --> B["精确切片<br>(Read offset/limit)"]
    B --> C["语义感知<br>(AST / 混合检索)"]
    C --> D["并发修改<br>(Git Worktree 隔离)"]
    D --> E["增量验证<br>(局部单测)"]
- 宏观探索:禁止遍历全盘,通过
grep检索符号和find匹配文件树; - 微观读取:文件读取工具强制携带
offset与limit,先读前 50 行类结构,再精准跳转读函数体; - 并发修改:当需要多模块重构时,通过 Git Worktree 为每个子 Agent 派生独立的临时工作目录与分支,彻底避免文件写入冲突;
- 验证门禁:改动完成后只执行与变更文件强绑定的单测,而不是全局全量构建。
表达框架:用 STAR 法则量化你的项目成果
在简历与面试中,描述个人 Agent 项目切忌泛泛罗列功能,要重点展示技术权衡与量化数据:
1 | [S] 情境 (Situation): |
面试准备自查清单
在走向考场前,确保你能够对以下问题做到脱口而出且有据可查:
- 能在白板或草稿纸上画出 Agent Loop 的状态流转图,标明跳出内循环的终止判定;
- 能清晰解释为什么文件读写必须带
offset/limit,并说出输出截断的头尾保留方案; - 能说出为什么优先选择
MEMORY.md作为长期记忆载体,而不是直接上向量数据库; - 能准确描述 MCP 协议中的 JSON-RPC 消息格式(
tools/list与tools/call); - 拥有至少一套自己的真实 Eval 评测用例和量化通过率数据;
- 清楚知道单 Agent 与 Multi-Agent 的适用边界,不为了炫技而过度设计。
专栏完结寄语
到这里,《OpenClaw Agent 核心与实战》 系列的 10 篇文章已经全部完结。
从最开始探讨“为什么要自己手写 Agent”,到 EventStream 核心双循环、RAG 混合检索、MCP 工具生态、ContextEngine 记忆系统、Git Worktree 隔离,再到深入 Pi 的 monorepo 源码并亲手组装属于你的 [YourName]Claw。
大模型技术的浪潮日新月异,上层的 API 可能会不断变更,但系统工程中关于状态机、上下文预算、并发安全与模块解耦的底层思考永远通用。希望这个系列能成为你在 Agent 架构之路上坚实可靠的工程底座!