本文是「LangGraph 核心与实战」系列专栏的第 5 篇。专栏总览参见:《LangGraph 核心架构全景:用状态图构建可控 Agent 工作流》。
在顺序图与基础条件分支中,节点的执行在时序上是完全串行的:步骤 A 跑完才启动步骤 B。然而在许多现实业务中,任务包含多个彼此没有数据依赖的独立子环节:
- 分析某份技术方案时,需要同时进行技术可行性评估、合规安全审查与云资源成本估算;
- 调研竞争对手时,需要并发检索 3 个不同的数据源并分别提炼指标;
- 多模态处理时,音频转写、图片 OCR 与文本实体抽取可以同时启动。
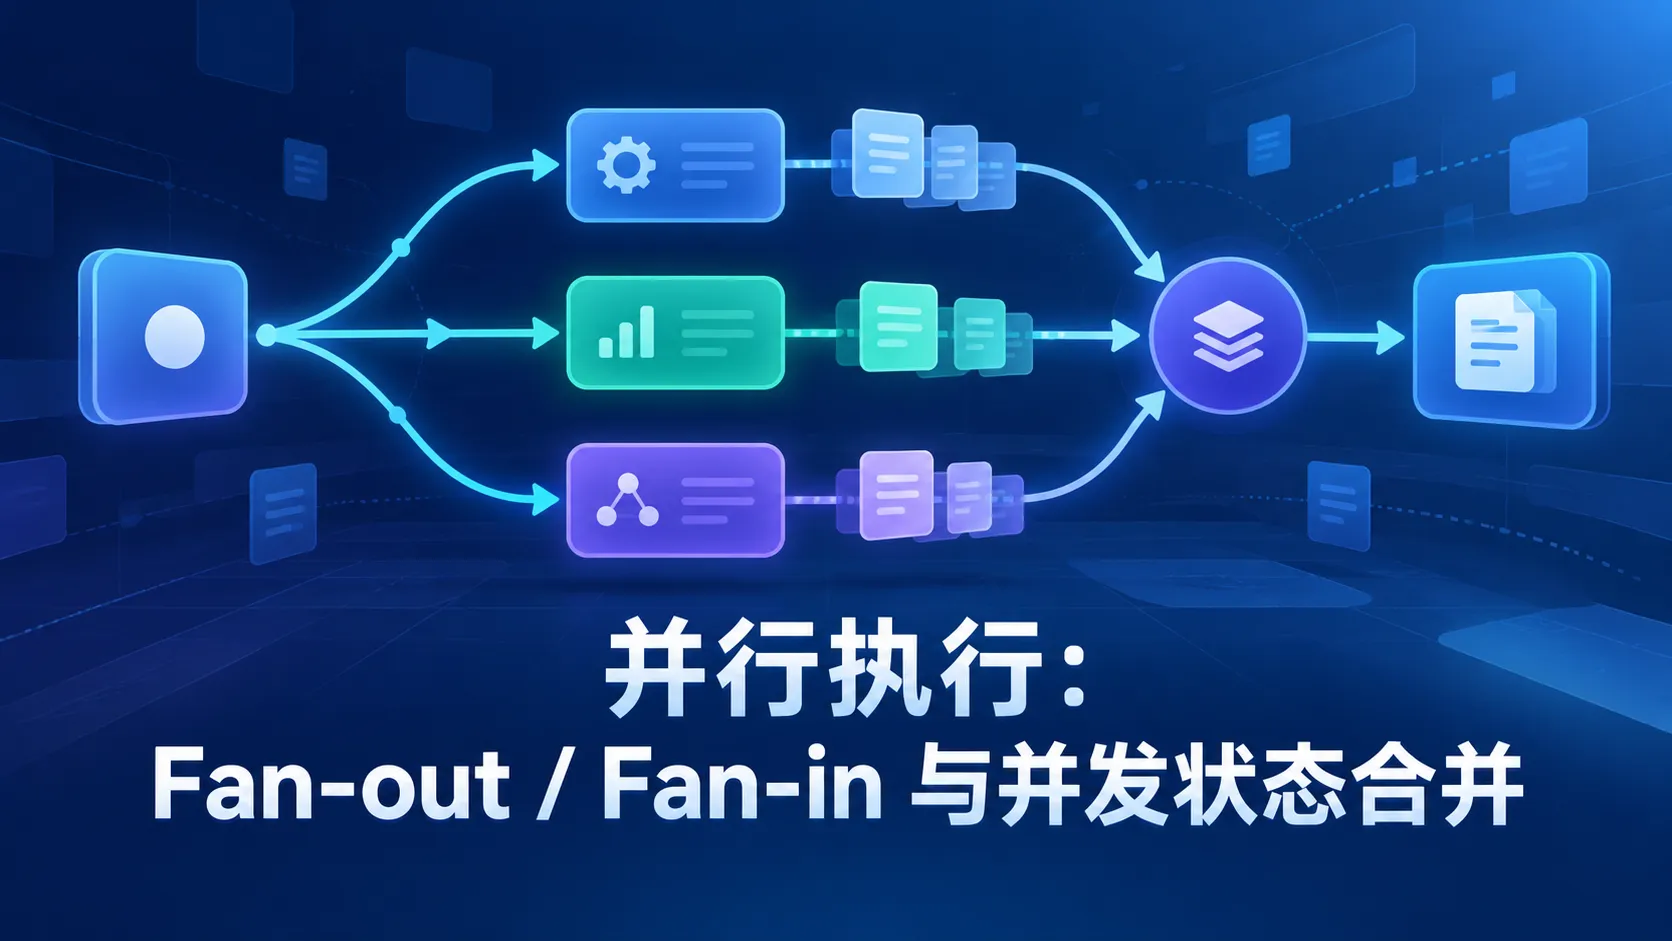
如果依然使用串行流水线,端到端延迟将是各个子任务耗时的累加( )。通过构建 Fan-out(扇出并发)与 Fan-in(扇入聚合)拓扑,任务耗时可以大幅降低至最慢单节点的耗时( )。
拓扑设计:Fan-out / Fan-in 模式
在状态图中表达并行执行非常直观:从同一个源节点同时引出多条普通边指向不同目标,并在后续让它们共同汇聚到一个聚合节点:
  flowchart TD
    StartNode["准备输入节点 (prepare)"] -->|"Fan-out 扇出并发"| NodeA["专业评估 A (维度: 架构)"]
    StartNode -->|"Fan-out 扇出并发"| NodeB["专业评估 B (维度: 安全)"]
    StartNode -->|"Fan-out 扇出并发"| NodeC["专业评估 C (维度: 成本)"]

    NodeA -->|"Fan-in 扇入汇聚"| AggNode["决策仲裁节点 (aggregate)"]
    NodeB -->|"Fan-in 扇入汇聚"| AggNode
    NodeC -->|"Fan-in 扇入汇聚"| AggNode

    AggNode --> EndNode([END 终态])
在代码声明层面,只需要添加对应的边:
1
2
3
4
5
6
7
8
9
|
builder.add_edge("prepare", "eval_arch")
builder.add_edge("prepare", "eval_security")
builder.add_edge("prepare", "eval_cost")
builder.add_edge("eval_arch", "aggregate")
builder.add_edge("eval_security", "aggregate")
builder.add_edge("eval_cost", "aggregate")
|
LangGraph 运行时提供了关键的执行保证:汇聚节点 aggregate 只有在所有上游并发节点(eval_arch、eval_security、eval_cost)全部执行完成并成功更新状态后,才会被调度触发。
核心并发陷阱:写冲突(Race Condition)与 Reducer
在并行执行中,必须警惕状态更新的竞态冲突。
为什么默认字典合并会丢失数据
回顾前两篇提到的状态合并规则:LangGraph 默认采用浅层字段覆写。
假设状态中定义了普通字典或普通列表字段:
1
2
| class UnsafeState(TypedDict):
evaluations: list
|
当 eval_arch 与 eval_security 并发执行时:
eval_arch 完成,向状态提交 {"evaluations": [{"type": "arch", "score": 90}]};eval_security 几乎在同一时刻完成,向状态提交 {"evaluations": [{"type": "security", "score": 85}]};- 由于两个节点在各自的执行副本中拿到的是旧 State,且字段策略是直接覆盖,后完成的节点会直接覆盖先完成节点的数据,导致先完成的评估结果彻底蒸发!
解决方案:使用 Annotated + operator.add
为了让并发节点能够安全地向同一容器追加数据,必须通过 operator.add 为该字段声明归约合并器(Reducer):
1
2
3
4
5
6
7
8
| from typing import Annotated, List, TypedDict, Dict, Any
import operator
class SafeState(TypedDict):
target_name: str
eval_reports: Annotated[List[Dict[str, Any]], operator.add]
final_decision: str
|
有了 Annotated[..., operator.add],LangGraph 在运行时会接收所有并发节点的增量返回值,按内部线程同步机制安全执行追加操作,汇聚节点 aggregate 最终看到的将是包含所有并发结果的完整列表。
实战:三维度方案综合评审工作流
实现一个包含准备、并发三路审查与终审决策的完整可运行示例:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
| import operator
from typing import TypedDict, Annotated, List, Dict, Any
from langgraph.graph import StateGraph, START, END
class ProposalReviewState(TypedDict):
proposal_title: str
proposal_content: str
dimension_reports: Annotated[List[Dict[str, Any]], operator.add]
total_score: float
approval_status: str
def prepare_proposal_node(state: ProposalReviewState) -> dict:
print(f"\n[工位 1] 收到方案: 《{state['proposal_title']}》,准备派发评审任务...")
return {}
def architecture_review_node(state: ProposalReviewState) -> dict:
content = state["proposal_content"]
print(" -> [并发审查] 架构评审节点启动...")
score = 90.0 if "高可用" in content else 70.0
return {
"dimension_reports": [{
"dimension": "架构设计",
"score": score,
"comment": "满足分布式容灾标准" if score >= 80 else "缺少容灾备份机制"
}]
}
def security_review_node(state: ProposalReviewState) -> dict:
content = state["proposal_content"]
print(" -> [并发审查] 安全合规节点启动...")
score = 85.0 if "鉴权" in content else 60.0
return {
"dimension_reports": [{
"dimension": "安全合规",
"score": score,
"comment": "数据敏感字段已配置加密" if score >= 80 else "未发现权限校验设计"
}]
}
def cost_review_node(state: ProposalReviewState) -> dict:
content = state["proposal_content"]
print(" -> [并发审查] 成本核算节点启动...")
score = 80.0
return {
"dimension_reports": [{
"dimension": "资源成本",
"score": score,
"comment": "云资源预算在年度配额限制内"
}]
}
def aggregate_decision_node(state: ProposalReviewState) -> dict:
reports = state["dimension_reports"]
print(f"\n[工位 3] 收到全部 {len(reports)} 个维度的并发报告,开始裁决...")
avg_score = sum(r["score"] for r in reports) / len(reports)
status = "APPROVED" if avg_score >= 80.0 else "REJECTED"
return {
"total_score": round(avg_score, 1),
"approval_status": status
}
builder = StateGraph(ProposalReviewState)
builder.add_node("prepare", prepare_proposal_node)
builder.add_node("eval_arch", architecture_review_node)
builder.add_node("eval_security", security_review_node)
builder.add_node("eval_cost", cost_review_node)
builder.add_node("aggregate", aggregate_decision_node)
builder.add_edge(START, "prepare")
builder.add_edge("prepare", "eval_arch")
builder.add_edge("prepare", "eval_security")
builder.add_edge("prepare", "eval_cost")
builder.add_edge("eval_arch", "aggregate")
builder.add_edge("eval_security", "aggregate")
builder.add_edge("eval_cost", "aggregate")
builder.add_edge("aggregate", END)
app = builder.compile()
if __name__ == "__main__":
proposal = {
"proposal_title": "核心交易链路改造方案",
"proposal_content": "本系统基于云原生多可用区部署,具备高可用容灾能力,并配置细粒度接口鉴权与日志审计。"
}
result = app.invoke(proposal)
print("\n================ 评审交付报告 ================")
print(f"方案: {result['proposal_title']}")
print(f"综合评分: {result['total_score']} | 最终决策: {result['approval_status']}")
print("各维度明细:")
for r in result["dimension_reports"]:
print(f" * [{r['dimension']}] 得分: {r['score']} -> 评价: {r['comment']}")
print("==============================================")
|
输出日志:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
| [工位 1] 收到方案: 《核心交易链路改造方案》,准备派发评审任务...
-> [并发审查] 架构评审节点启动...
-> [并发审查] 安全合规节点启动...
-> [并发审查] 成本核算节点启动...
[工位 3] 收到全部 3 个维度的并发报告,开始裁决...
================ 评审交付报告 ================
方案: 核心交易链路改造方案
综合评分: 85.0 | 最终决策: APPROVED
各维度明细:
* [架构设计] 得分: 90.0 -> 评价: 满足分布式容灾标准
* [安全合规] 得分: 85.0 -> 评价: 数据敏感字段已配置加密
* [资源成本] 得分: 80.0 -> 评价: 云资源预算在年度配额限制内
==============================================
|
生产级约束:并行执行的注意事项
在生产环境中编排高并发工作流时,需遵守以下三条工程准则:
- 防止下游大模型 API 触发限流(Rate Limit 429):如果在一个 Fan-out 拓扑中同时扇出 20 个调用大模型的子节点,瞬时并发很可能直接打满服务商的 TPM / RPM 配额。建议结合信号量(
asyncio.Semaphore)限制并发上限,或使用队列解耦;
- 节点间严禁隐式数据依赖:位于同一扇出层级的并发节点之间在运行时是互不可见的。如果节点 B 的计算依赖节点 A 的输出,两者必须设计为串行先后关系,绝不能放在同一个并行层级;
- 复合拓扑应用:Fan-in 汇聚节点产出数据后,完全可以无缝衔接上一篇所讲的条件边(例如:若综合评分低于 80 分,则通过条件边路由给退回修改节点,否则直接交付)。
系列导航与参考