在自主 Coding Agent 的运行过程中,权限裁决是一个避不开的核心命题:当模型意图修改文件、执行系统命令或发起网络请求时,由谁来做出“允许”还是“拒绝”的决策?
不同框架给出的技术路线截然不同:
Claude Code 采用动态应用层检查:规则以内置交互为主,运行时通过终端 Prompt ...
在探讨 Codex CLI 之前,必须先厘清它的历史分界:2021 年发布的 Codex 是一个代码补全模型(早期的 Copilot 底层引擎),通过补全单行或代码块提供辅助。而 2025 年 5 月在 GitHub 开源的 openai/codex,则是一个完整的面向终端的自主 Codi ...
很多人听到“Codex”,第一反应还是 2021 年那个基于 GPT-3.5 的代码补全 API。但进入 2025 年之后,OpenAI 在 GitHub 开源的 openai/codex 已经演化为一个完整的终端 Coding Agent。它具备自主的 Agent Loop、系统级工具调 ...
在真实的软件工程长程任务中,“把对话保存到文件”是非常初级的操作。真正决定一个 Agent 工业级可用性的,是它能否在经历长时间中断、程序崩溃或方案推翻重来后,恢复到一个依然能够清醒推进工作的稳健状态:
用户的初始目标有没有被丢弃?
已经发生的关键文件修改和失败的单元测试事实有没有保留?
用户回到 ...
在探讨 Coding Agent 的工程化选型时,很多团队经常陷入一种误区:找几个开源框架,跑一次官方自带的“用 Python 写一个贪吃蛇” Demo,看谁写得快就草率得出“框架 A 完胜框架 B”的结论。
然而,在面对长达数周的复杂长程任务、多团队协同规范、金融级安全审计以及多端内嵌诉求时,表面 ...
Pi 把很多高级产品能力(如代码门禁、多模型管理、复杂 MCP 桥接等)刻意留给了 Extension 与 Package。这种极简内核的哲学赋予了开发者无限的定制自由,但也同时提出了一个极为尖锐的工程挑战:
“能在市场上搜到”、“下载量破万”、“GitHub Star 很多”,完全不能证明这个扩展 ...
在将 Coding Agent 引入企业团队或本地核心开发机时,很多开发者容易产生两种危险的幻觉:
幻觉一:以为大模型在终端里信誓旦旦地声明“我绝不会修改敏感文件”,系统就是安全的;
幻觉二:以为在进入项目时点了一下“信任该仓库(Project Trust)”,系统就自动拥有了沙箱保护。
在真实 ...
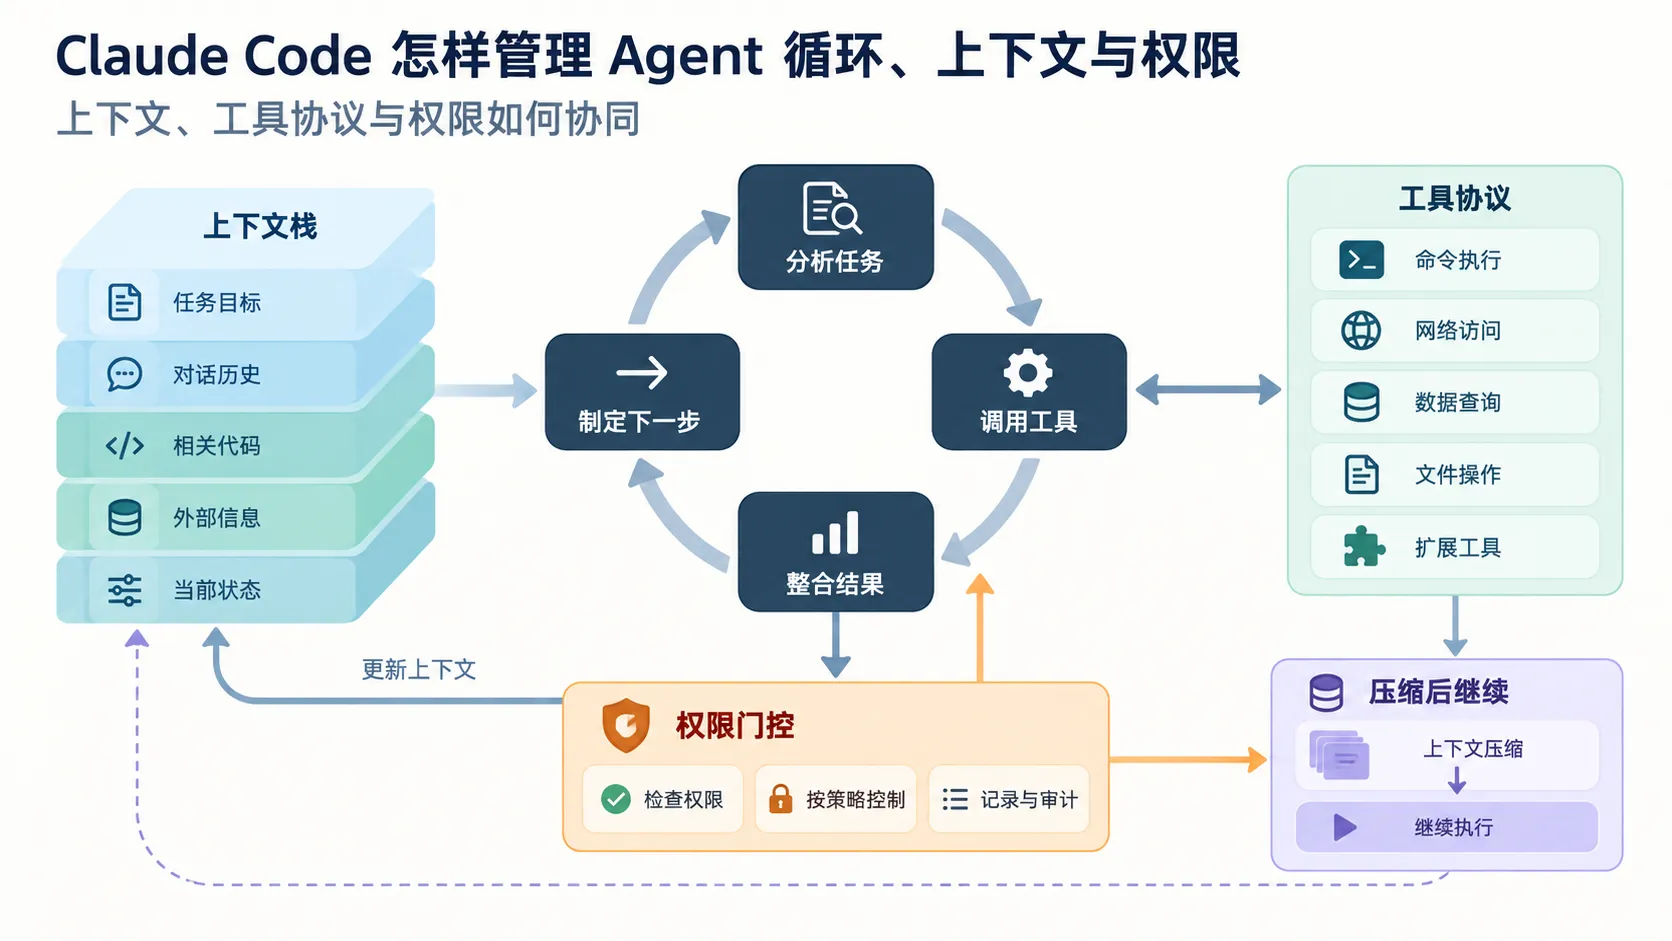
假设项目里有一个登录 Bug:用户输入正确密码后仍然被重定向到登录页。你把这句话丢给 Claude Code,它要做的并不只是“生成一段修复代码”。它得先读项目结构和认证逻辑,必要时申请权限,运行测试和命令,改文件,再根据新的报错判断下一步,然后把这一切重复若干轮,直到它认为修好了。
这篇文章想做一 ...

