2025 年初,OpenAI Deep Research 与 Perplexity Deep Research 的发布引发了业界广泛关注:面对一个宏大而复杂的问题,AI 不再仅仅依赖单次模型推理给出简短答案,而是能够像一位资深行业分析师一样,自主规划数十个研究子方向,进行多轮网络检索、阅读上百篇网页 ...
在一般性的消费级 AI 场景中,智能体偶尔产生轻微幻觉或者忽略某个细节,用户往往可以一笑置之。但在金融、证券、风控与合规审查等企业核心领域,一次事实错误或逻辑遗漏就可能导致严重的决策失误与资产损失。单智能体面对复杂的长篇研报撰写或产业链尽职调查时,极易陷入上下文过载或推理退化。
AgentUnive ...
在 AI 智能体开发的世界里,我们经常会遇到这样的困境:为了让大模型调用一两个简单的天气查询或数据库接口,不得不引入庞大的第三方框架。随之而来的是深达数十层的堆栈调用、晦涩难懂的中间件类继承、黑盒一般的内部提示词注入,以及版本升级带来的 API 破裂。
其实,所有第三方 Agent 框架的本质,都是 ...
在 AI 应用和 Agent 的开发世界里,Python 毫无疑问占据了学术界与开源实验的主流。但在工业界的大规模后端生产环境中,Python 的几个固有弱点常常成为性能瓶颈:GIL(全局解释器锁)限制了高并发吞吐、动态类型系统在大规模团队协作中隐藏了运行时类型异常风险、庞大且复杂的虚拟环境和外部 ...
在 AI 原生应用开发的浪潮中,大多数开源框架(如早期的 LangChain)主要由 Python 极客社区主导,设计风格偏向动态黑盒与快速原型实验。但在传统政企和跨国公司的大型系统里,主力工程栈往往是 C#(.NET)和 Java,严苛的静态类型检查、依赖注入(DI)设计模式、严格的代码可维护性与 ...
在很长一段时间里,构建 AI Agent 几乎是 Python 生态的专属领地。然而在真实的业务开发中,大量互联网团队的业务主干、前端界面与微服务中台都是基于 Node.js 与 TypeScript 构建的。如果为了引入几个智能体功能而专门架设一套 Python 微服务,团队往往要背负跨语言维护、 ...
在多智能体(Multi-Agent)系统的早期探索中,大多数开源框架都倾向于采用“单进程全局状态共享”的模式:所有 Agent 跑在一个 Python 解释器内,通过读取同一个全局列表或字典来同步对话。这种模式在几轮本地对话实验中非常直观,但一旦引入需要独占 GPU 的本地大模型、或者 Agent ...
随着大语言模型应用从简单的单轮 Prompt 走向复杂的多步骤自主任务,开源社区和头部大厂相继推出了五花八门的 Agent 开发框架。很多开发者常常感到困惑:为什么有的框架基于消息流,有的框架基于状态图;为什么有人坚持用 Python,而字节跳动要推出 Go 语言的 Eino,前端生态又在极力推广 ...
前面的章节中,为了理清图拓扑、状态流动和分支机制,我们多次用简单的字符串拼接或占位函数模拟了 LLM 的返回结果。在真实的 Agent 系统中,节点的核心工作通常就是与模型交互。
在 LangGraph 中接入模型并不神秘:节点本身就是一个普通的 Python 函数,任何可以通过 Python SD ...
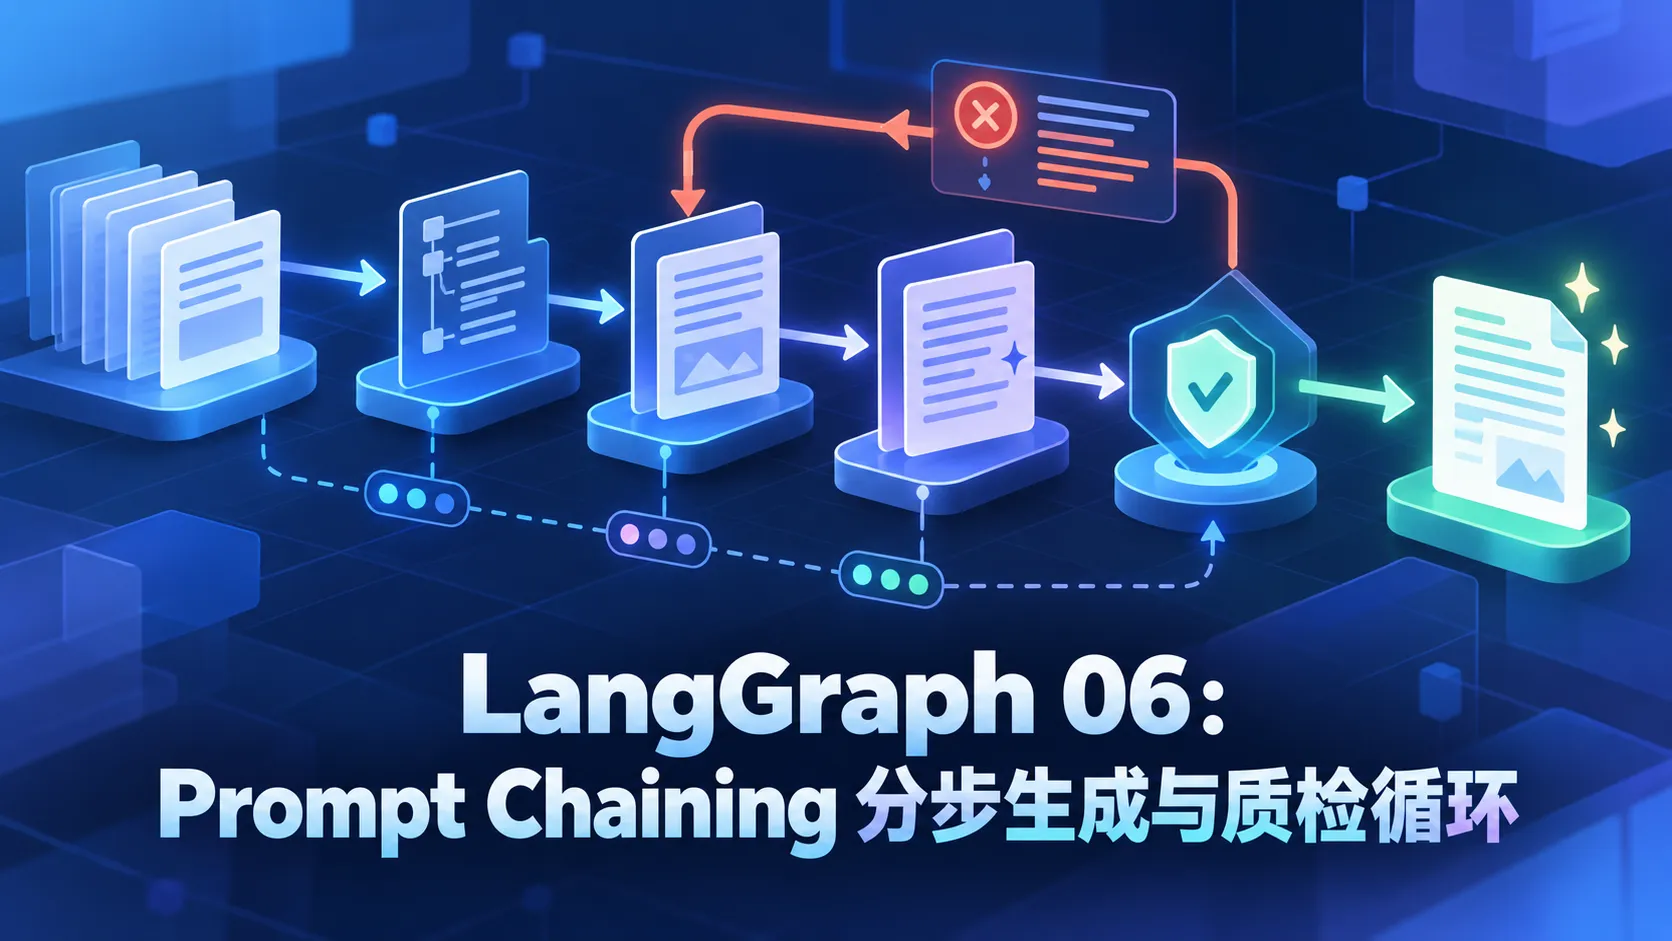
让大语言模型一次性写出一篇结构完整、事实准确、语言流畅的万字技术文章或深度报告,现实中往往容易翻车:模型写到中途容易遗漏关键论点、上下文注意力分散,或者各段落风格割裂。一旦生成质量不合格,唯一的补救手段就是全盘重跑,不仅成本翻倍,而且很难定位到底是哪一段出了偏差。
工程上更靠谱的做法是 Prompt ...

